Slide 1: Preface
2025년 4월 1일 YBIGTA DS Session에서 발표한 Transformer 자료입니다. Attention의 직관부터 계산 과정, Transformer의 Encoder–Decoder 구조, BERT의 문맥 표현과 활용까지 순서대로 살펴봅니다.
Slide 2: What is Attention?
Attention은 현재 처리하는 정보와 관련성이 높은 입력에 더 큰 가중치를 주어 정보를 모으는 연산입니다. 먼저 Query, Key, Value의 역할을 직관적으로 이해합니다.
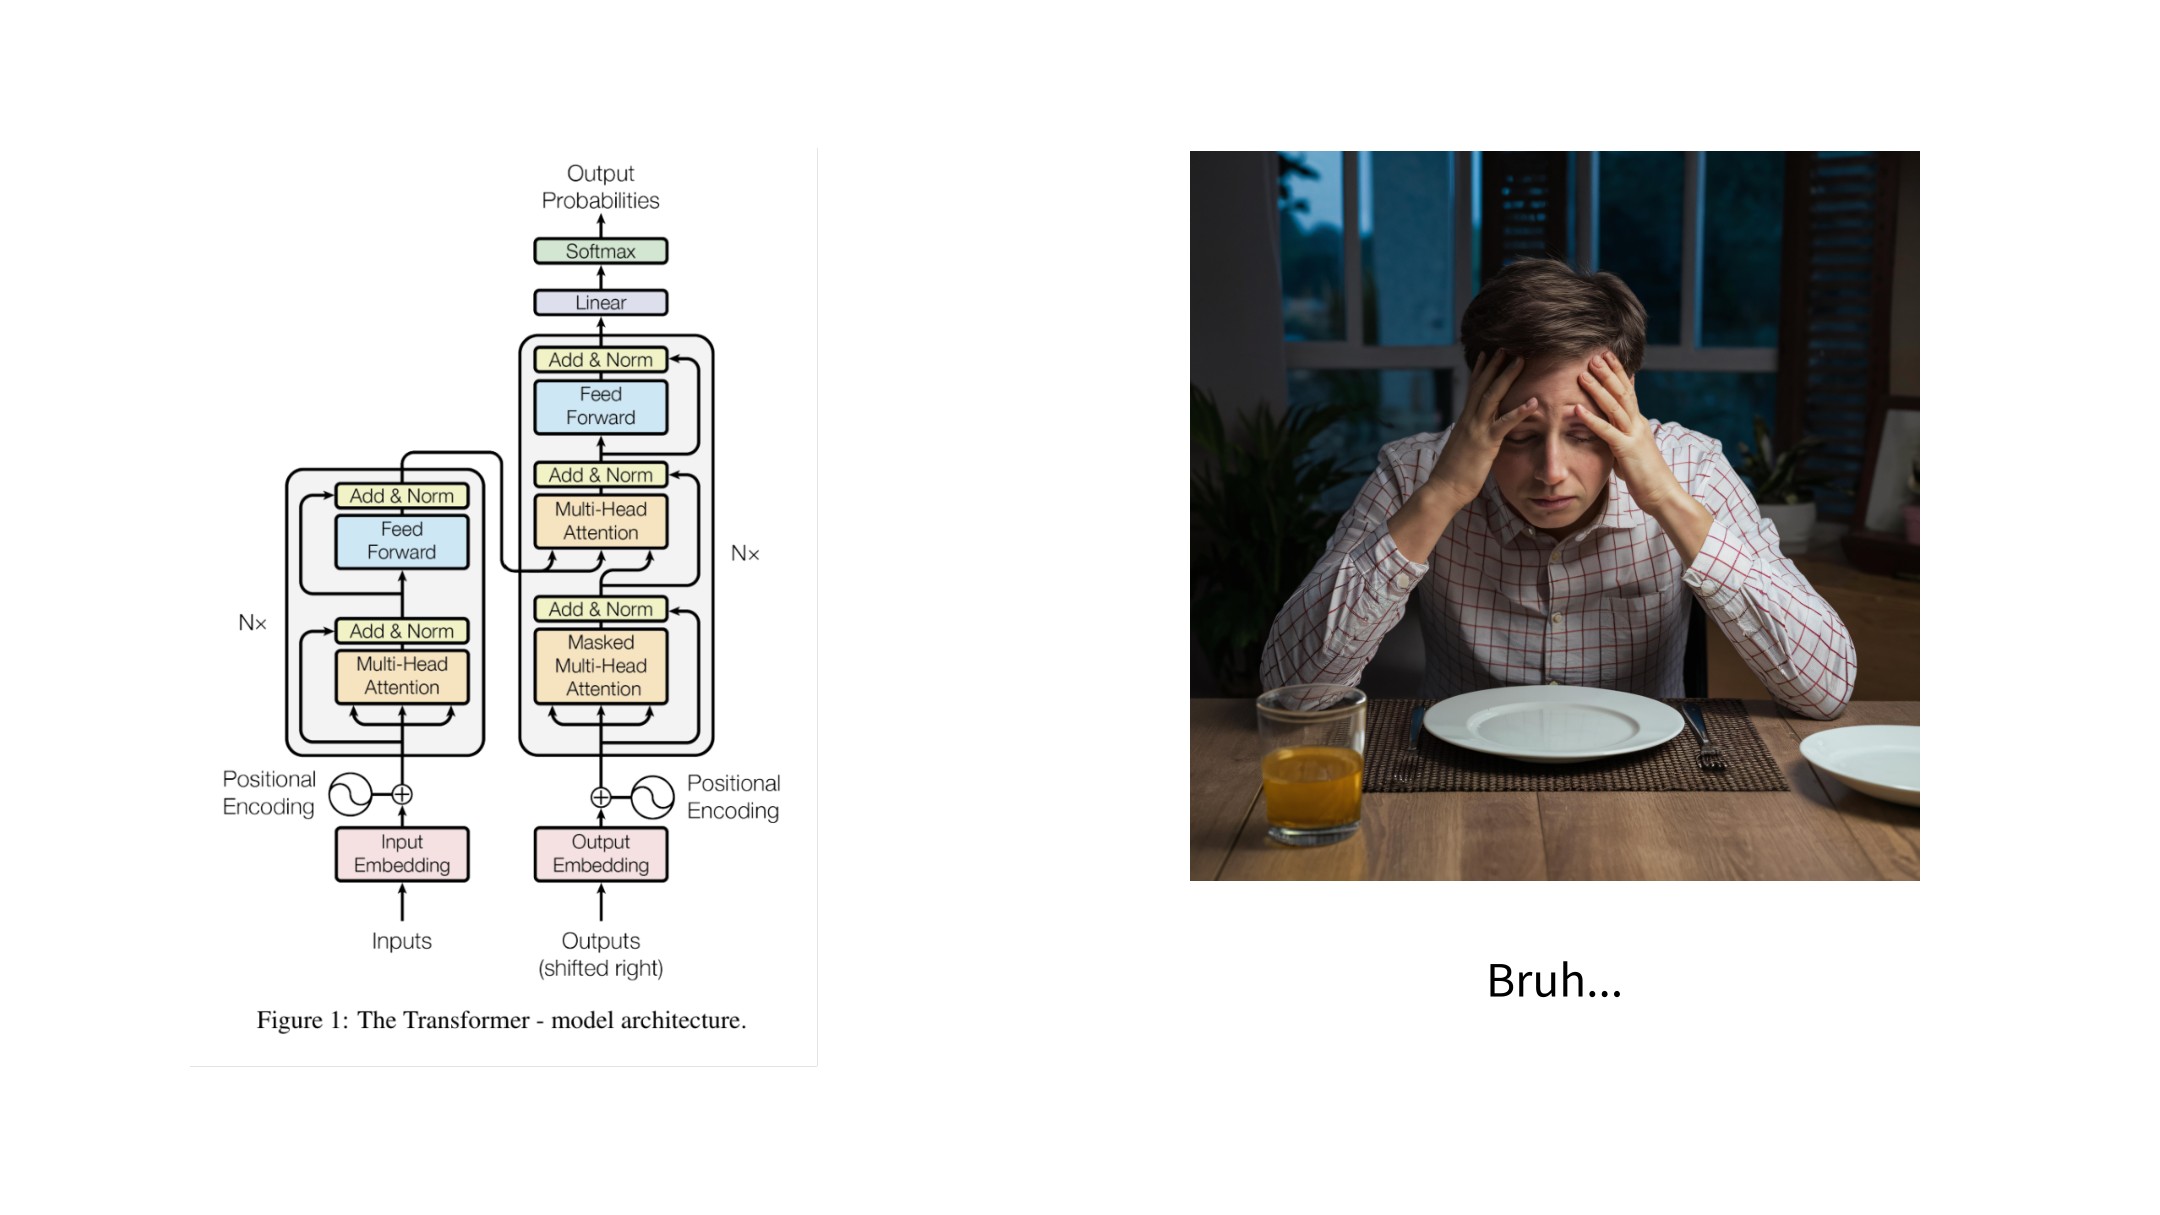
Slide 3: Transformer 전체 구조
전체 구조를 한 번에 외우기보다 Embedding, Positional Encoding, Attention, 잔차 연결을 나누어 살펴봅니다. 이후 각 구성 요소가 Encoder와 Decoder 안에서 어떻게 연결되는지 확인합니다.
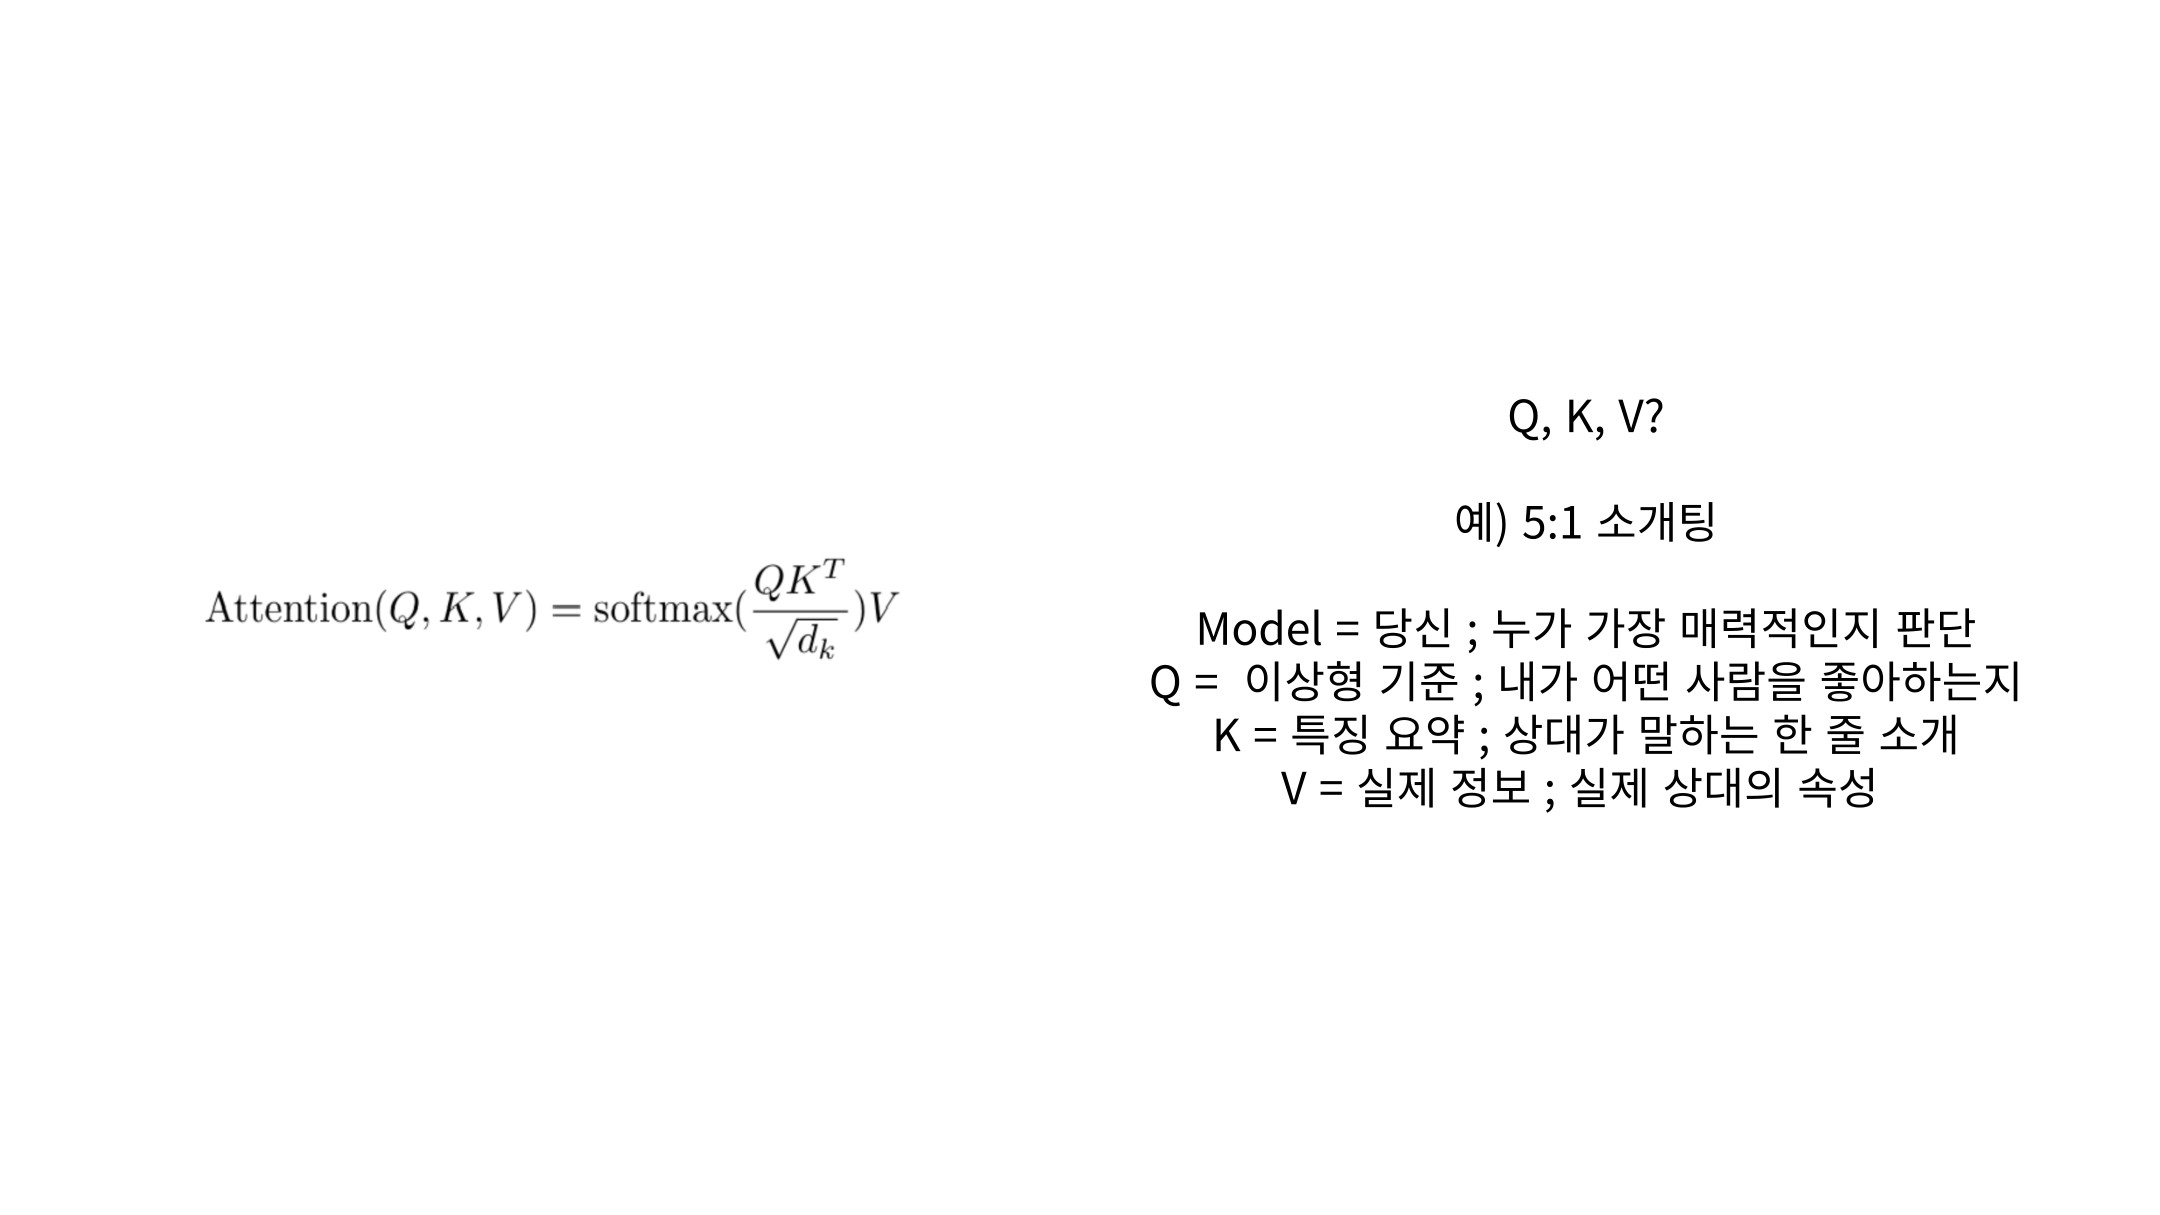
Slide 4: Query, Key, Value
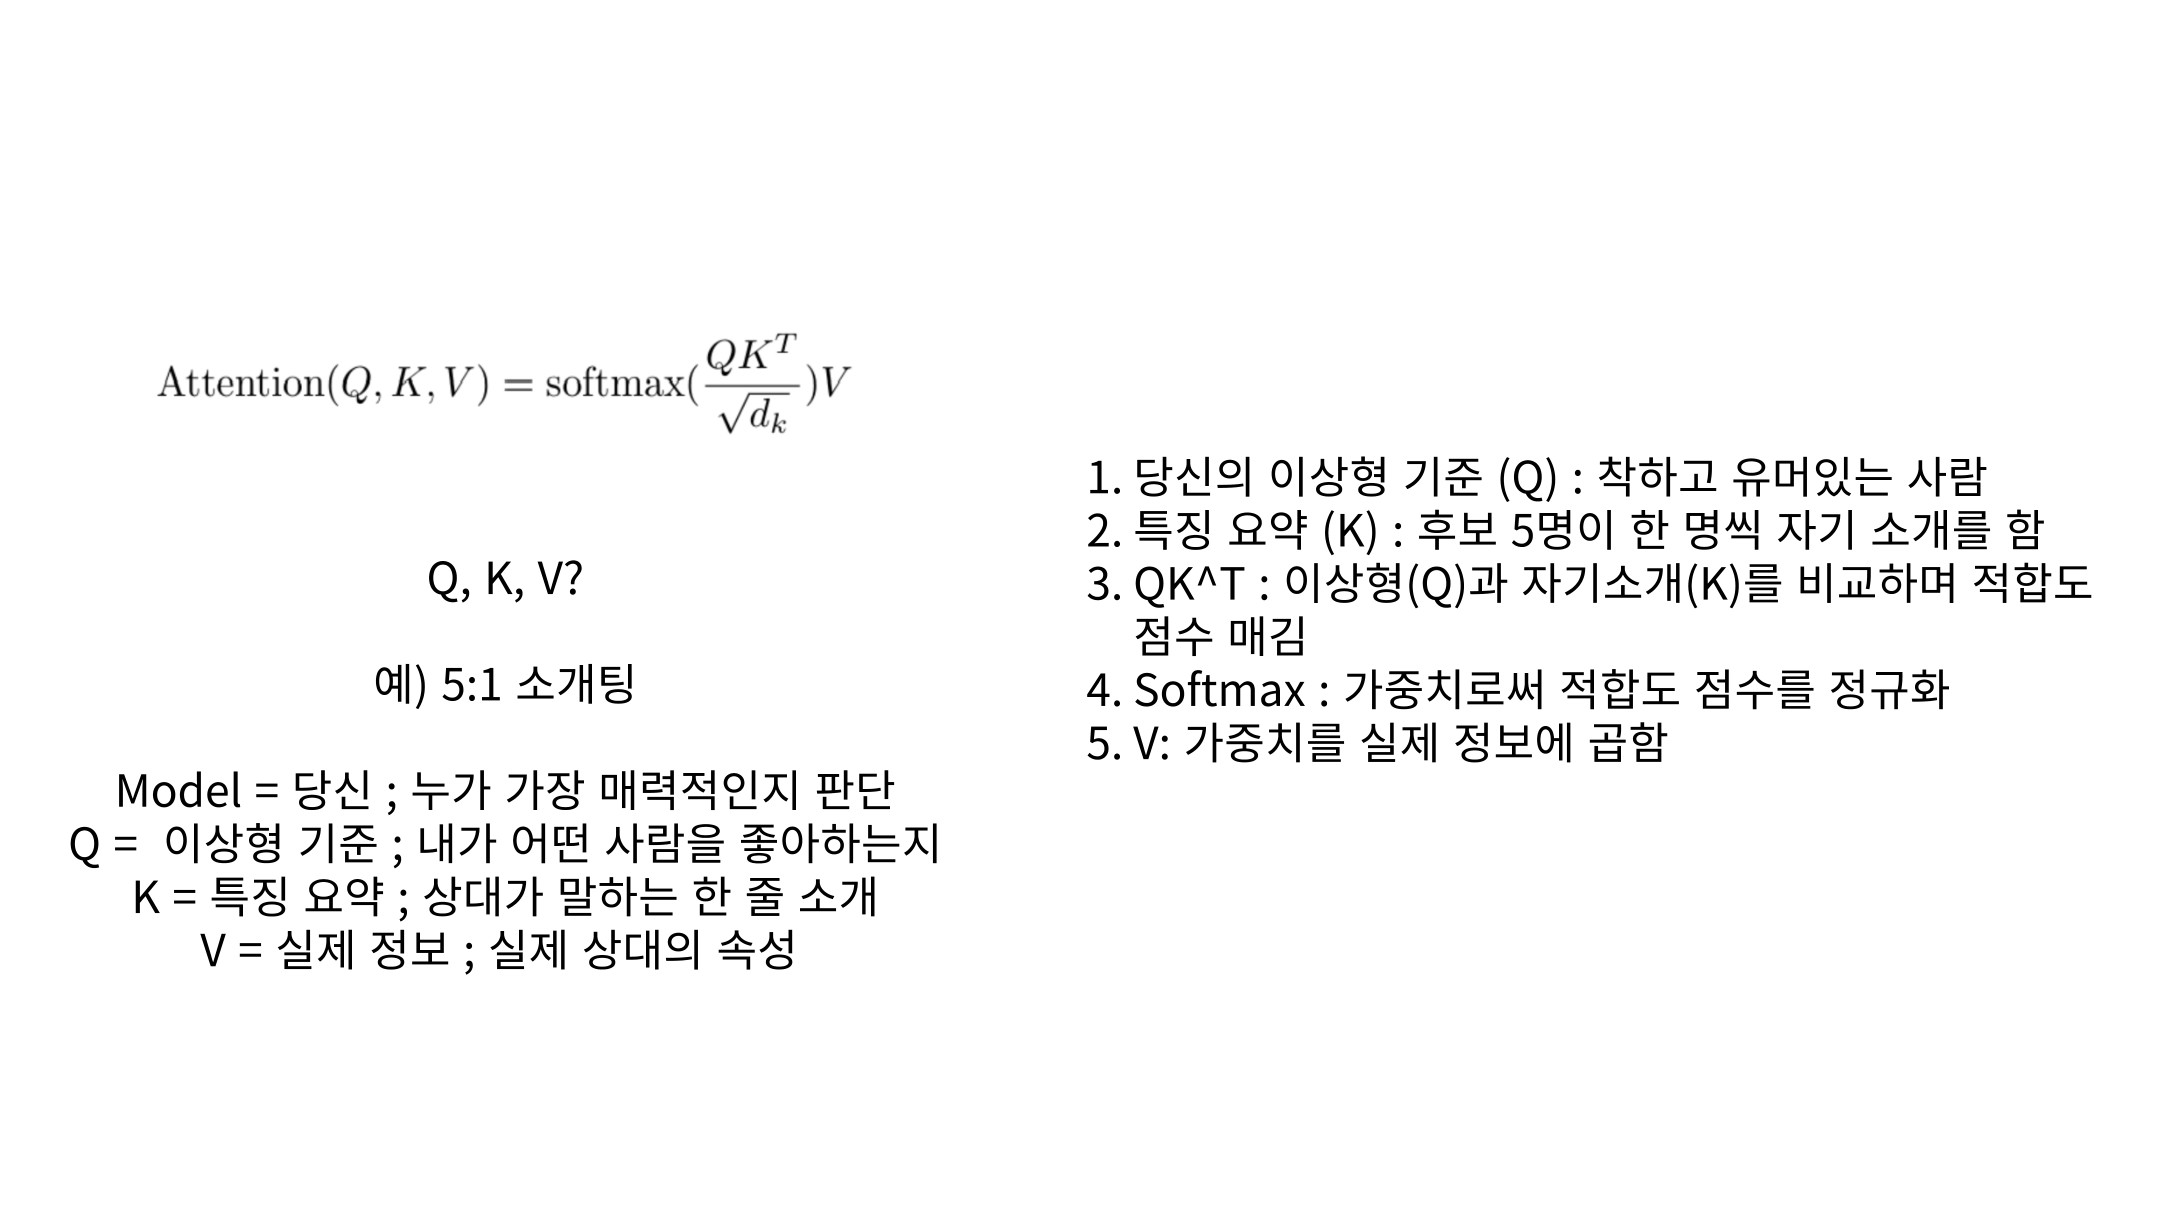
**Query(Q)**는 무엇을 찾는지, **Key(K)**는 각 후보를 비교할 특징, **Value(V)**는 실제로 가져올 정보입니다. 소개팅 비유에서 이상형의 기준은 Query, 상대의 소개는 Key, 실제로 종합할 특성은 Value에 해당합니다.
Slide 5: Scaled Dot-Product Attention
Query와 Key의 내적으로 관련도를 계산하고, Key의 차원 $d_k$의 제곱근으로 나눈 뒤 Softmax를 적용합니다. 마지막으로 Value를 가중합합니다.
Softmax는 각 Query에 대응하는 Key 방향으로 적용합니다. 출력은 후보 하나를 선택한 값이 아니라 Value들의 가중합입니다.
Slide 6: Attention의 직관적 예시
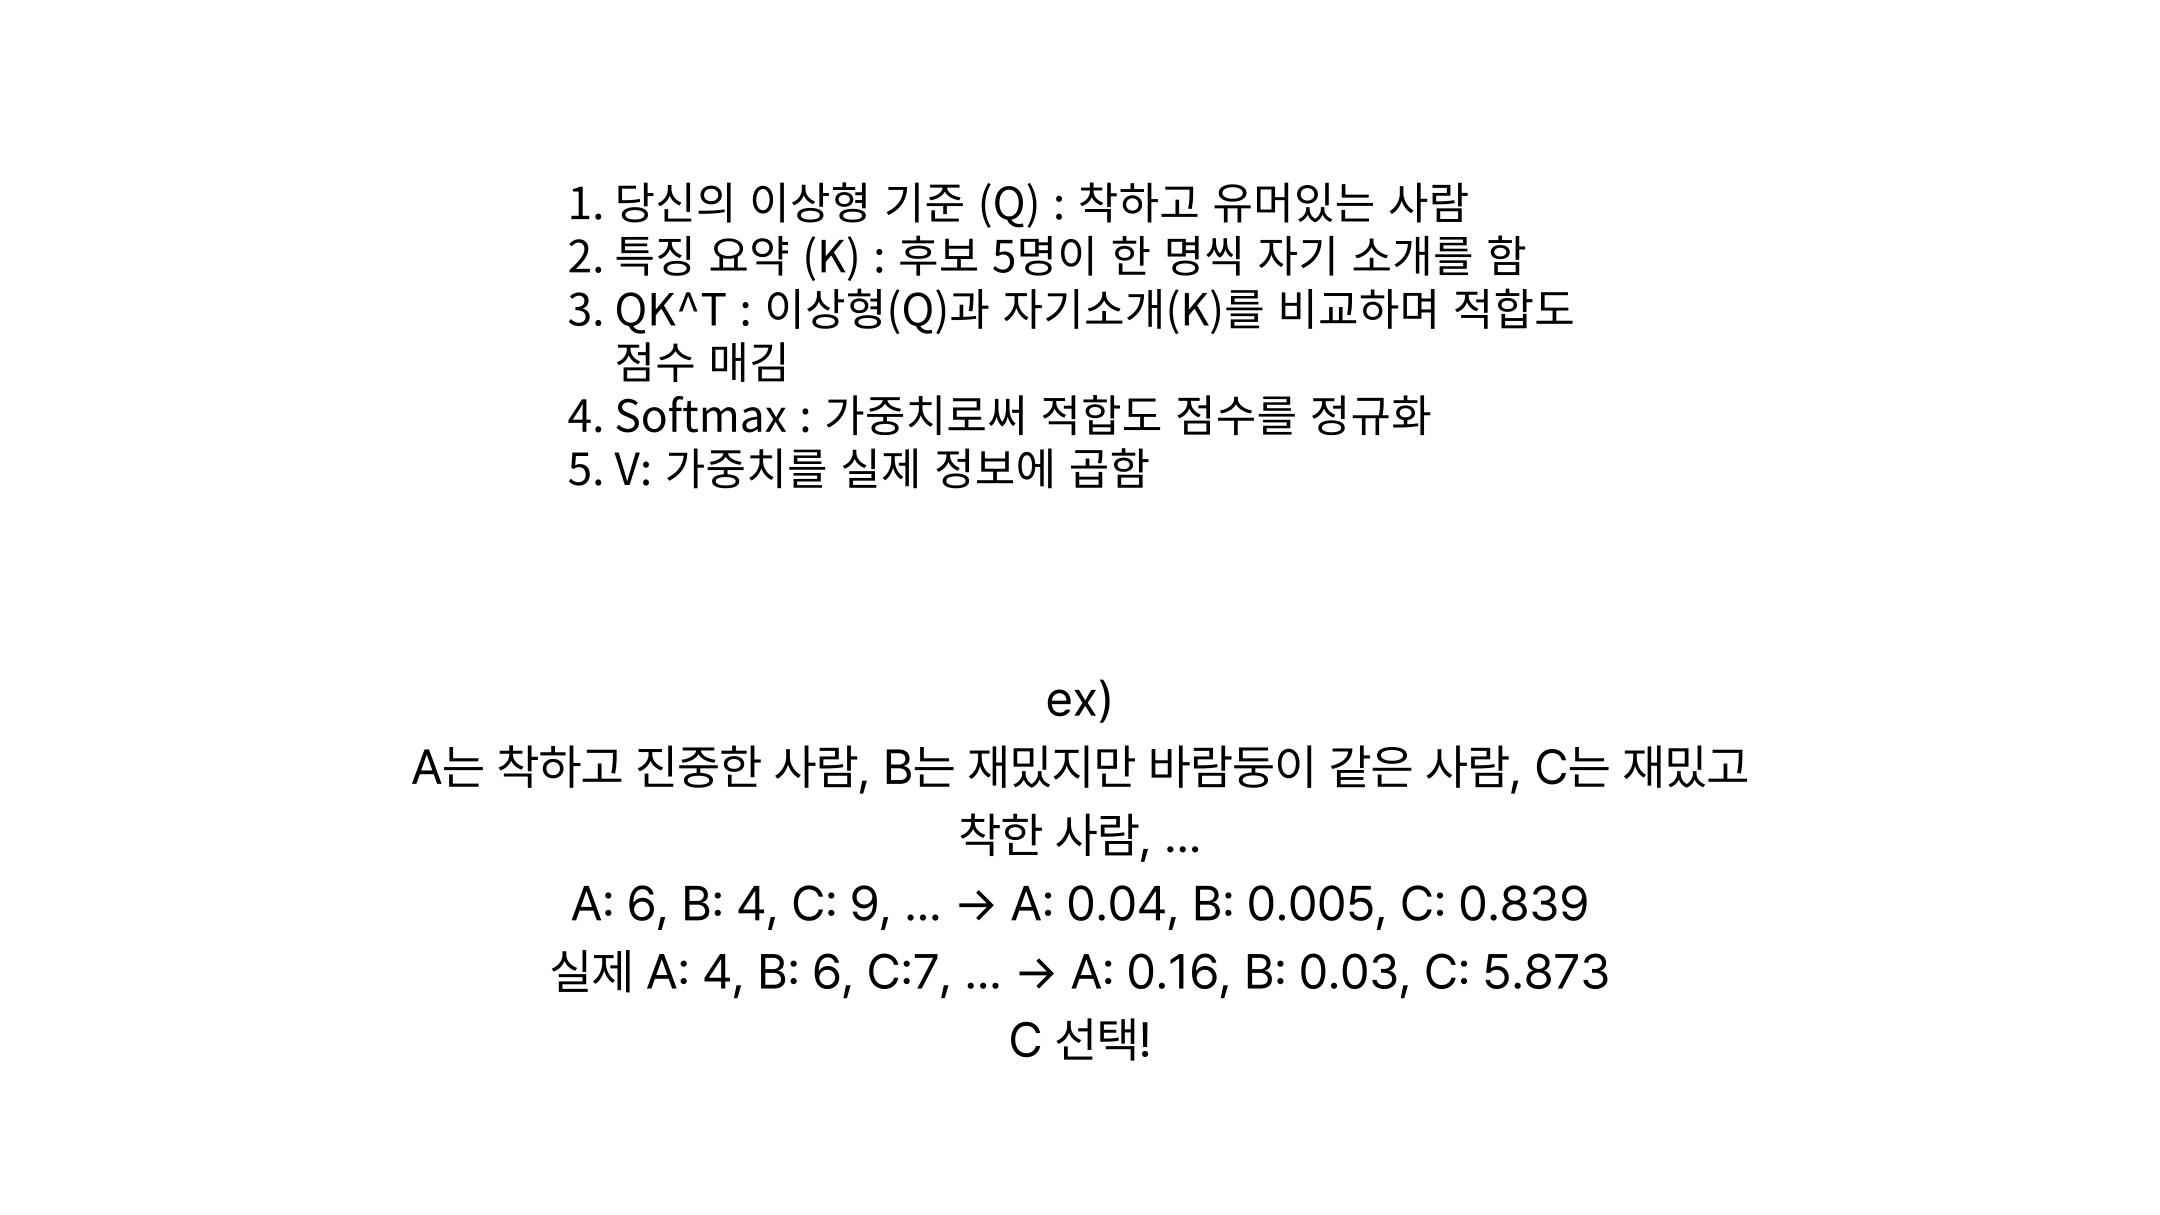
슬라이드의 후보별 점수는 관련도가 높은 대상에 더 큰 비중이 배정되는 과정을 보여줍니다. 다만 실제 Attention은 가장 큰 점수를 받은 후보만 고르는 것이 아니라, 모든 Value에 가중치를 곱해 더합니다.
Slide 7: Attention Step-by-Step
이제 번역 예시를 통해 Attention 계산을 단계별로 따라갑니다. 이 부분의 그림은 발표 자료에 명시된 24-1 Transformer Session 자료(Wooseok Seo) 및 StatQuest YouTube Channel을 참고합니다.
Slide 8: 기존 LSTM의 정보 병목
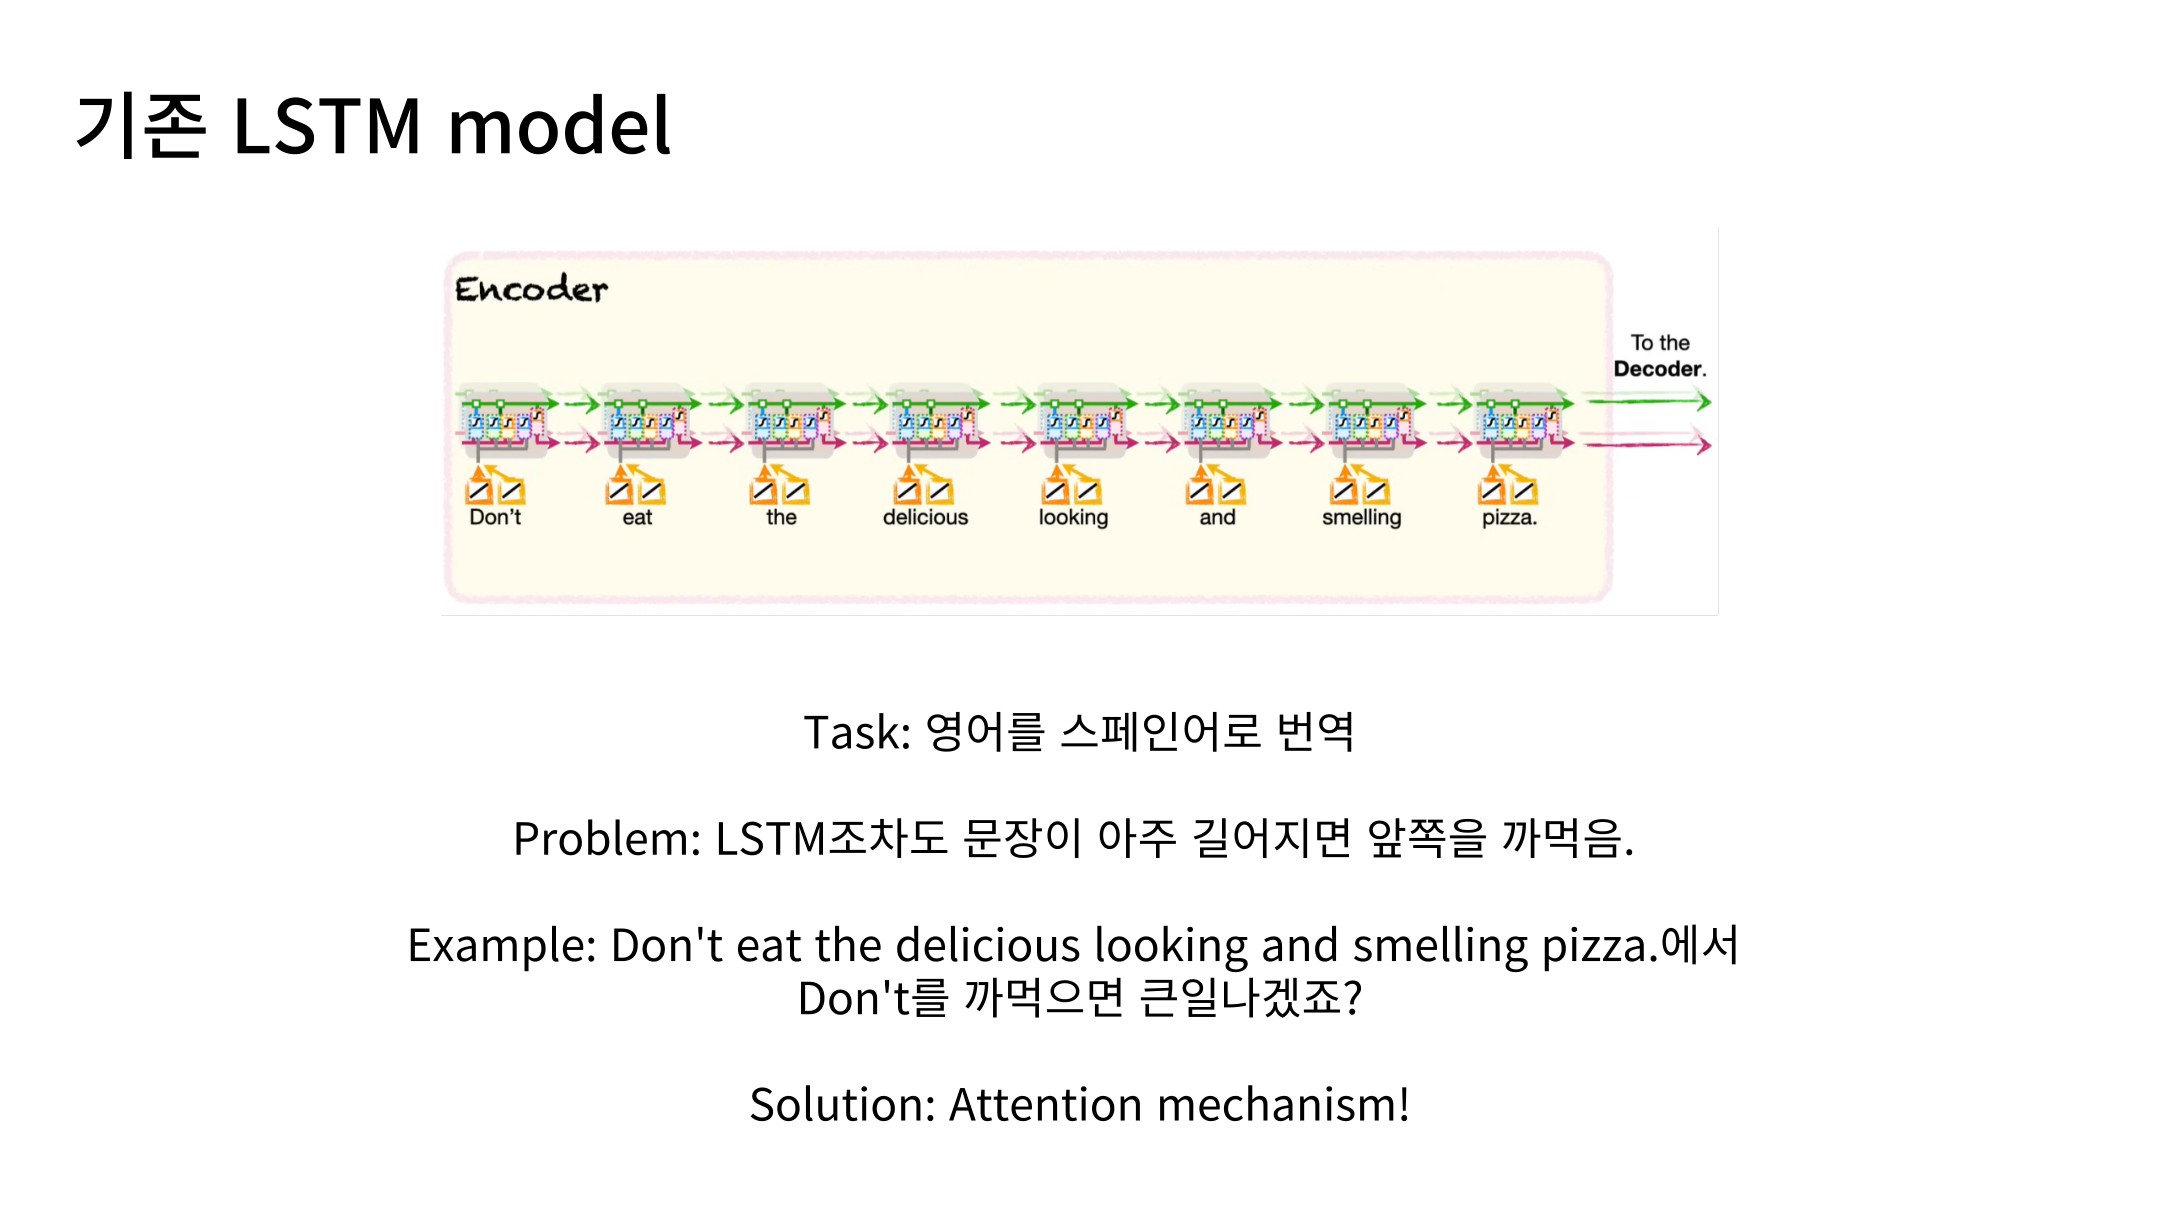
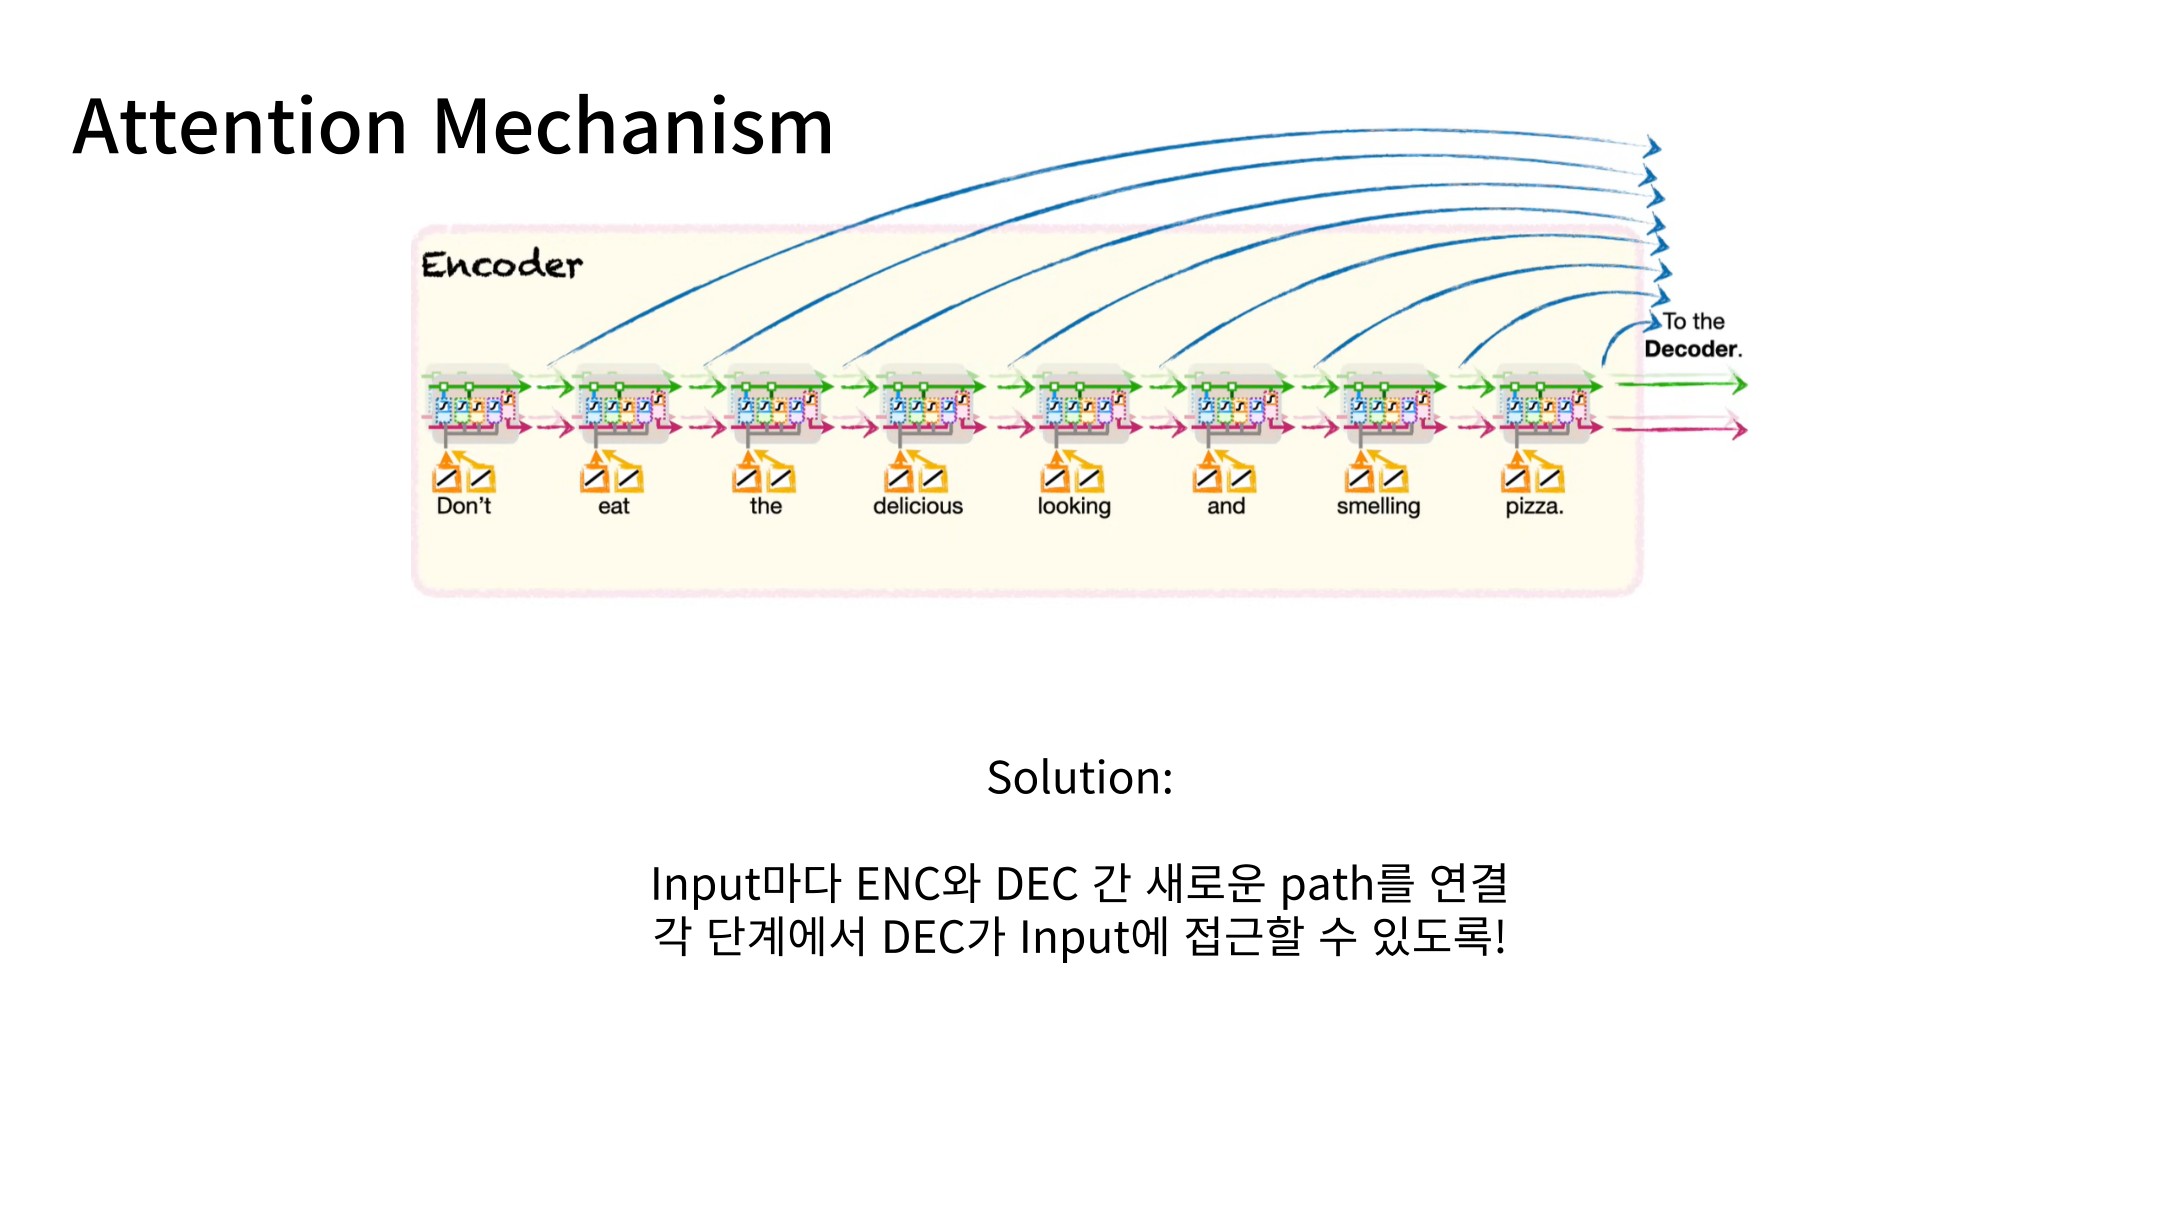
기본적인 Encoder–Decoder LSTM은 입력 문장을 고정된 크기의 상태로 요약해 Decoder에 전달합니다. 문장이 길어지면 앞부분의 세부 정보를 충분히 보존하기 어려워질 수 있습니다.
Slide 9: Attention으로 입력을 다시 참조하기
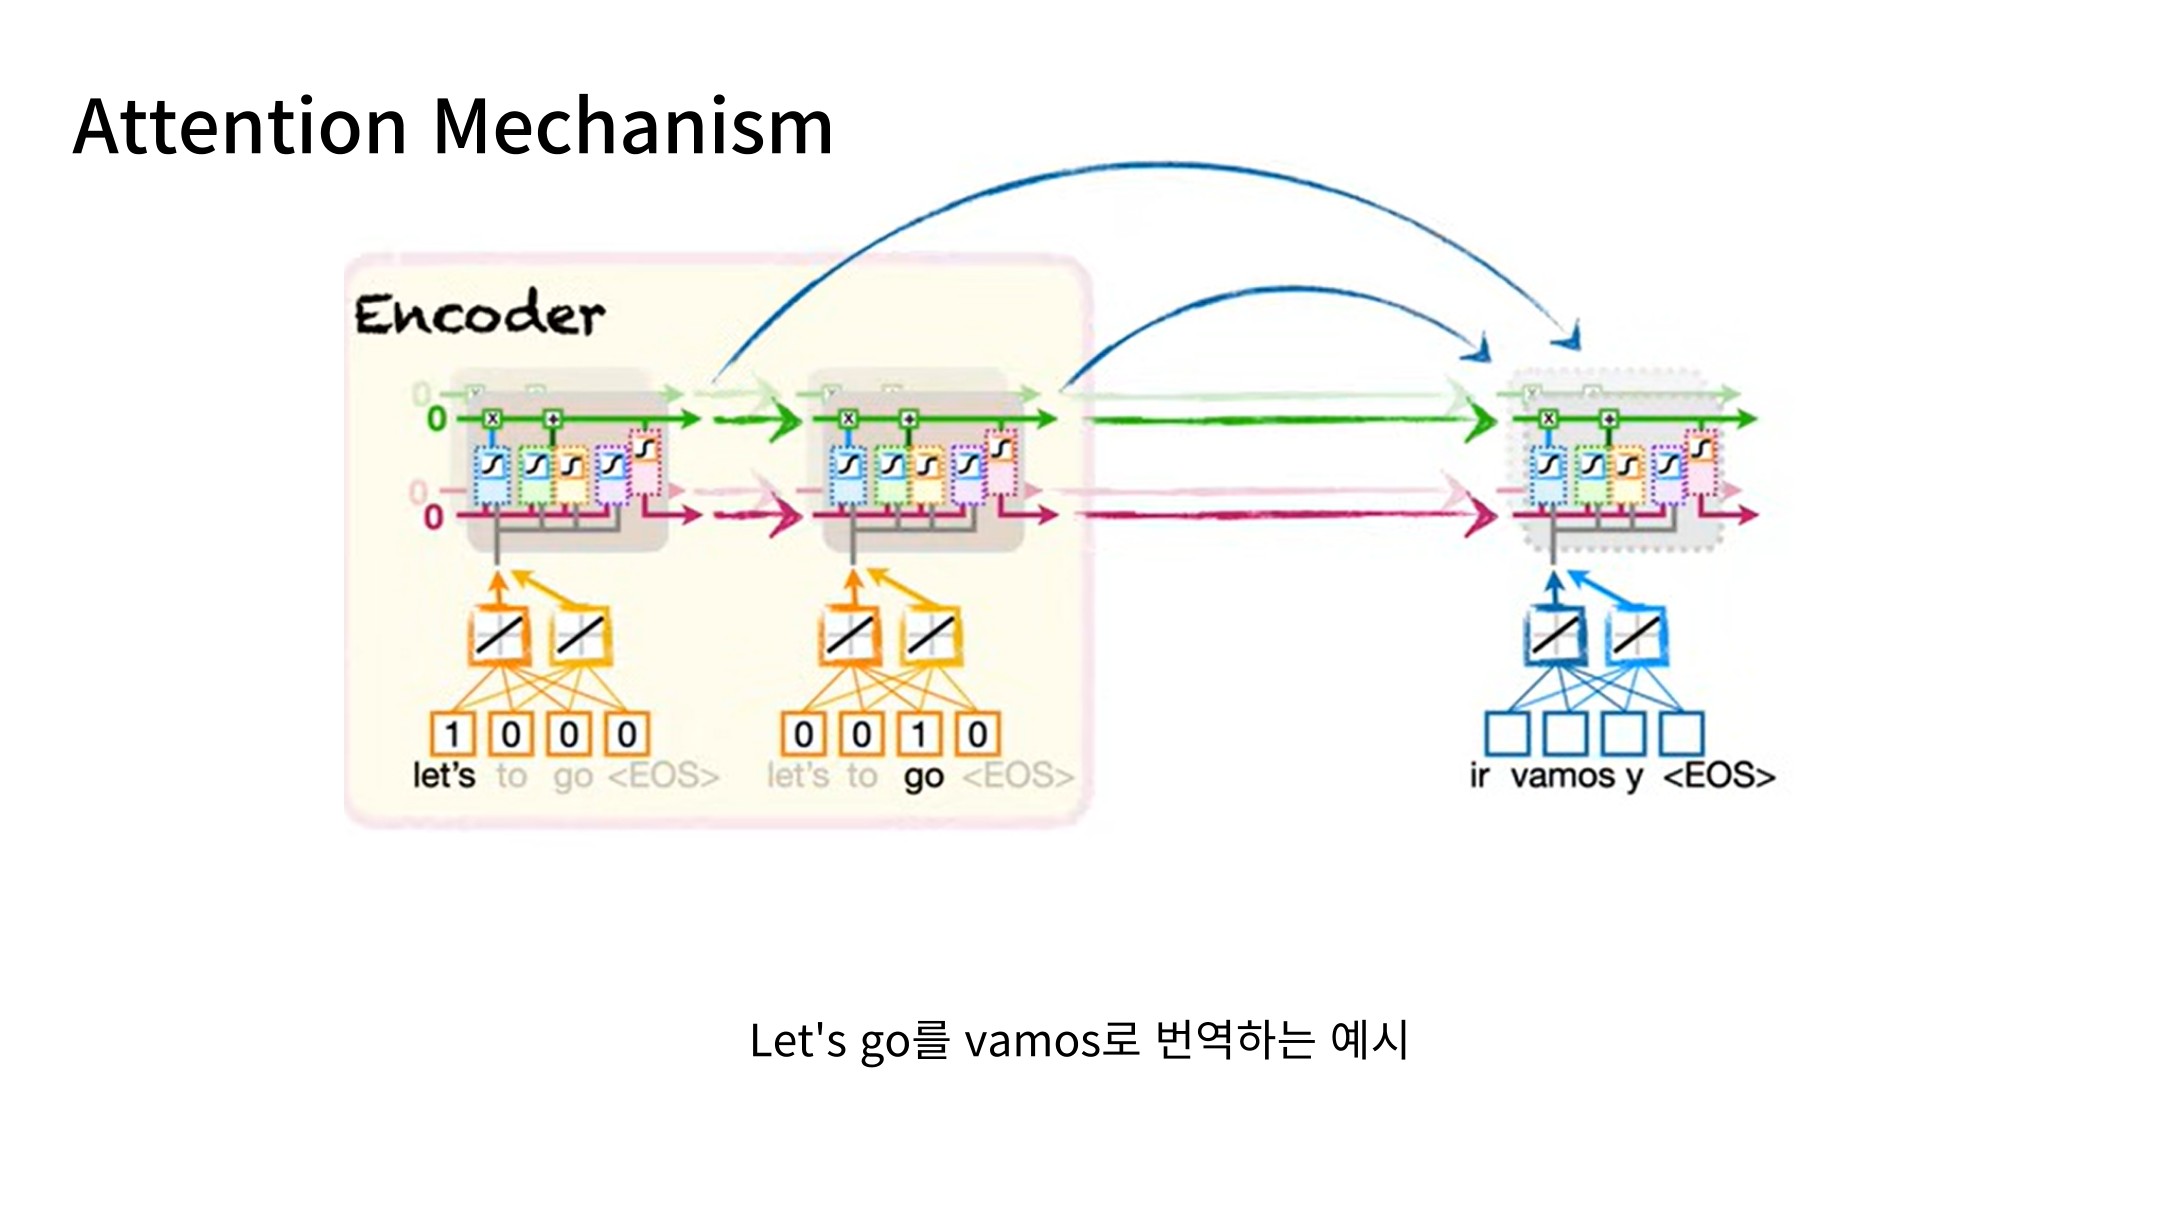
Attention은 Decoder가 출력 단어를 만들 때 Encoder의 여러 위치를 직접 참조할 수 있게 합니다. 하나의 최종 상태에만 의존하던 정보 전달 경로를 확장합니다.
Slide 10: 번역 예시
“Let’s go”를 “vamos”로 번역하는 예시입니다. Decoder는 시작 신호를 받아 첫 출력 단어를 예측하며, 이때 입력의 어느 부분에 주목할지 계산합니다. 그림의 시작·종료 토큰 표기는 설명용 예시를 따릅니다.
Slide 11: Attention 계산 흐름
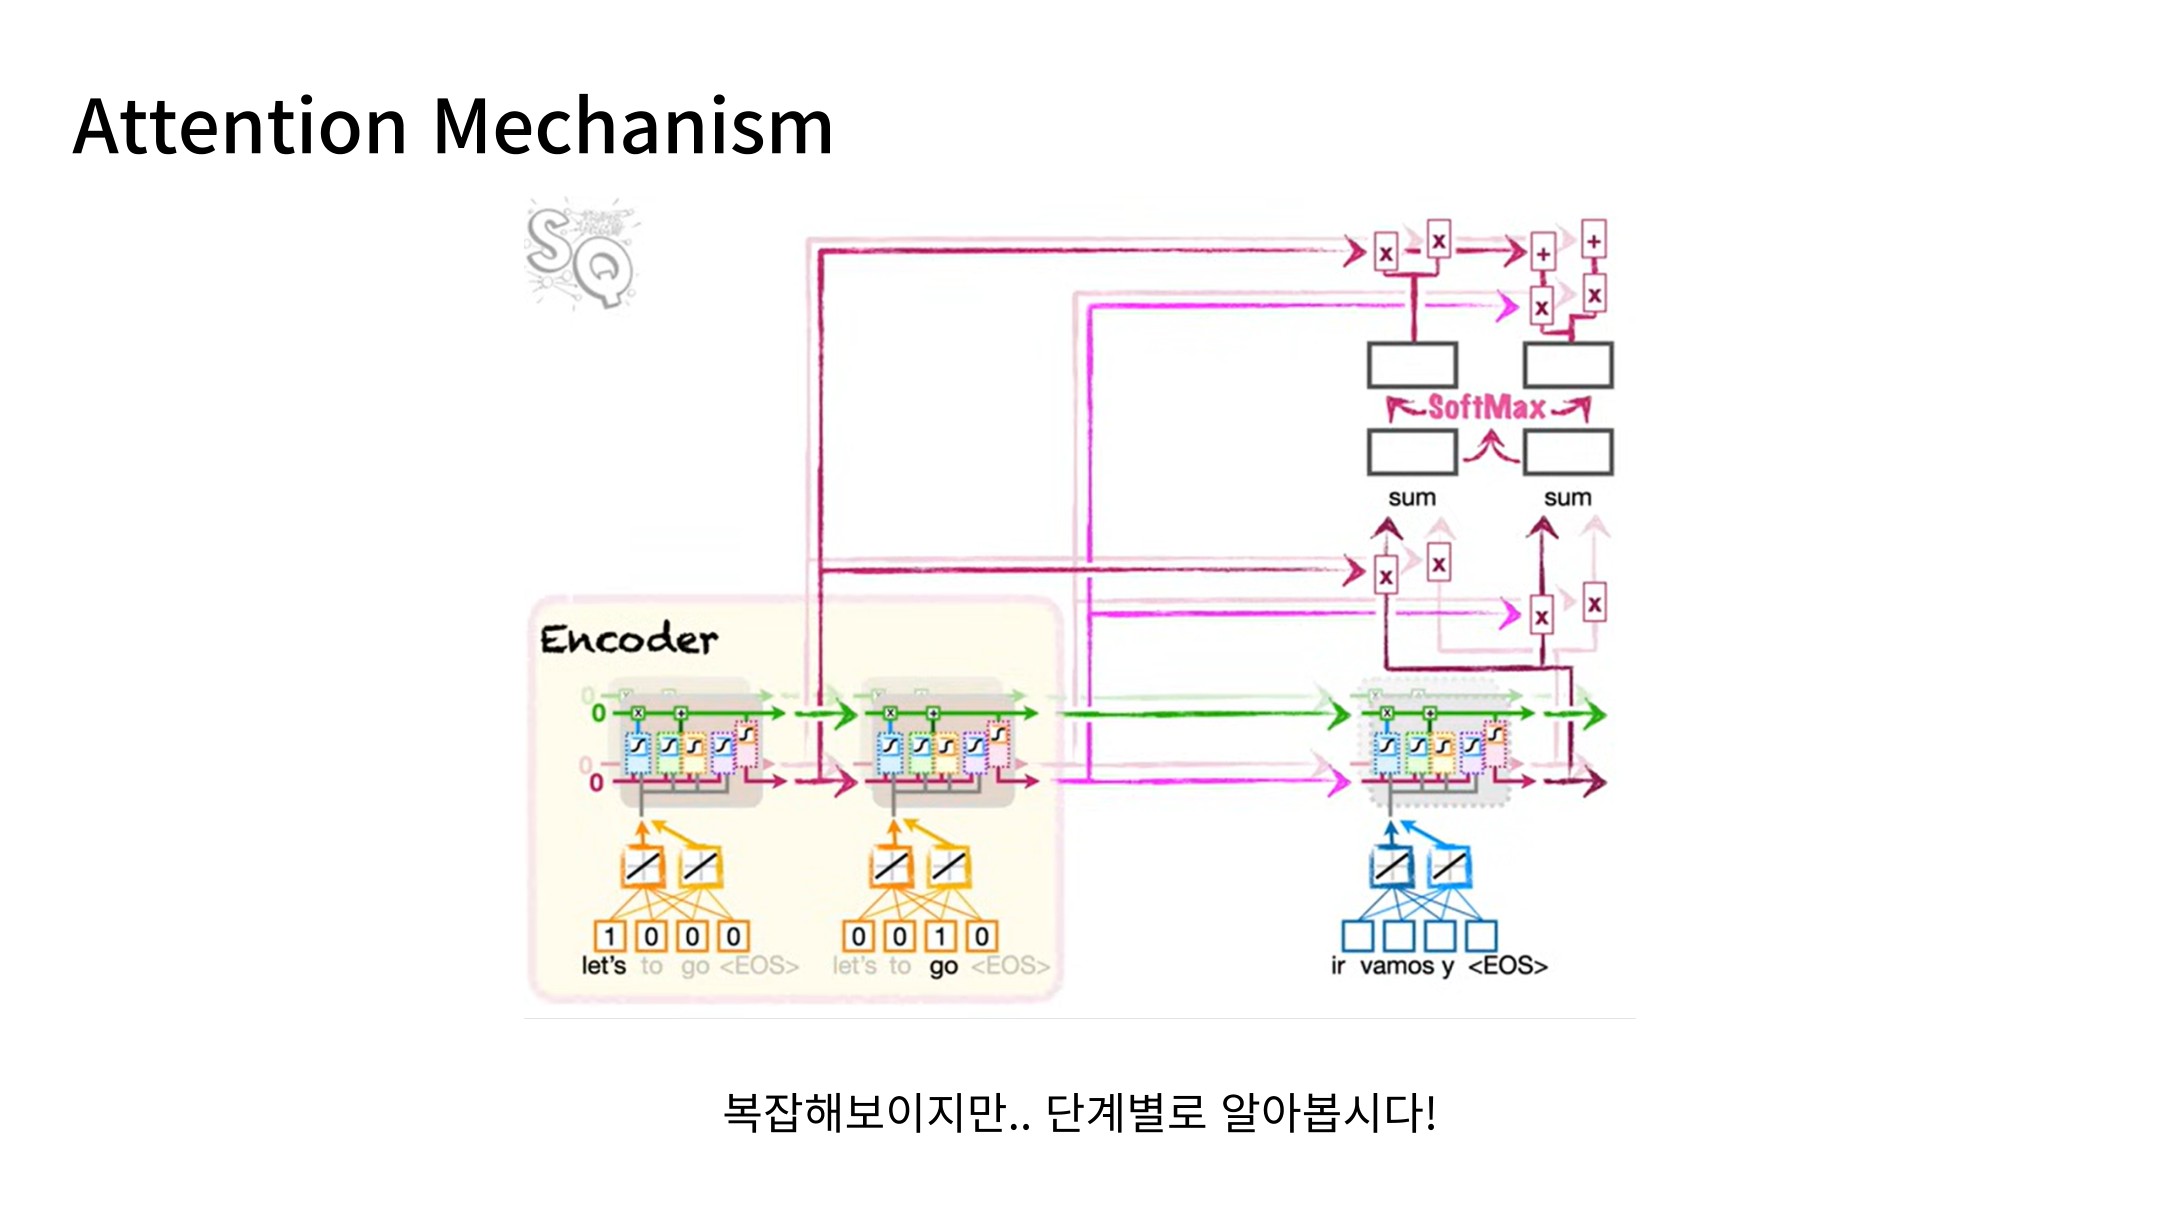
Encoder의 상태와 현재 Decoder 상태를 비교하고, 비교 점수를 정규화한 뒤 입력 정보를 가중합합니다. 이 결과가 다음 단어의 예측을 돕습니다.
Slide 12: Similarity
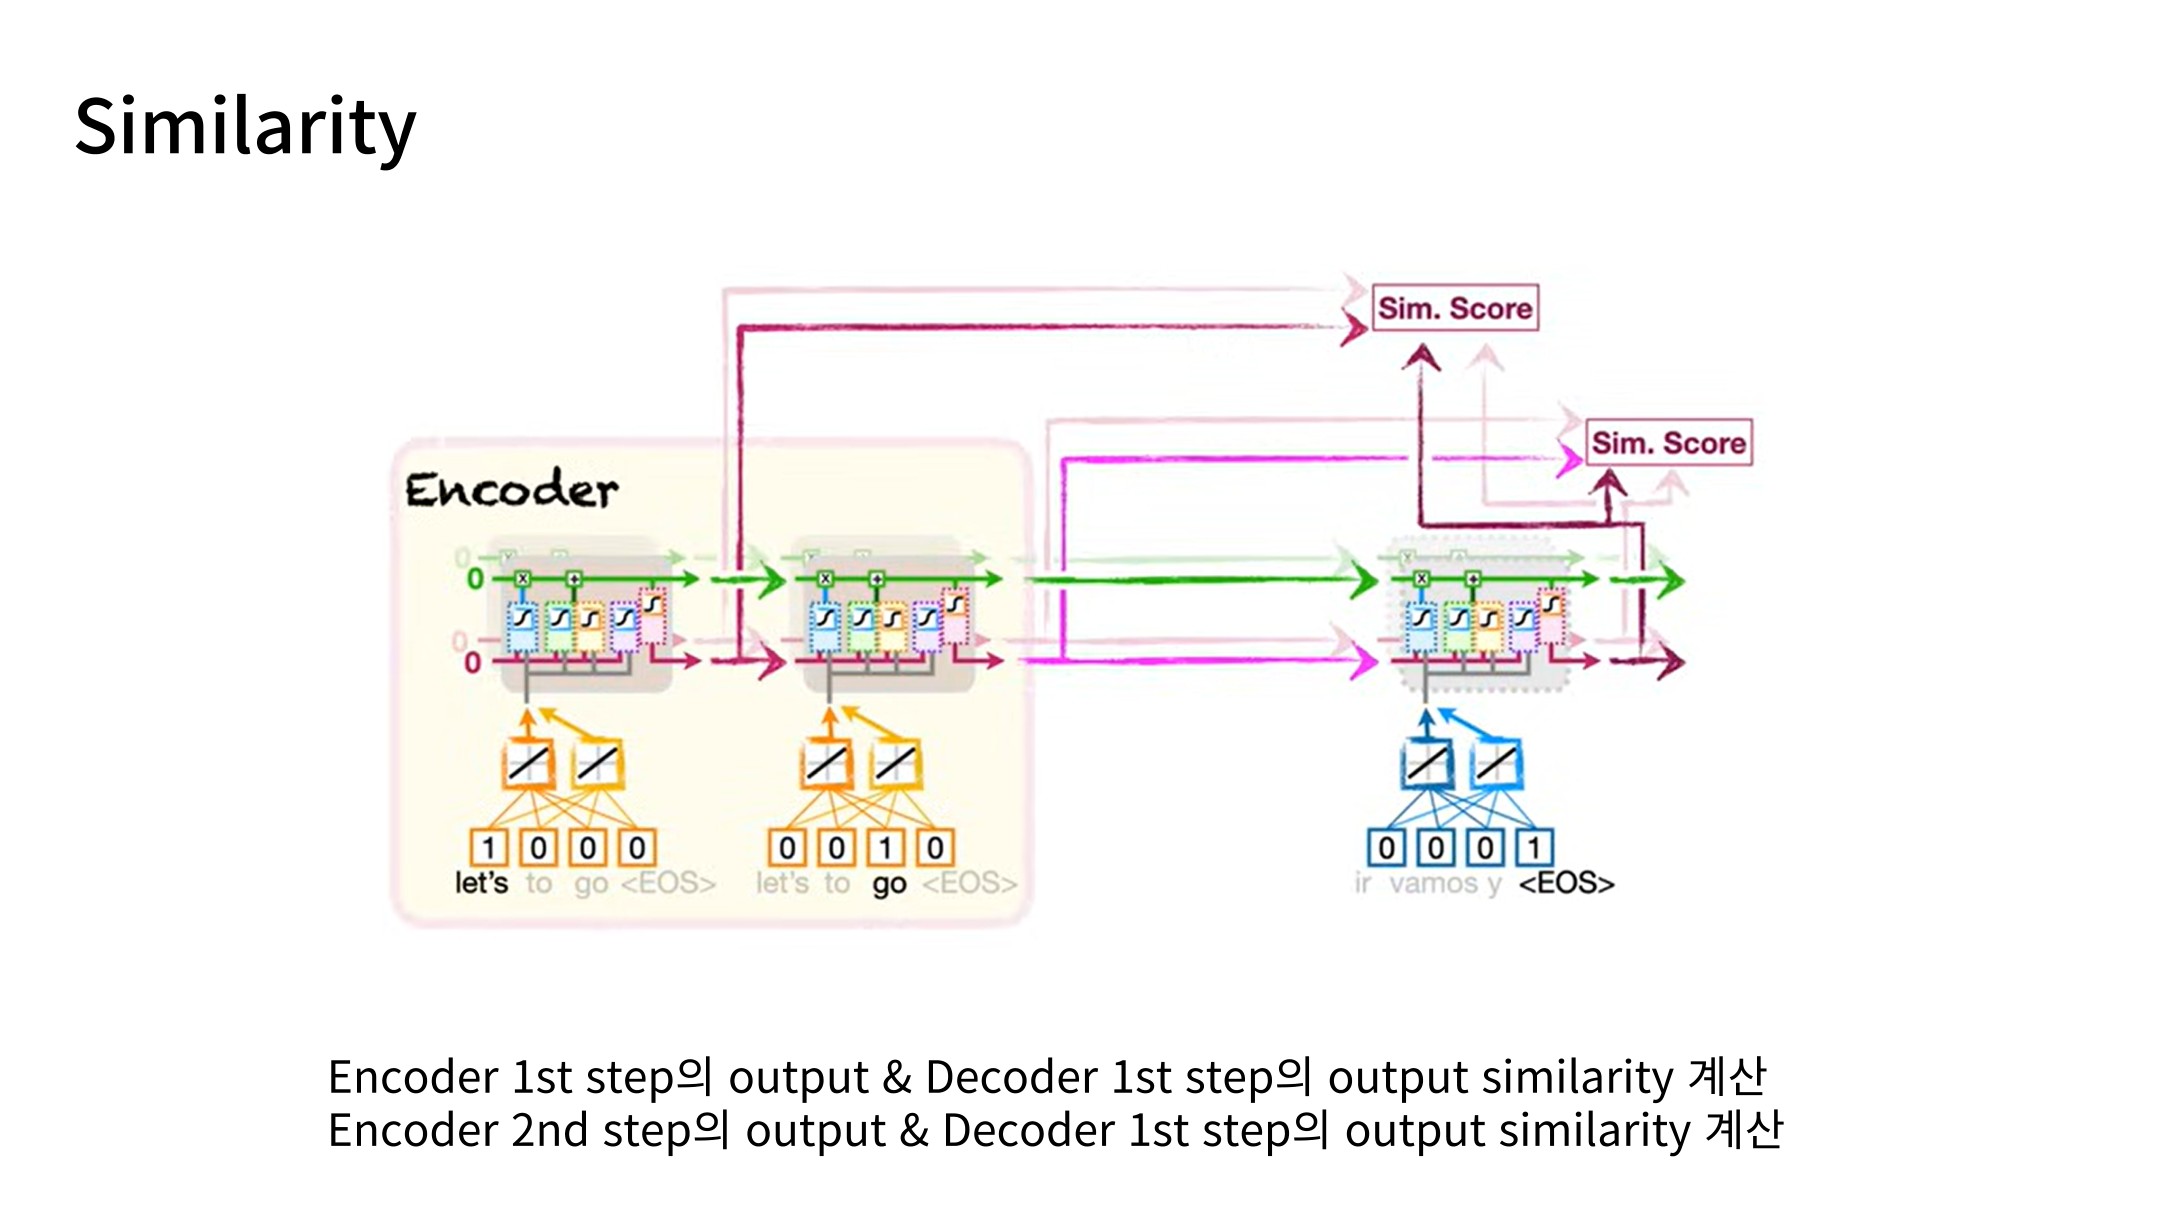
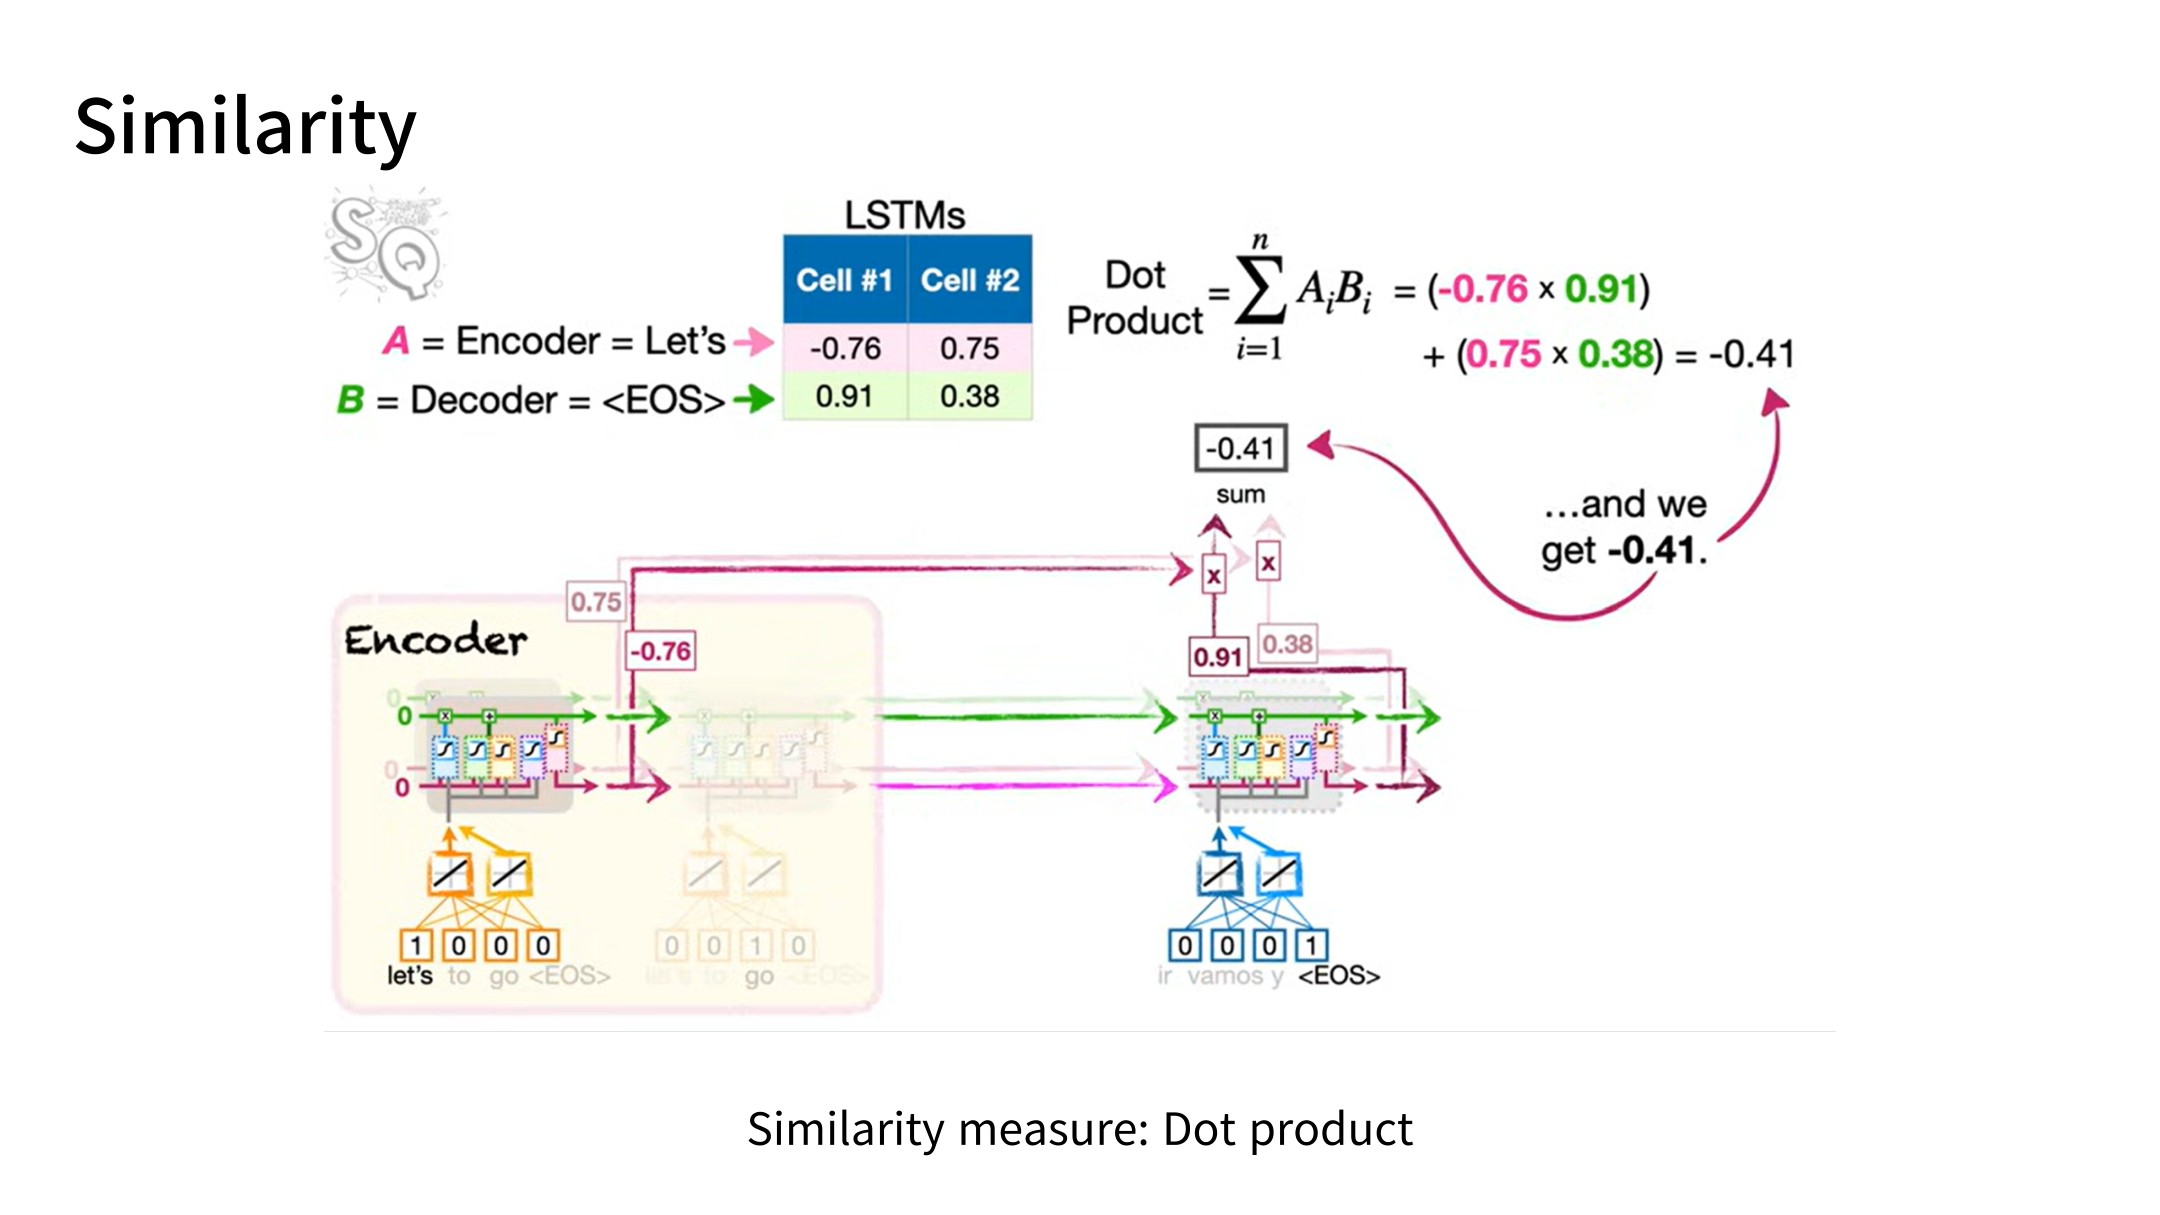
현재 Decoder 상태를 각 Encoder 상태와 비교합니다. 입력 위치마다 하나의 관련도 점수가 만들어집니다.
Slide 13: Dot Product
두 벡터의 내적은 대응하는 성분을 곱한 뒤 더한 값입니다. 그림은 Encoder 상태와 Decoder 상태 사이의 유사도를 내적으로 계산하는 과정을 보여줍니다.
Slide 14: Softmax
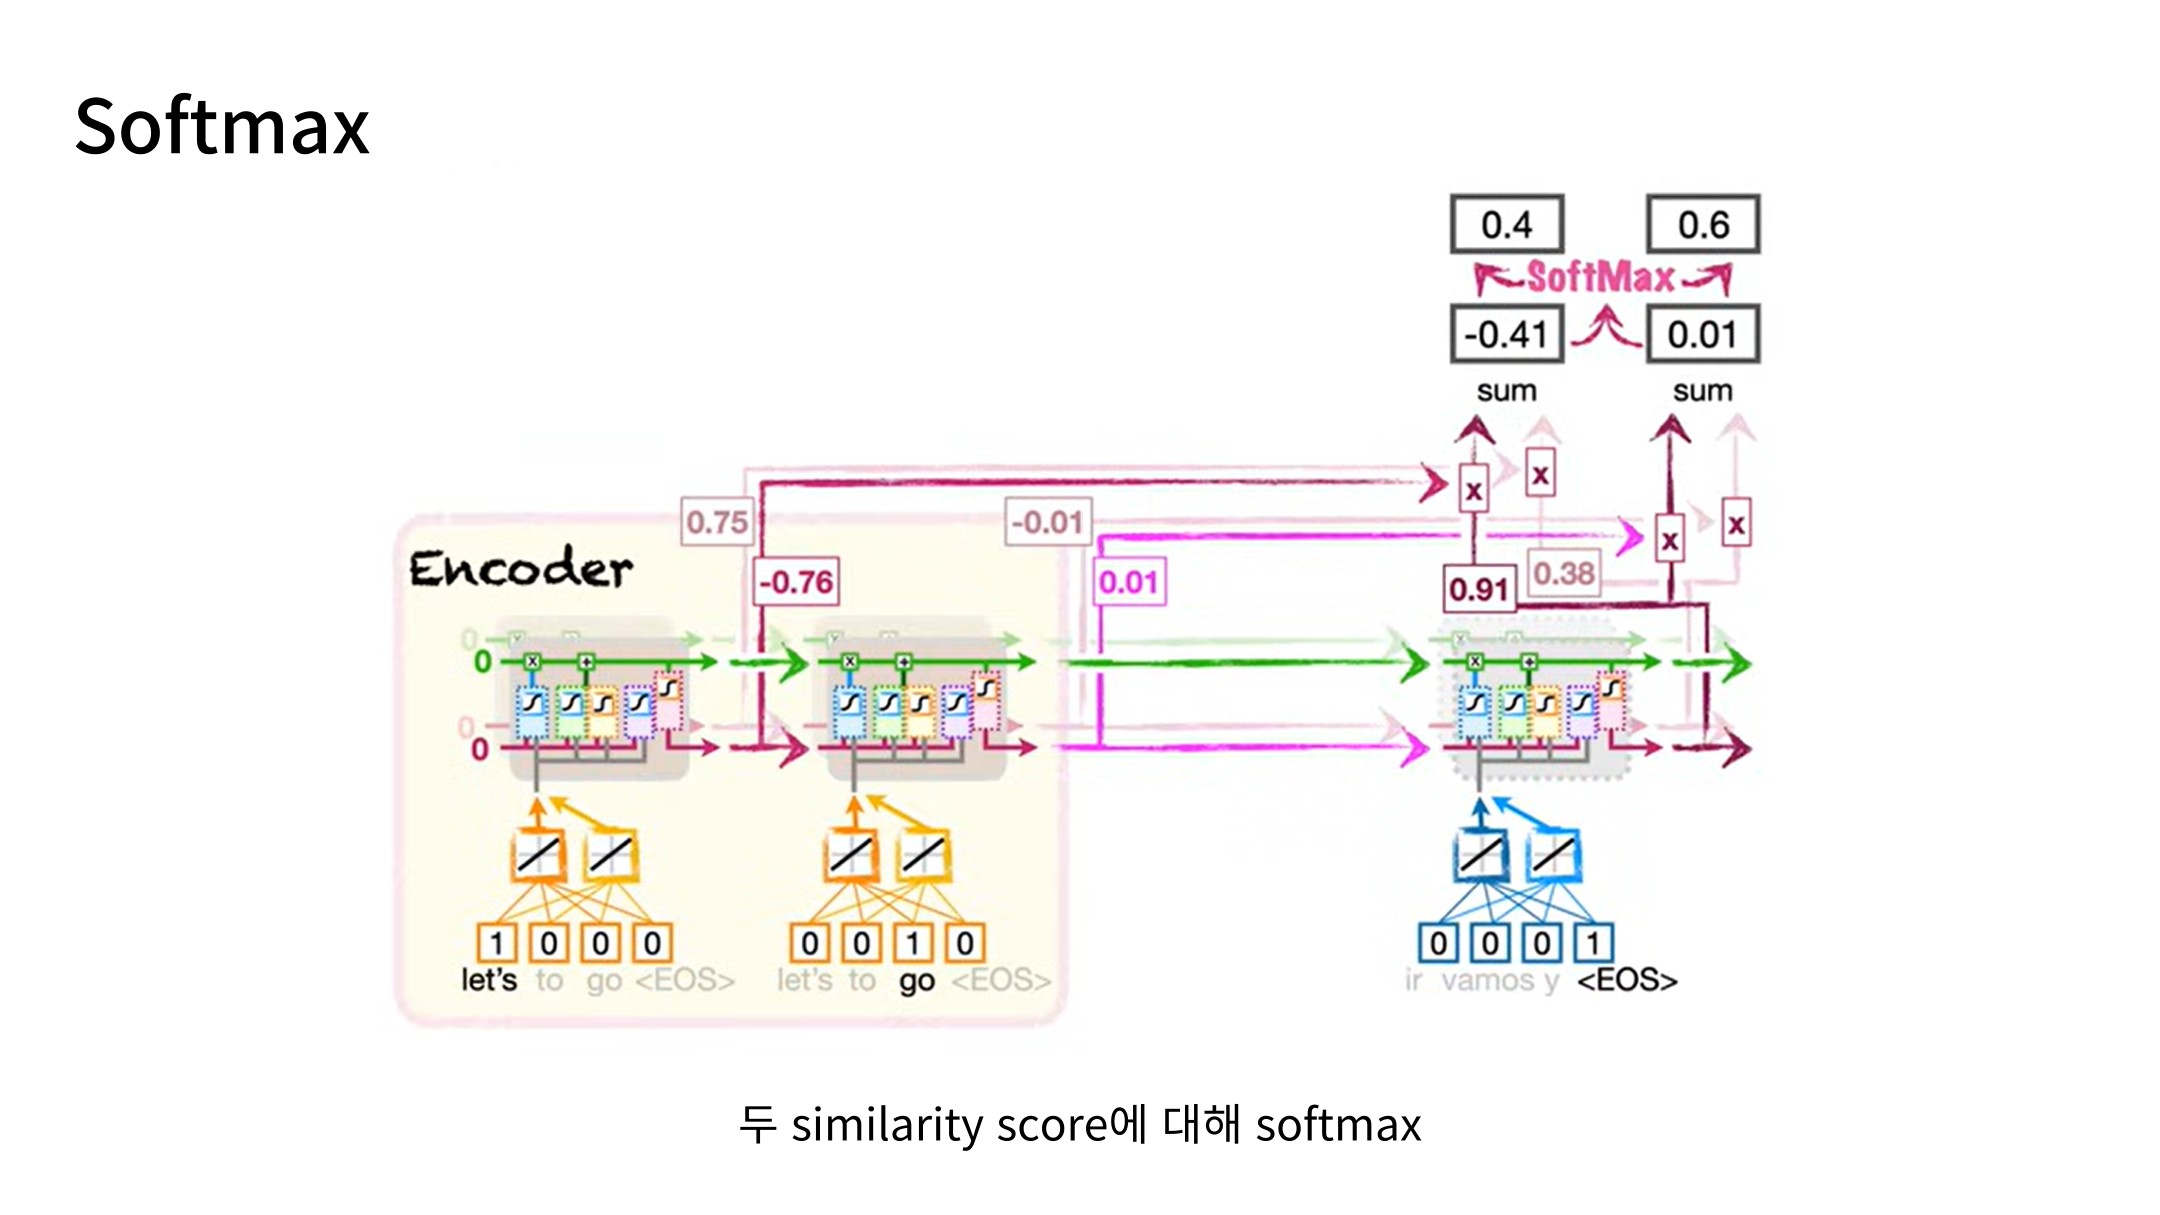
관련도 점수에 Softmax를 적용하면 양수이면서 합이 1인 가중치를 얻습니다. 점수가 큰 입력 위치일수록 더 큰 비중을 받습니다.
Slide 15: 가중합으로 Context 만들기
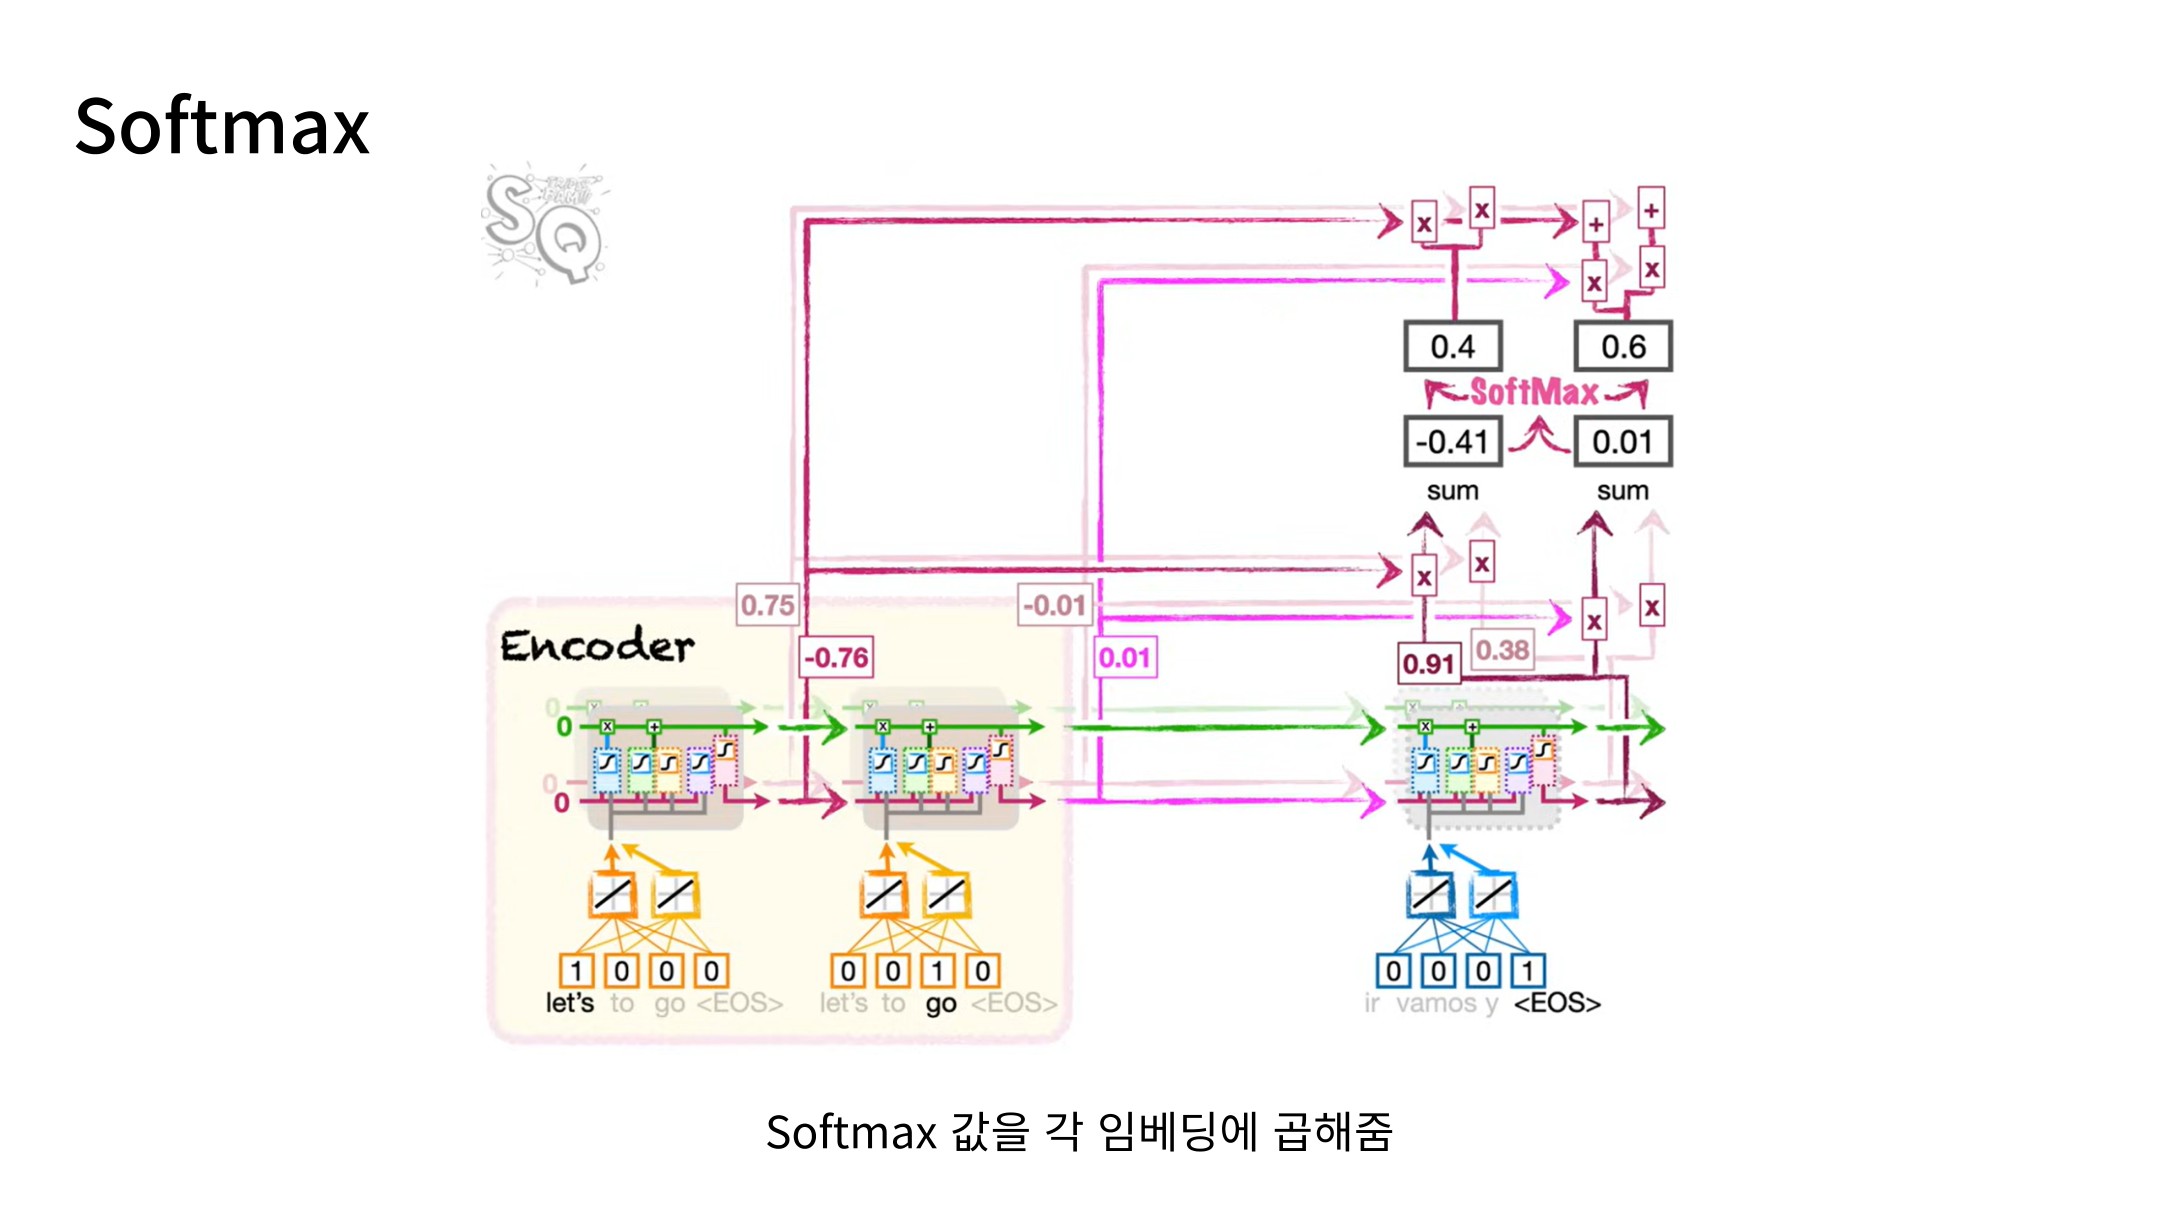
정규화된 가중치를 각 Encoder 상태에 곱한 뒤 더합니다. 이렇게 얻은 Context는 현재 출력 단어를 예측할 때 필요한 입력 정보를 요약합니다.
Slide 16: Fully Connected Layer
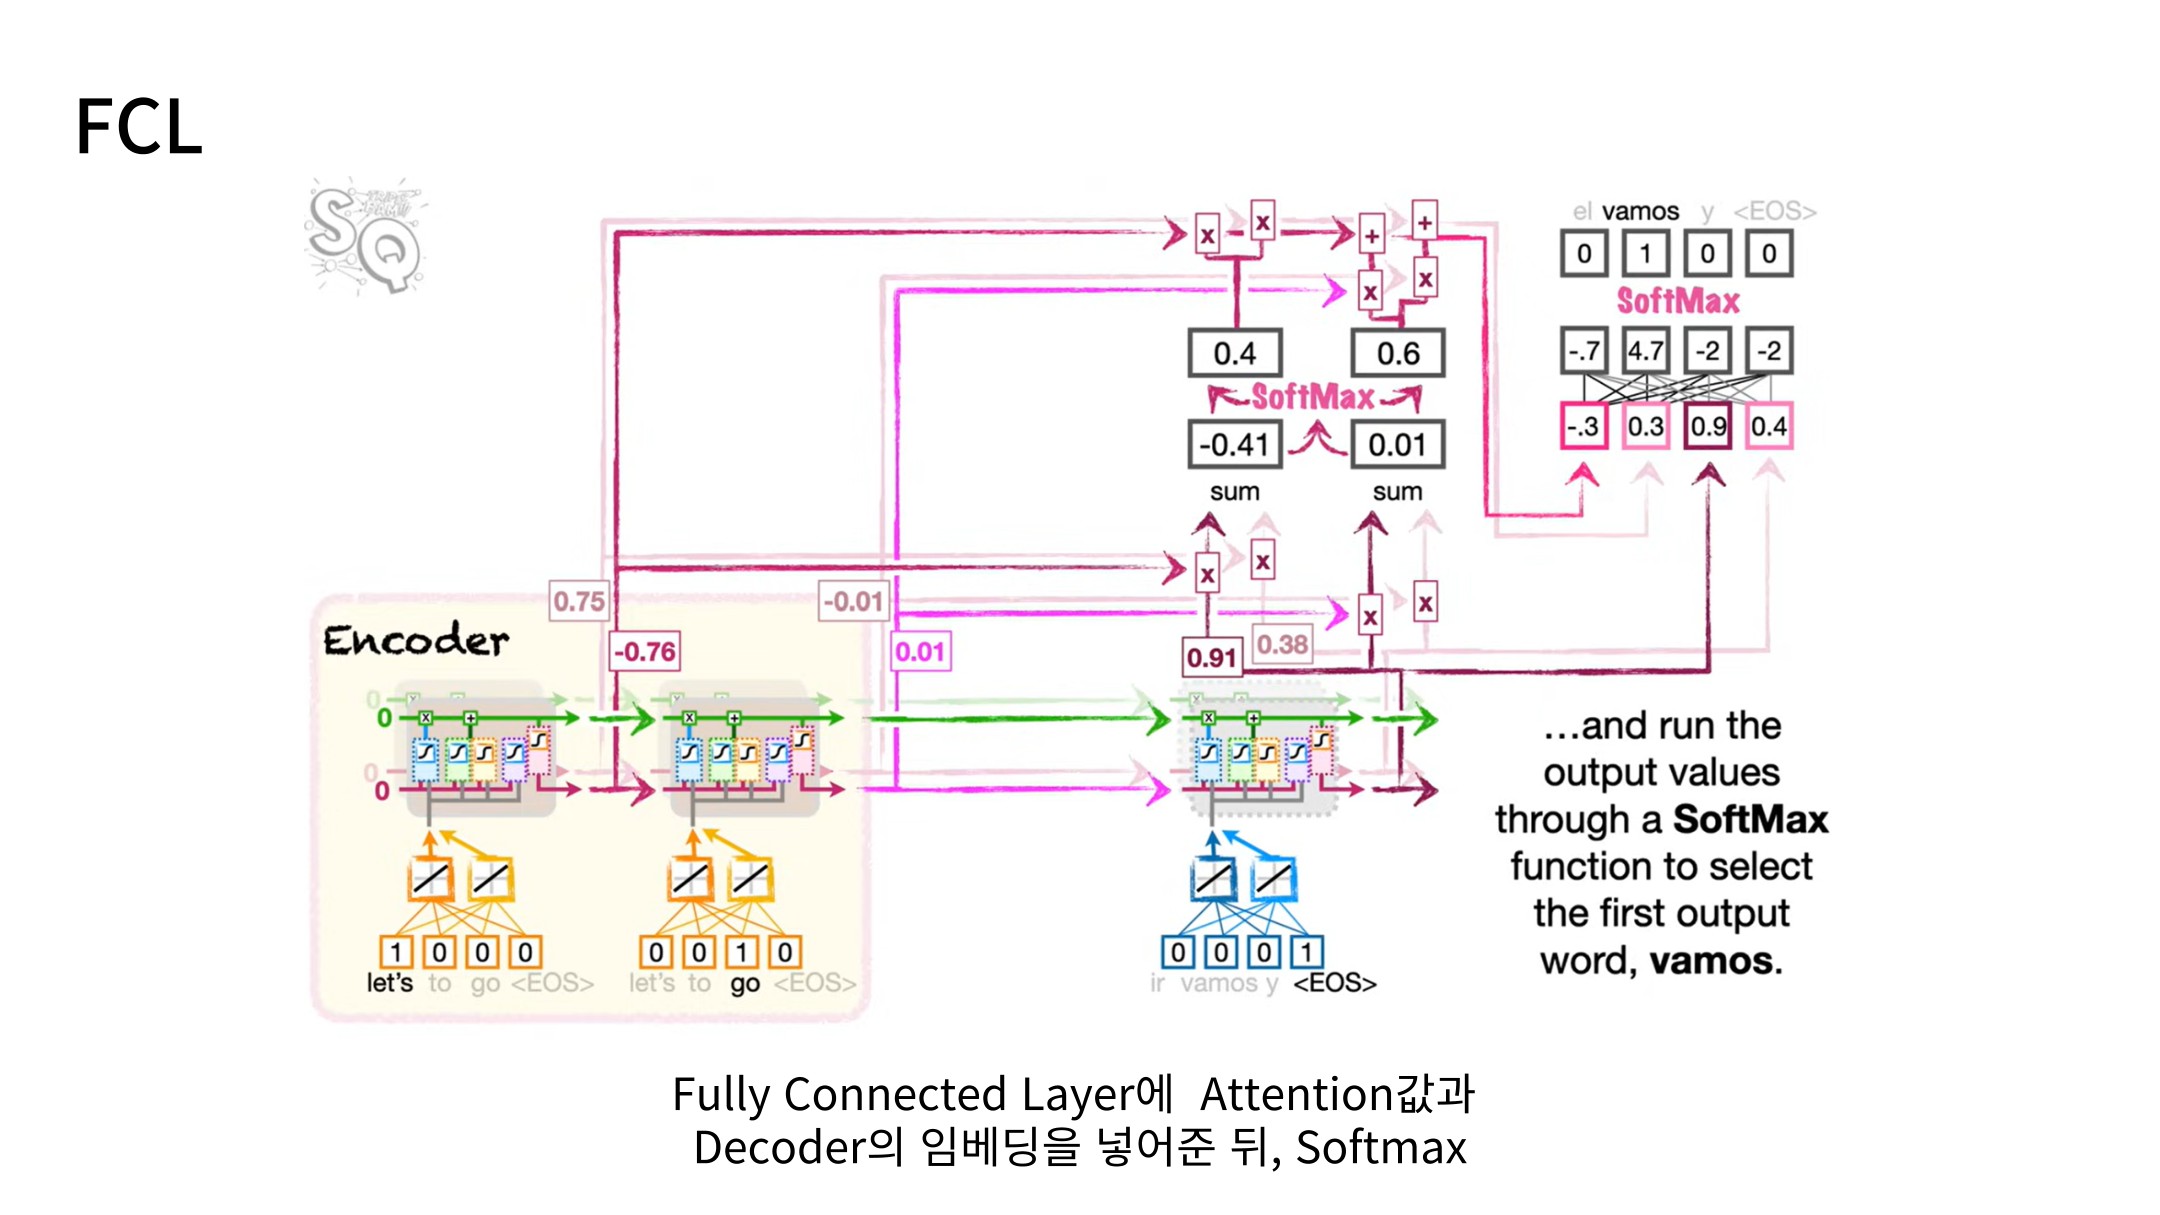
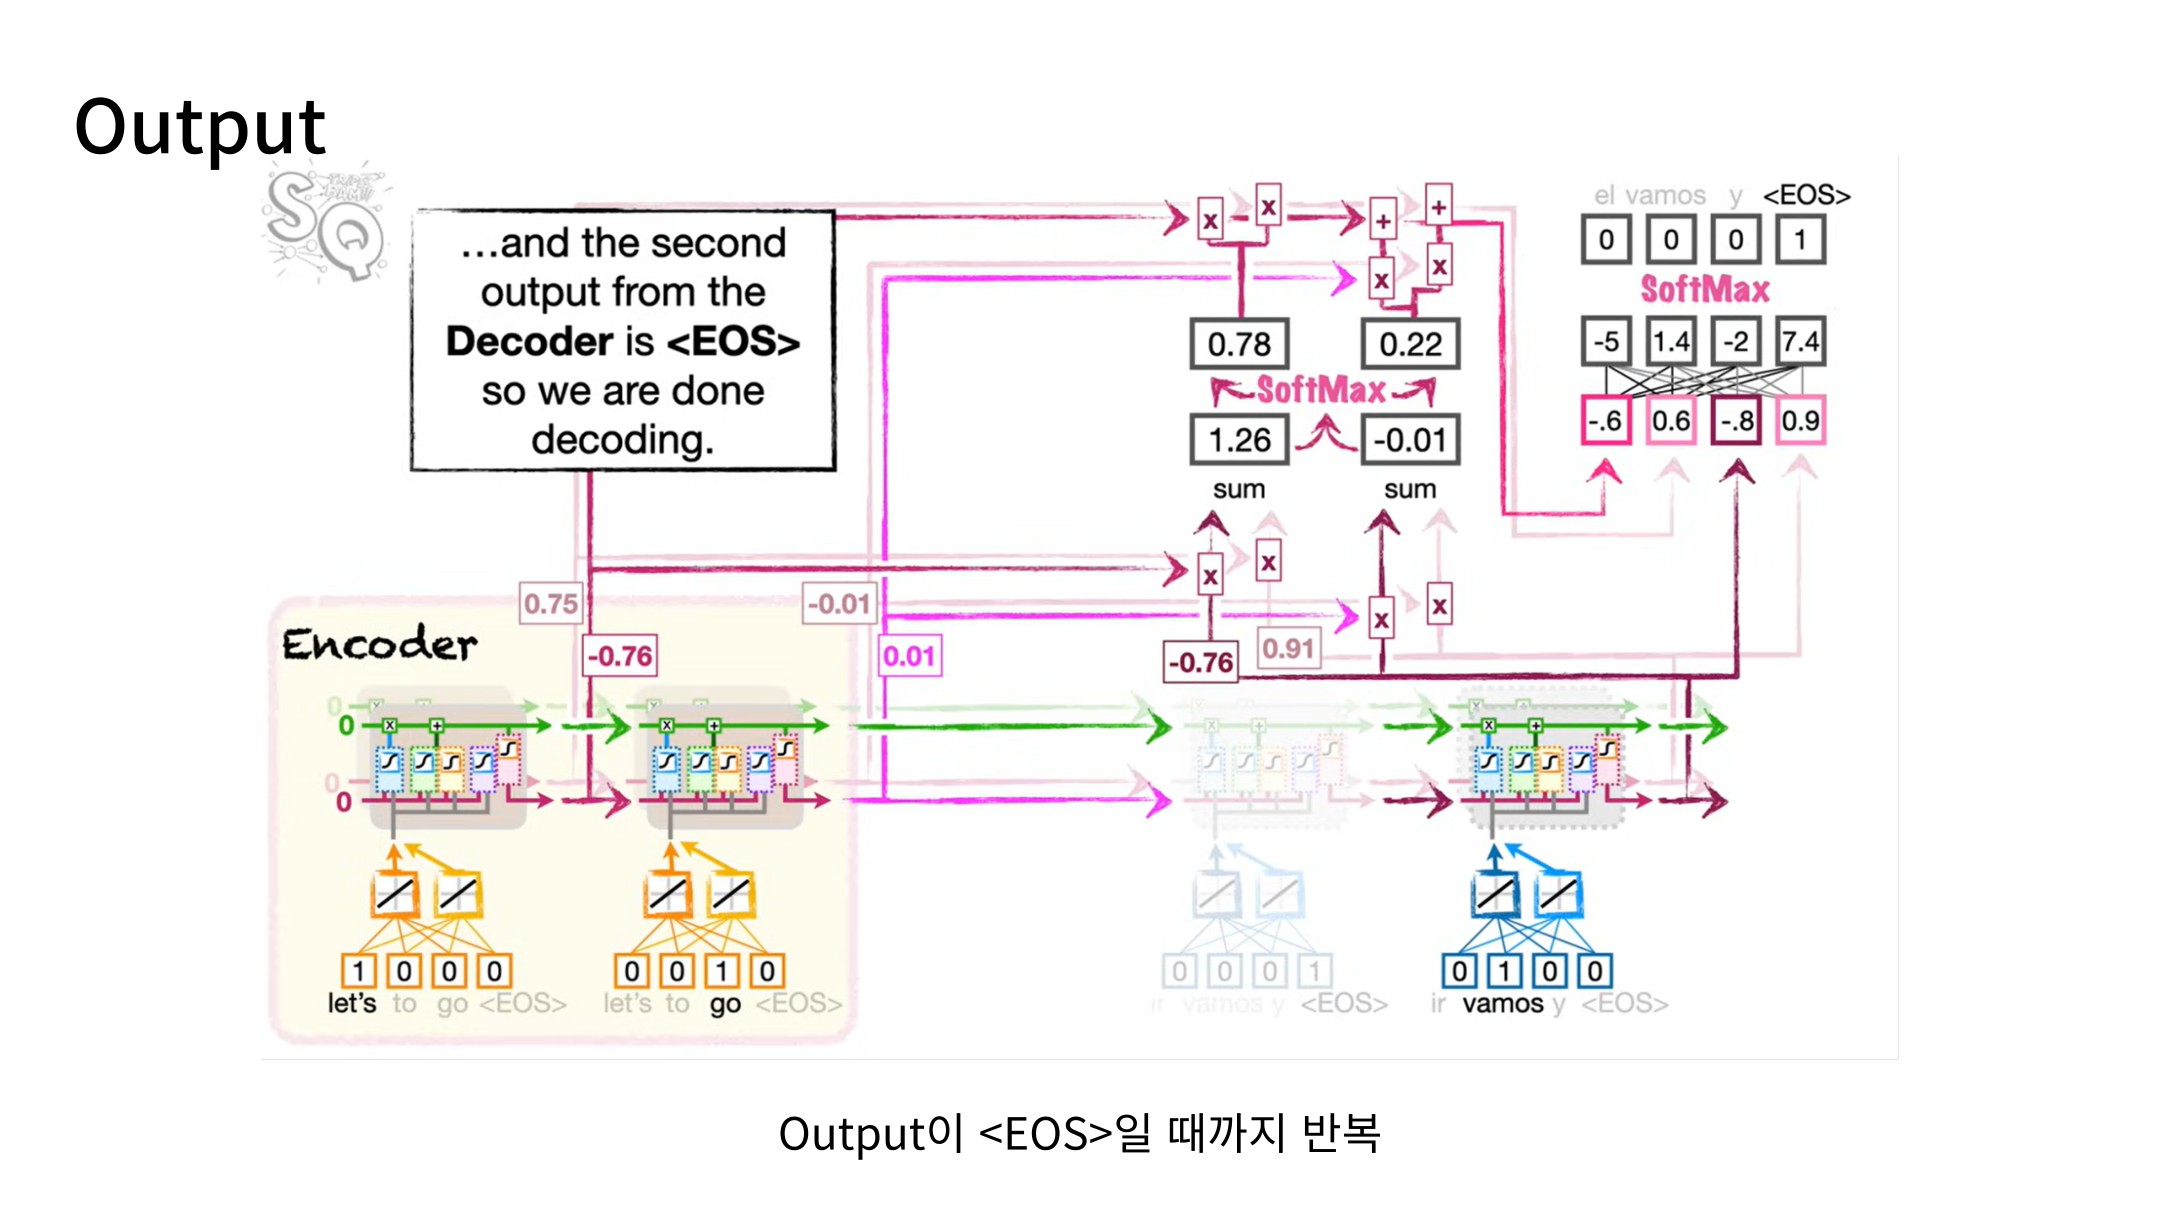
Attention으로 얻은 Context와 Decoder의 정보를 출력층으로 전달합니다. 출력층의 점수에 Softmax를 적용하면 어휘 집합의 각 단어에 대한 확률분포를 얻습니다.
Slide 17: 출력과 종료
예측한 토큰을 다음 단계의 입력으로 사용하며 생성을 이어 갑니다. 종료 토큰을 예측하면 번역을 마칩니다.
Slide 18: Transformer Step-by-Step
이제 순환 구조 대신 Attention을 중심으로 구성한 Transformer를 살펴봅니다. 이 부분 역시 발표 자료에 표시된 Wooseok Seo의 Session 자료와 StatQuest 그림을 바탕으로 설명합니다.
Slide 19: Transformer Overview
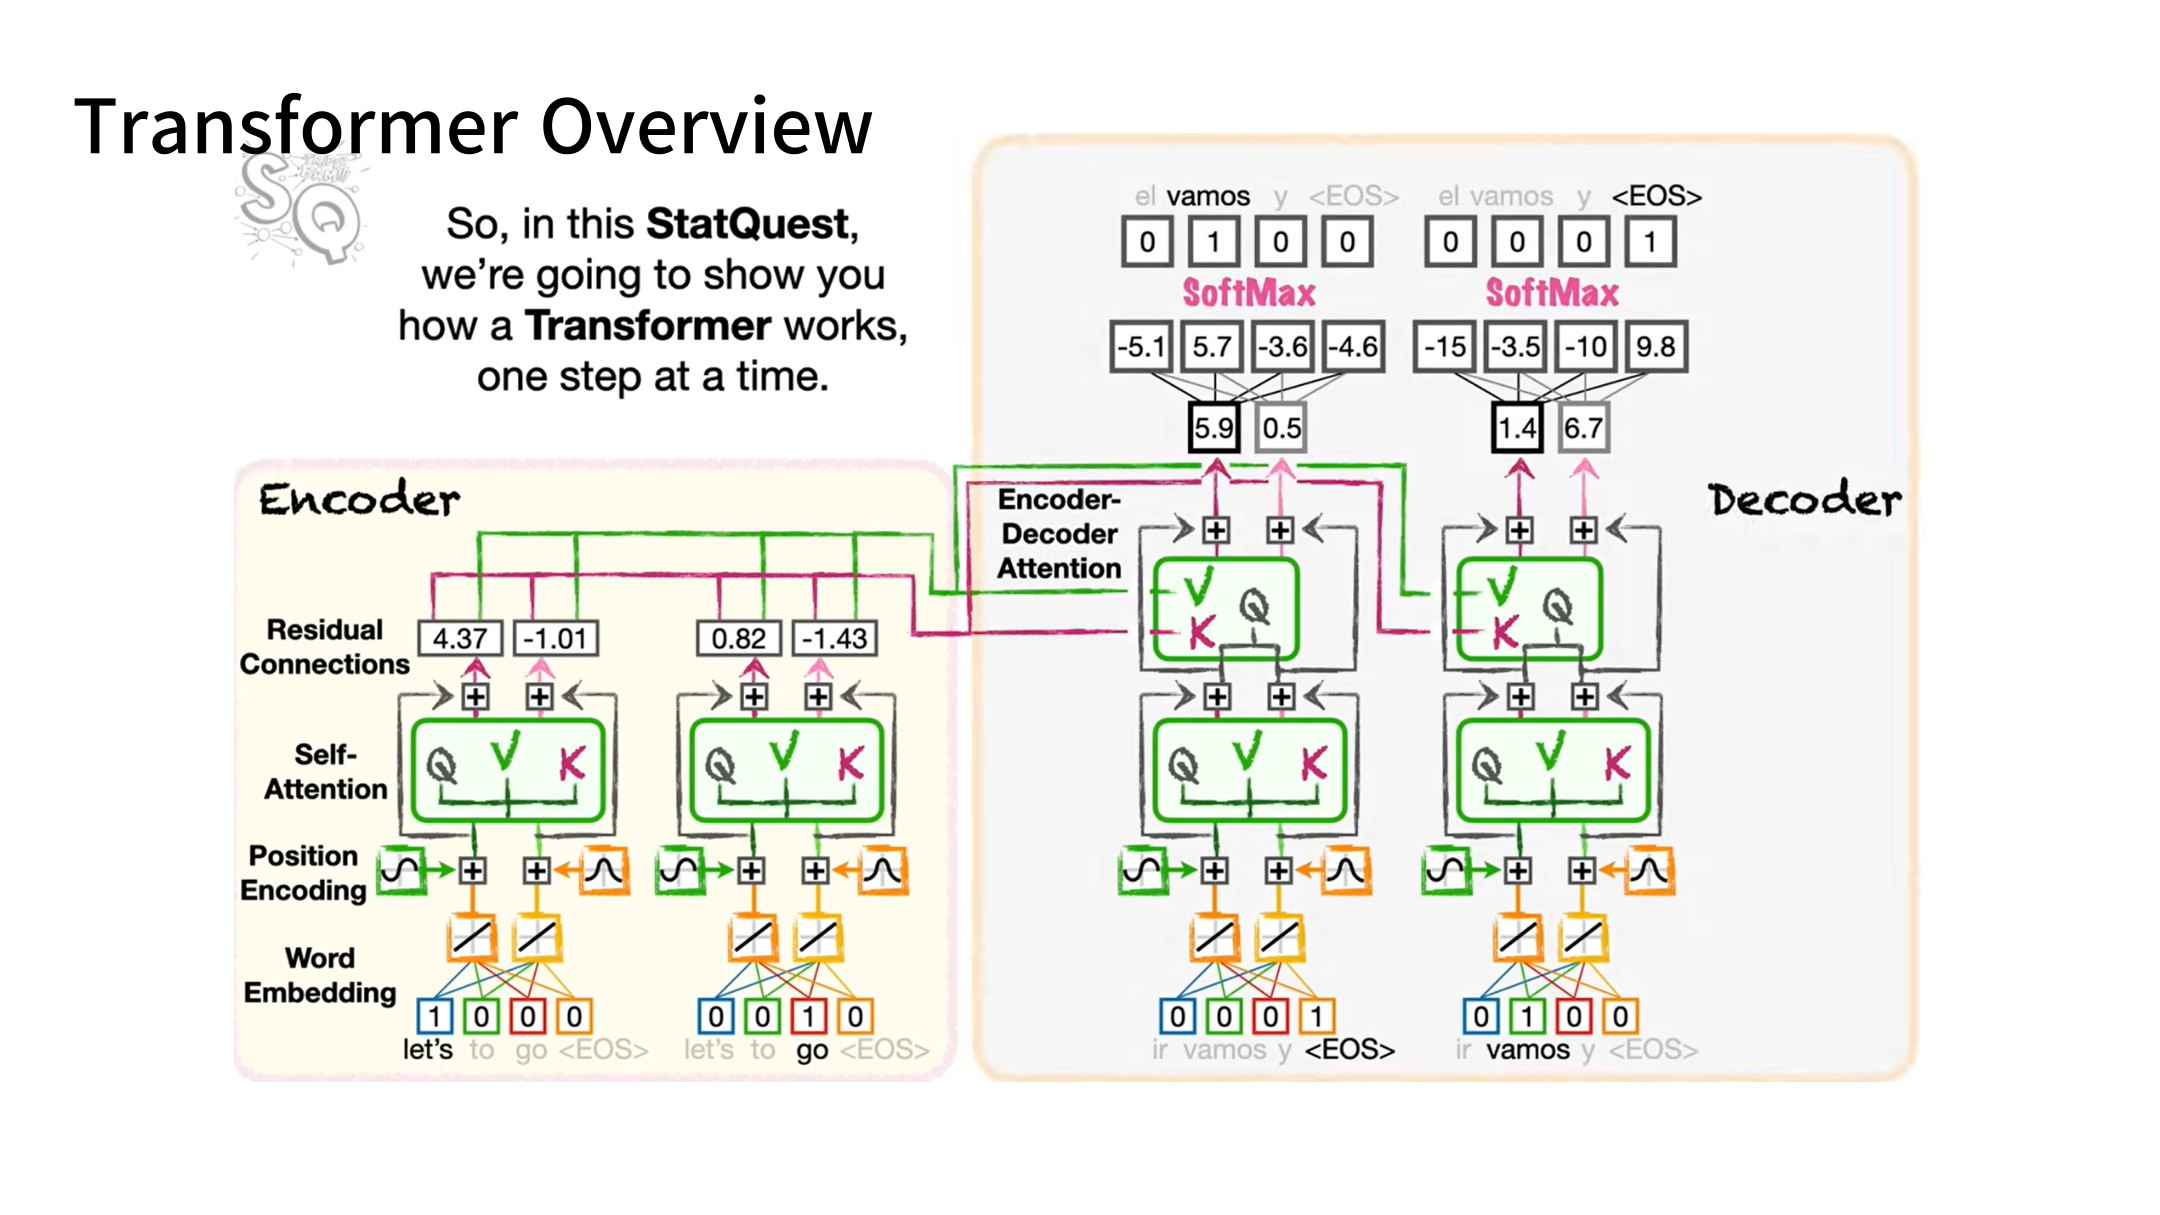
Encoder는 입력 문장의 표현을 만들고, Decoder는 이미 주어진 출력 토큰과 Encoder의 정보를 참고해 다음 토큰을 예측합니다. 그림은 계산 흐름을 보여주기 위한 단순화된 구조입니다.
Slide 20: Word Embedding
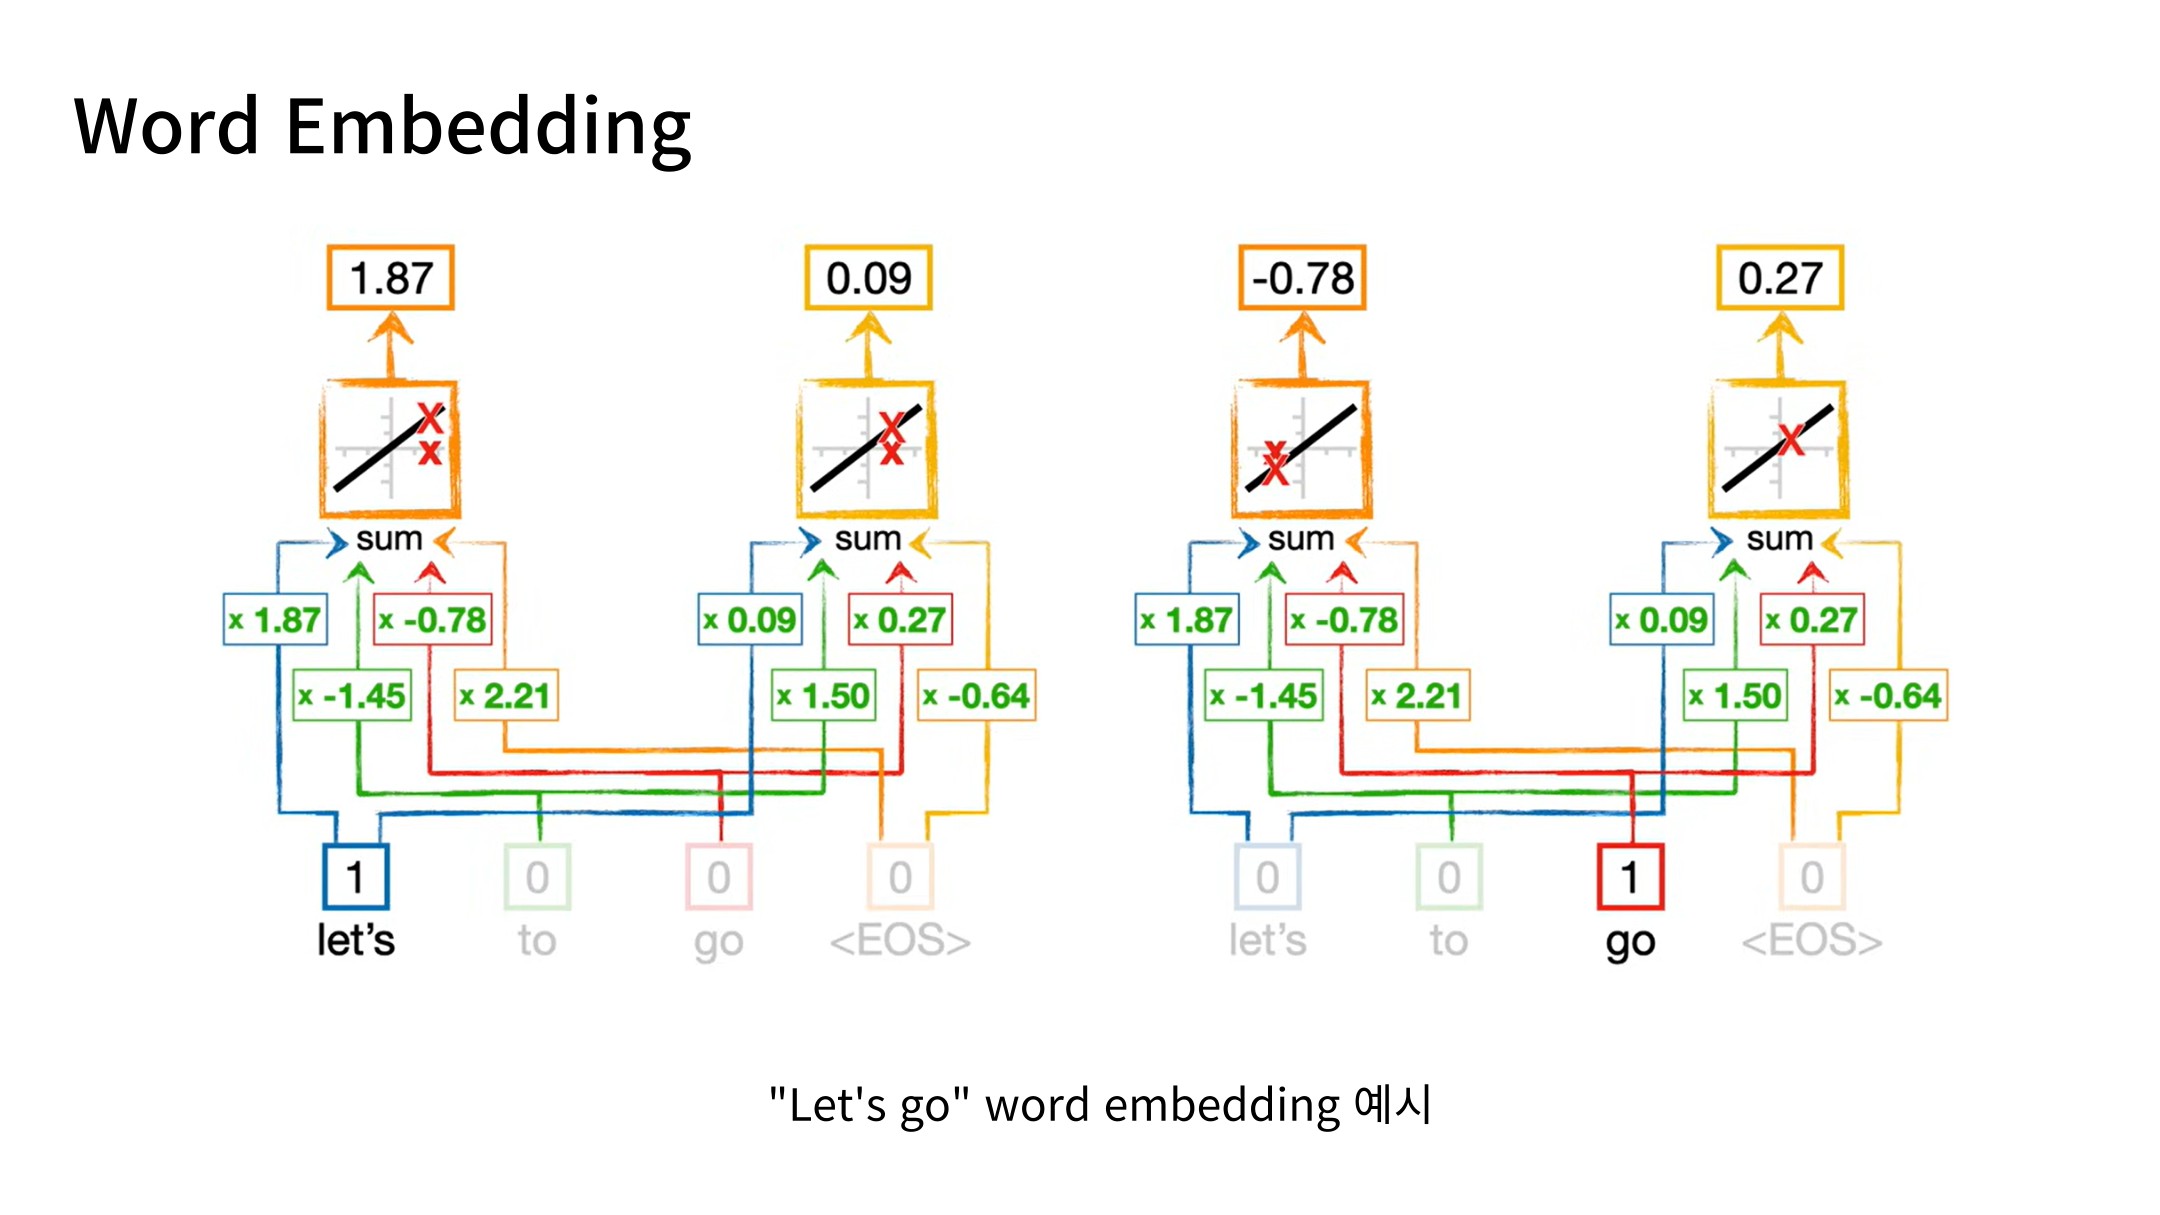
각 토큰을 학습 가능한 실수 벡터로 변환합니다. One-hot 벡터에 Embedding 행렬을 곱하는 것은 해당 토큰에 대응하는 행 또는 열을 선택하는 것과 같습니다.
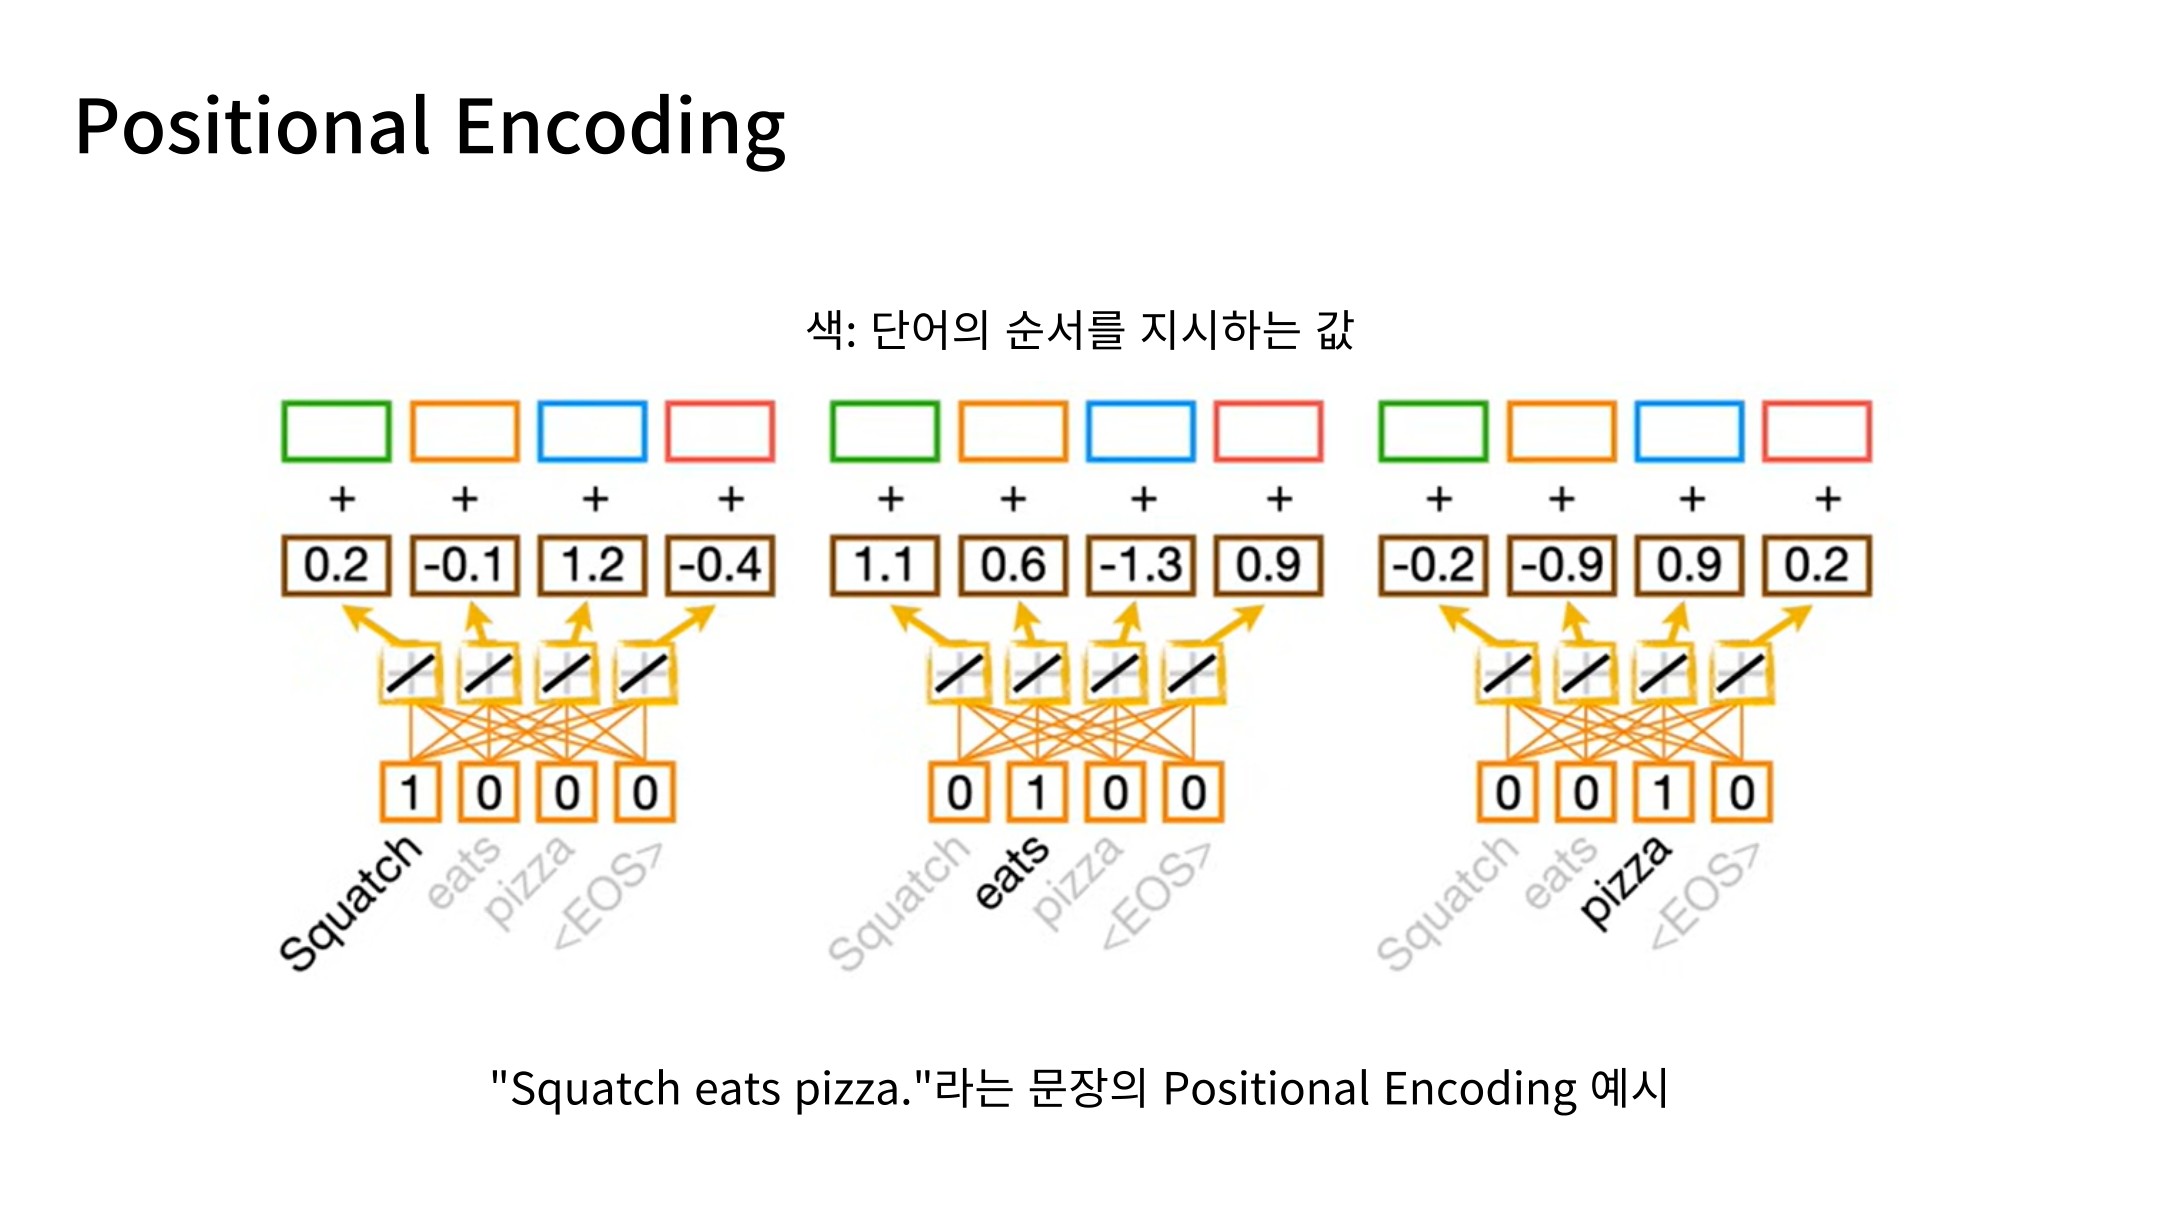
Slide 21: Positional Encoding의 필요성
순수한 Self-Attention 연산만으로는 토큰의 위치를 구분할 수 없습니다. 따라서 토큰 표현에 순서 정보를 더해 “누가 무엇을 했는지”를 구별할 수 있도록 합니다.
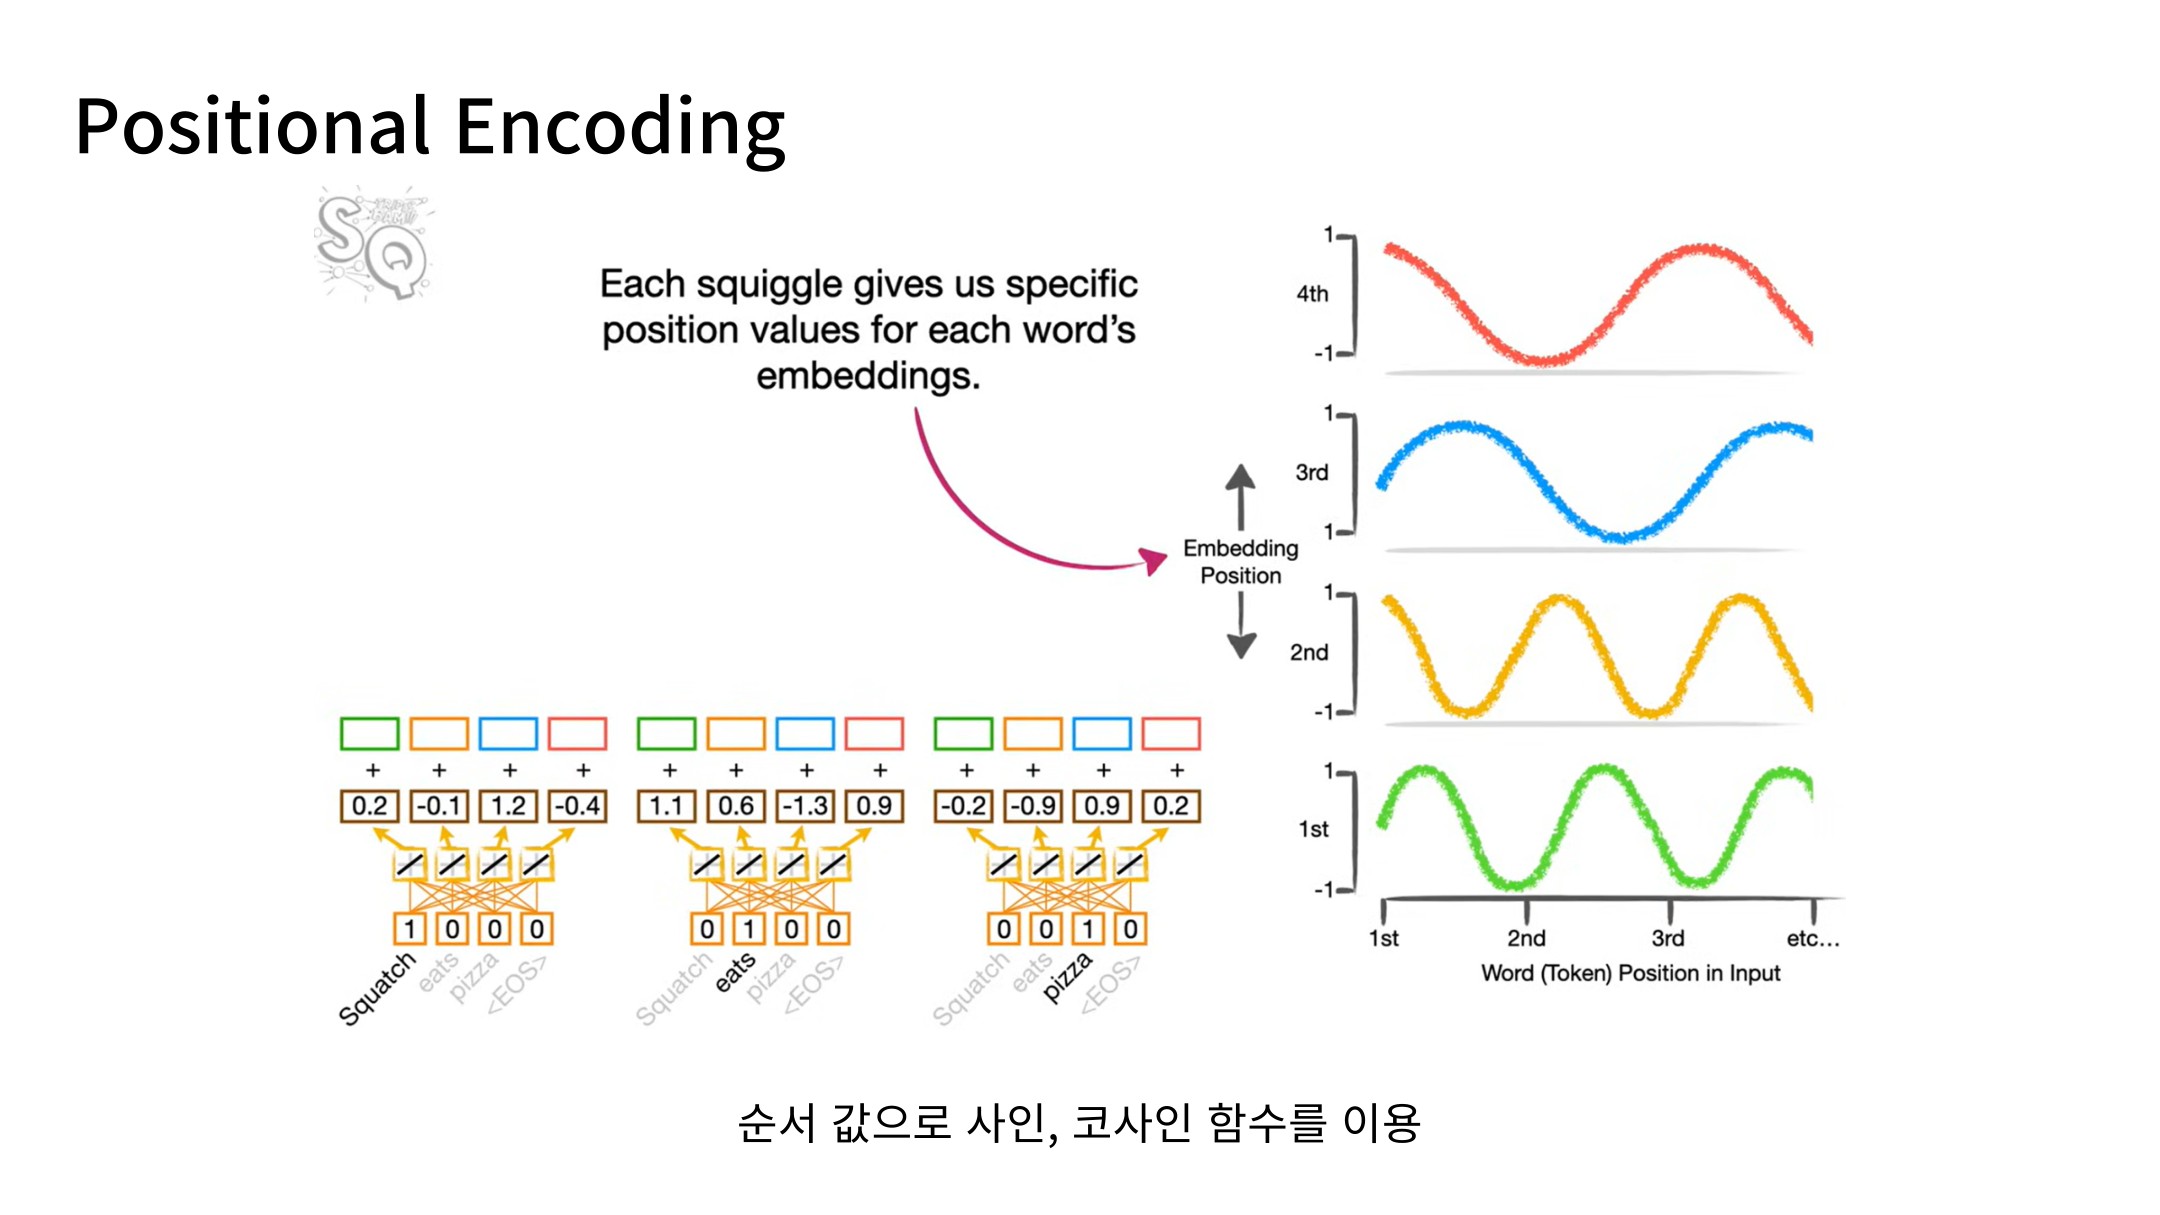
Slide 22: 사인·코사인 위치 인코딩
원래 Transformer는 서로 다른 주파수의 사인·코사인 함수를 이용해 위치 벡터를 구성합니다. 각 위치는 Embedding과 같은 차원의 위치 표현을 갖습니다.
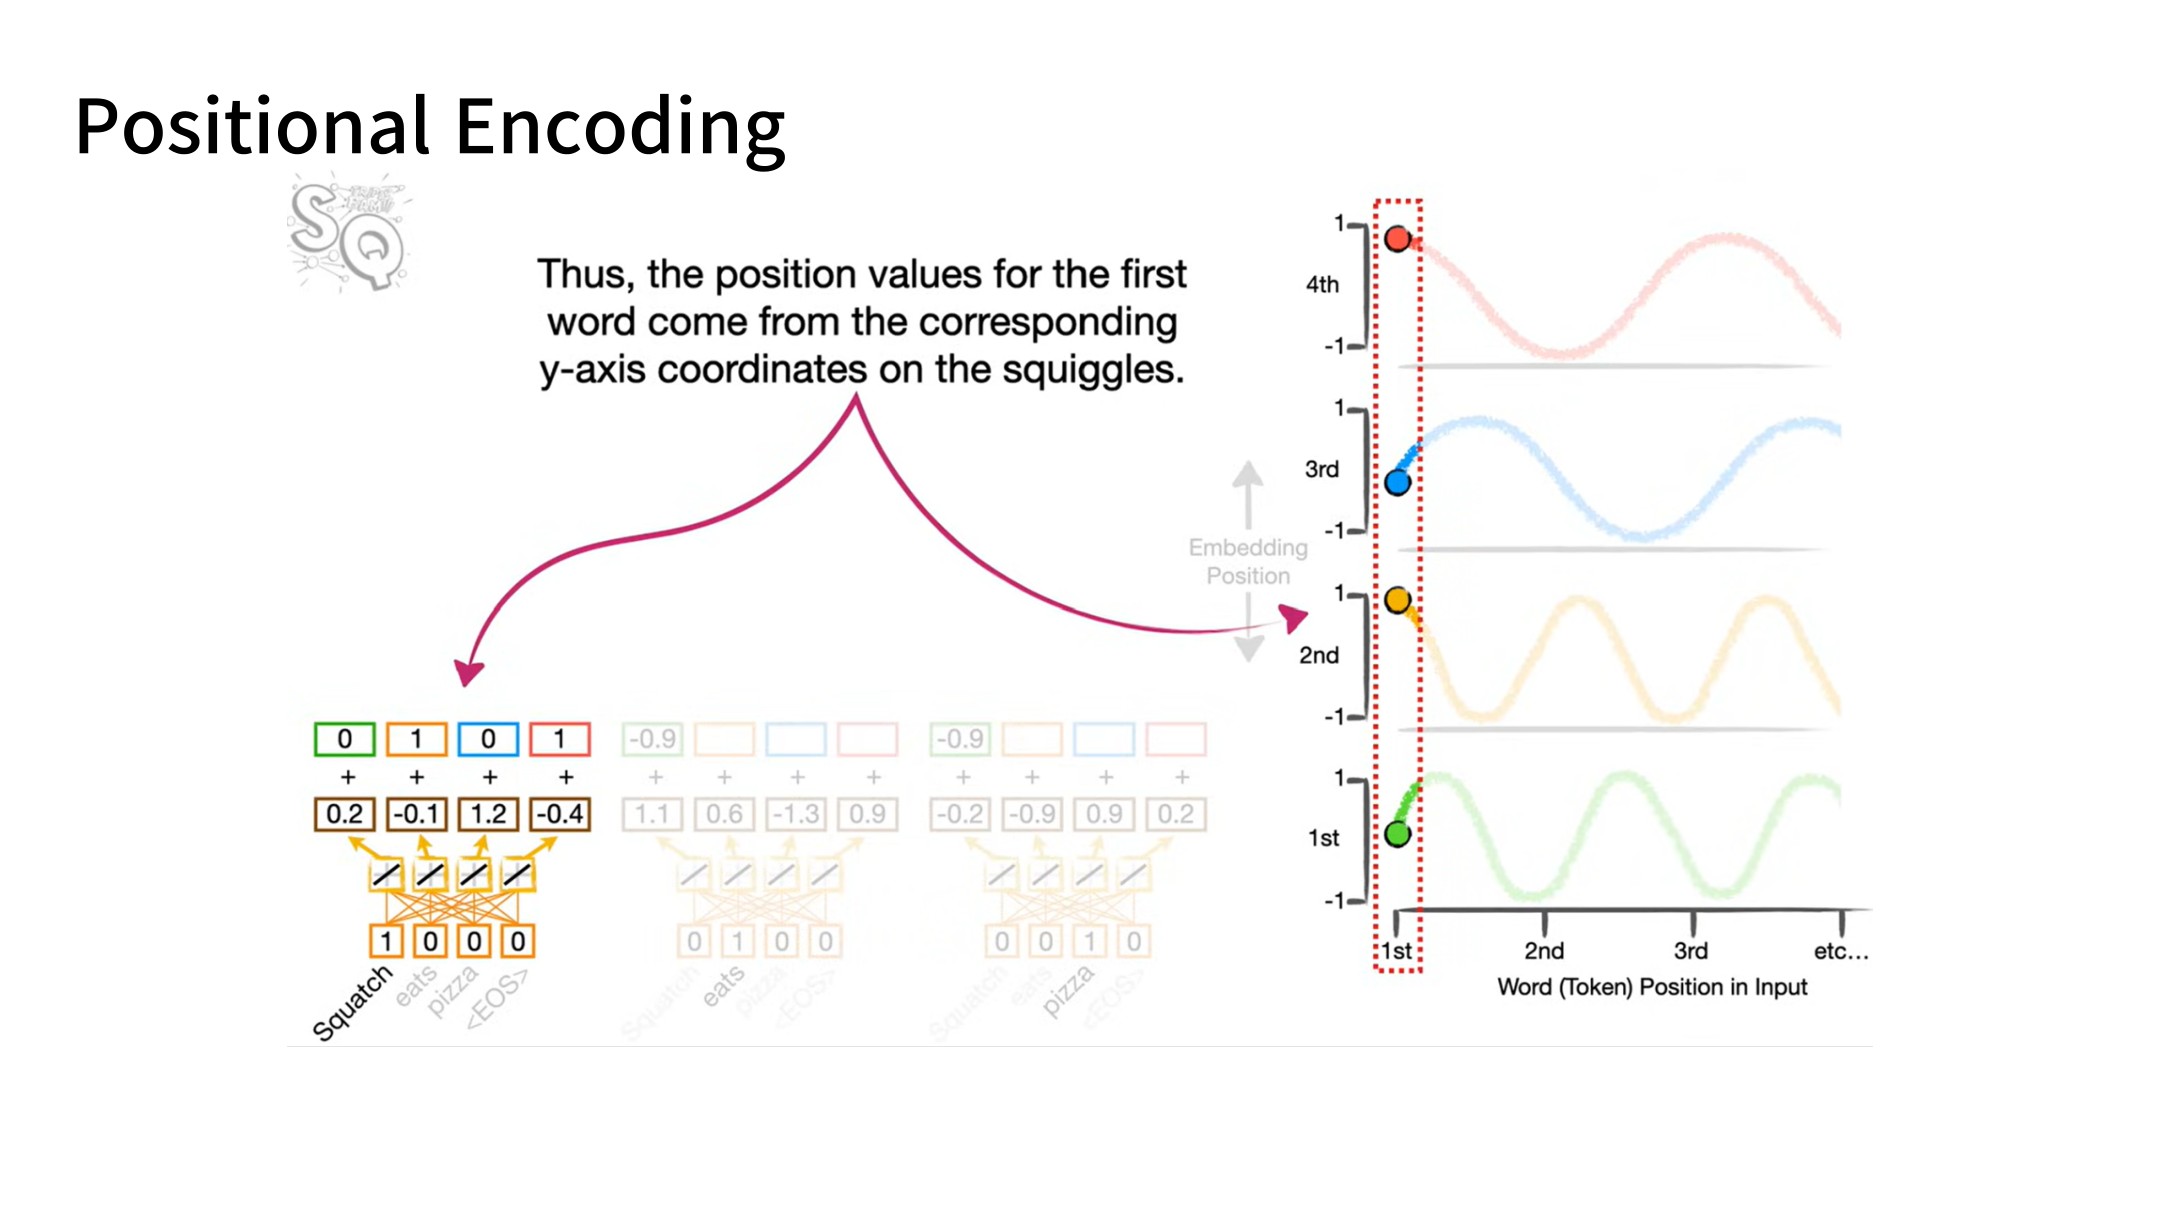
Slide 23: 첫 번째 위치의 표현
첫 번째 토큰의 위치에 해당하는 함수값들을 모아 위치 벡터를 만듭니다. 벡터의 각 성분은 서로 다른 주파수의 함수에서 얻습니다.
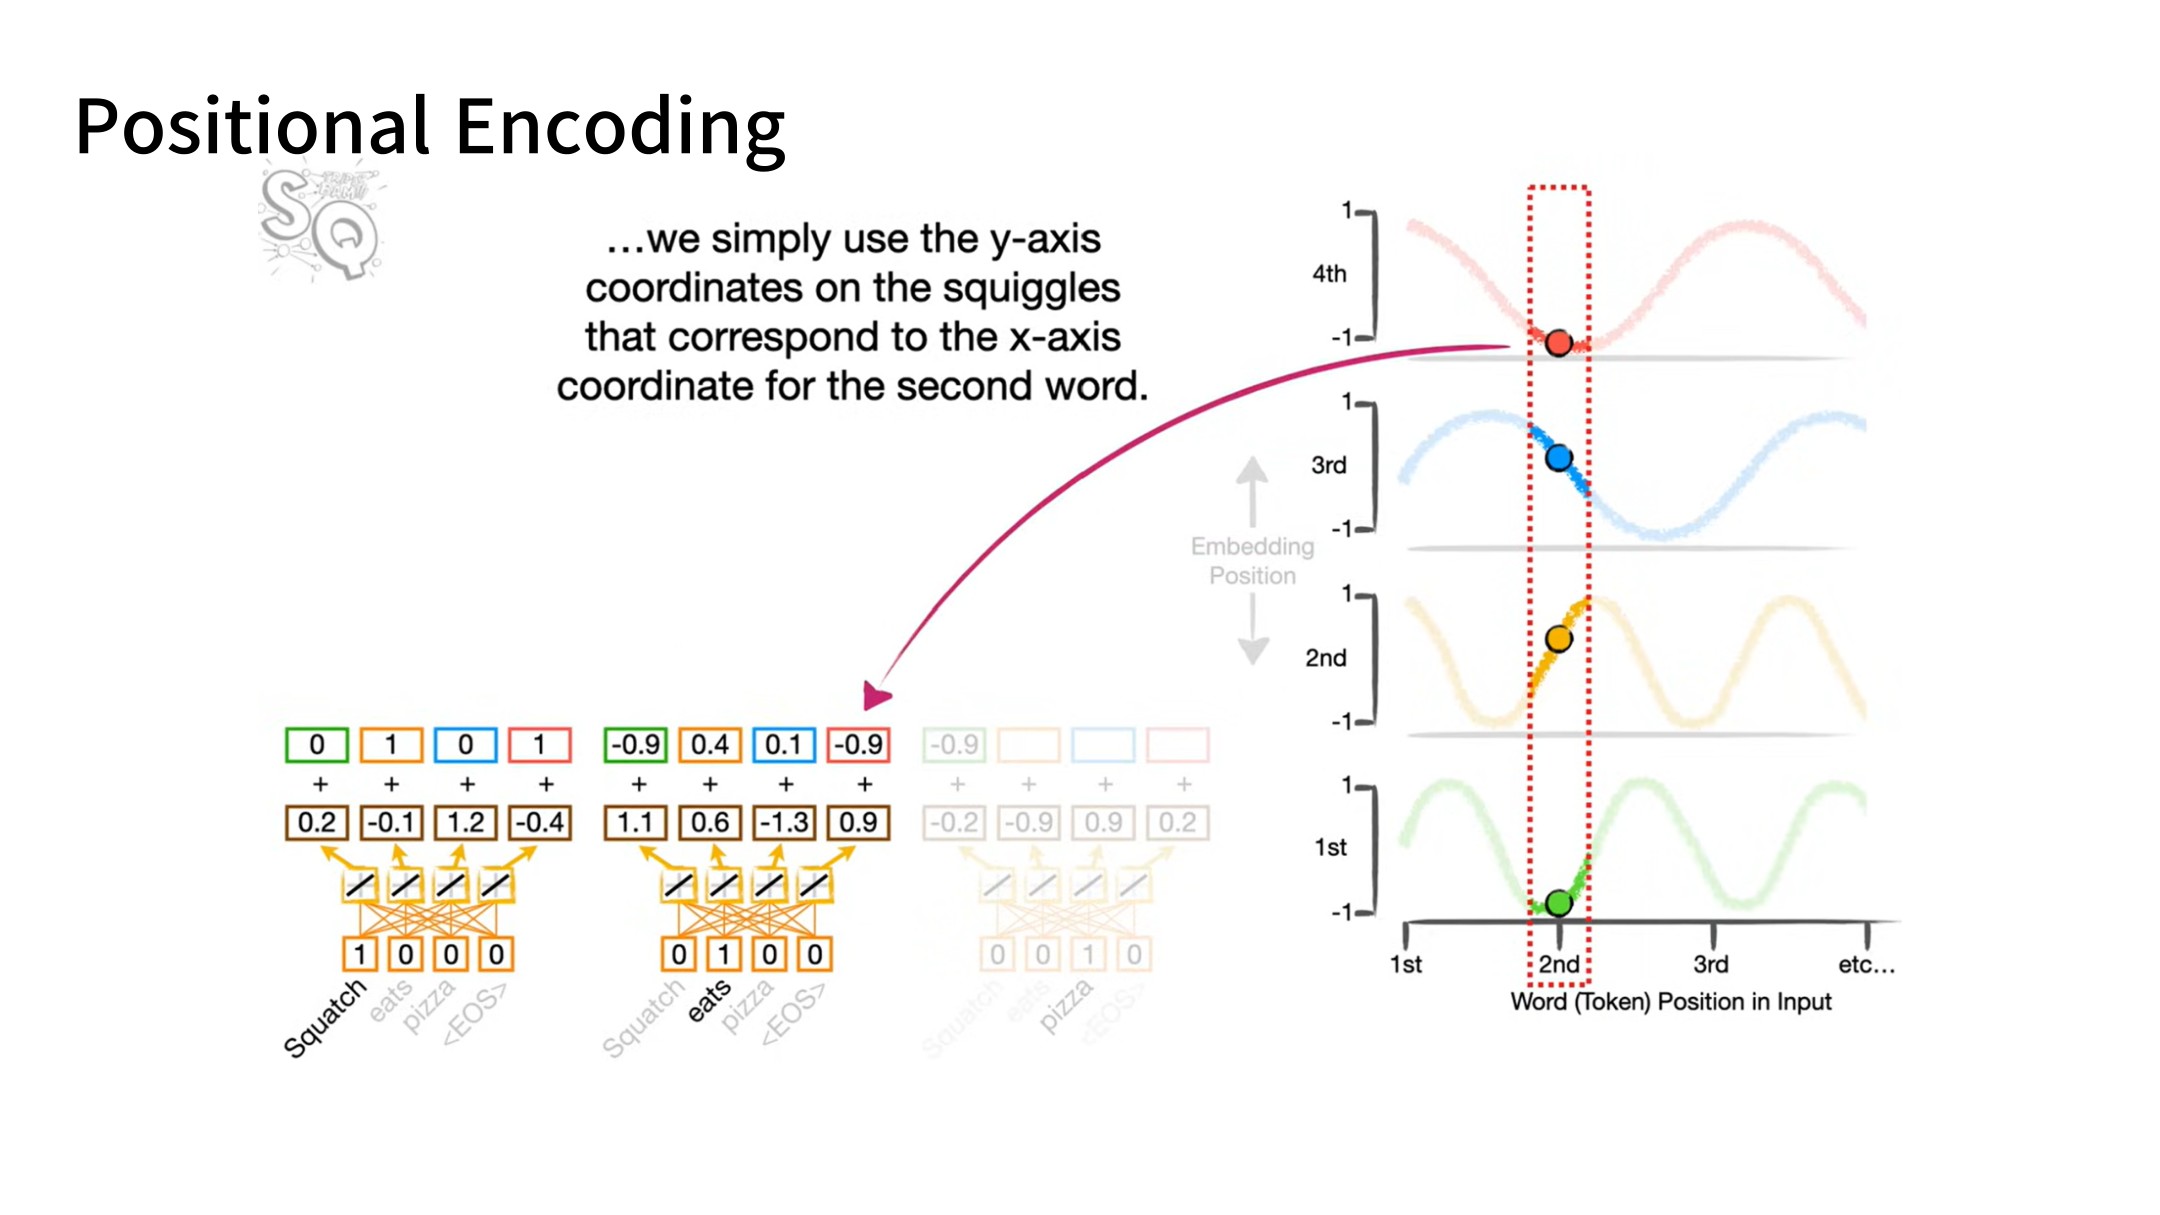
Slide 24: 두 번째 위치의 표현
두 번째 토큰에는 두 번째 위치의 함수값들을 사용합니다. 같은 단어라도 위치가 달라지면 더해지는 위치 벡터가 달라집니다.
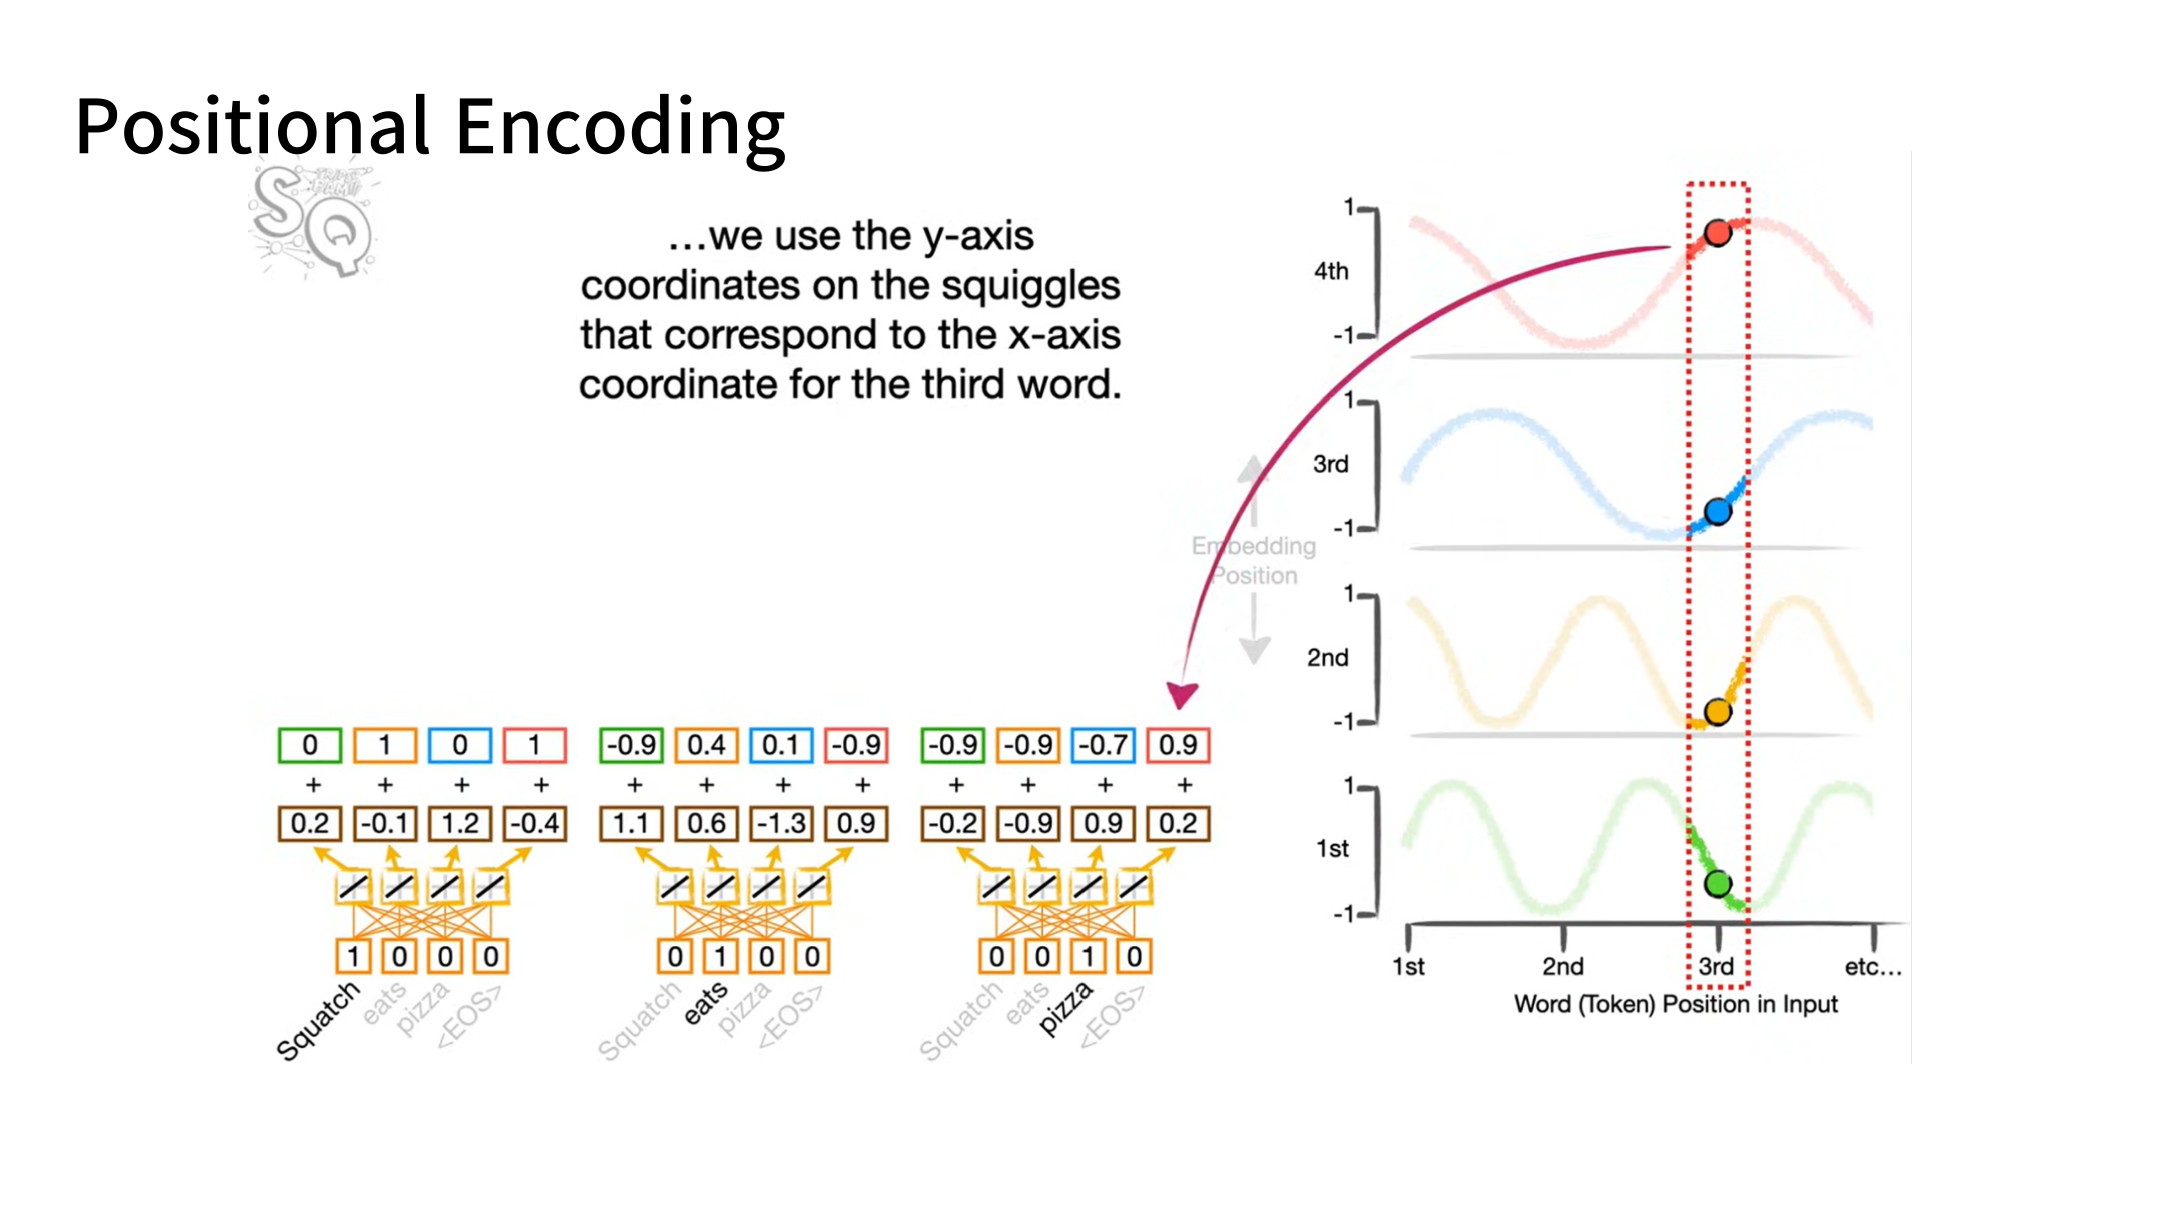
Slide 25: 세 번째 위치의 표현
세 번째 토큰도 같은 규칙으로 위치 벡터를 얻습니다. 모든 위치에 동일한 함수 체계를 적용하되, 위치 좌표가 달라집니다.
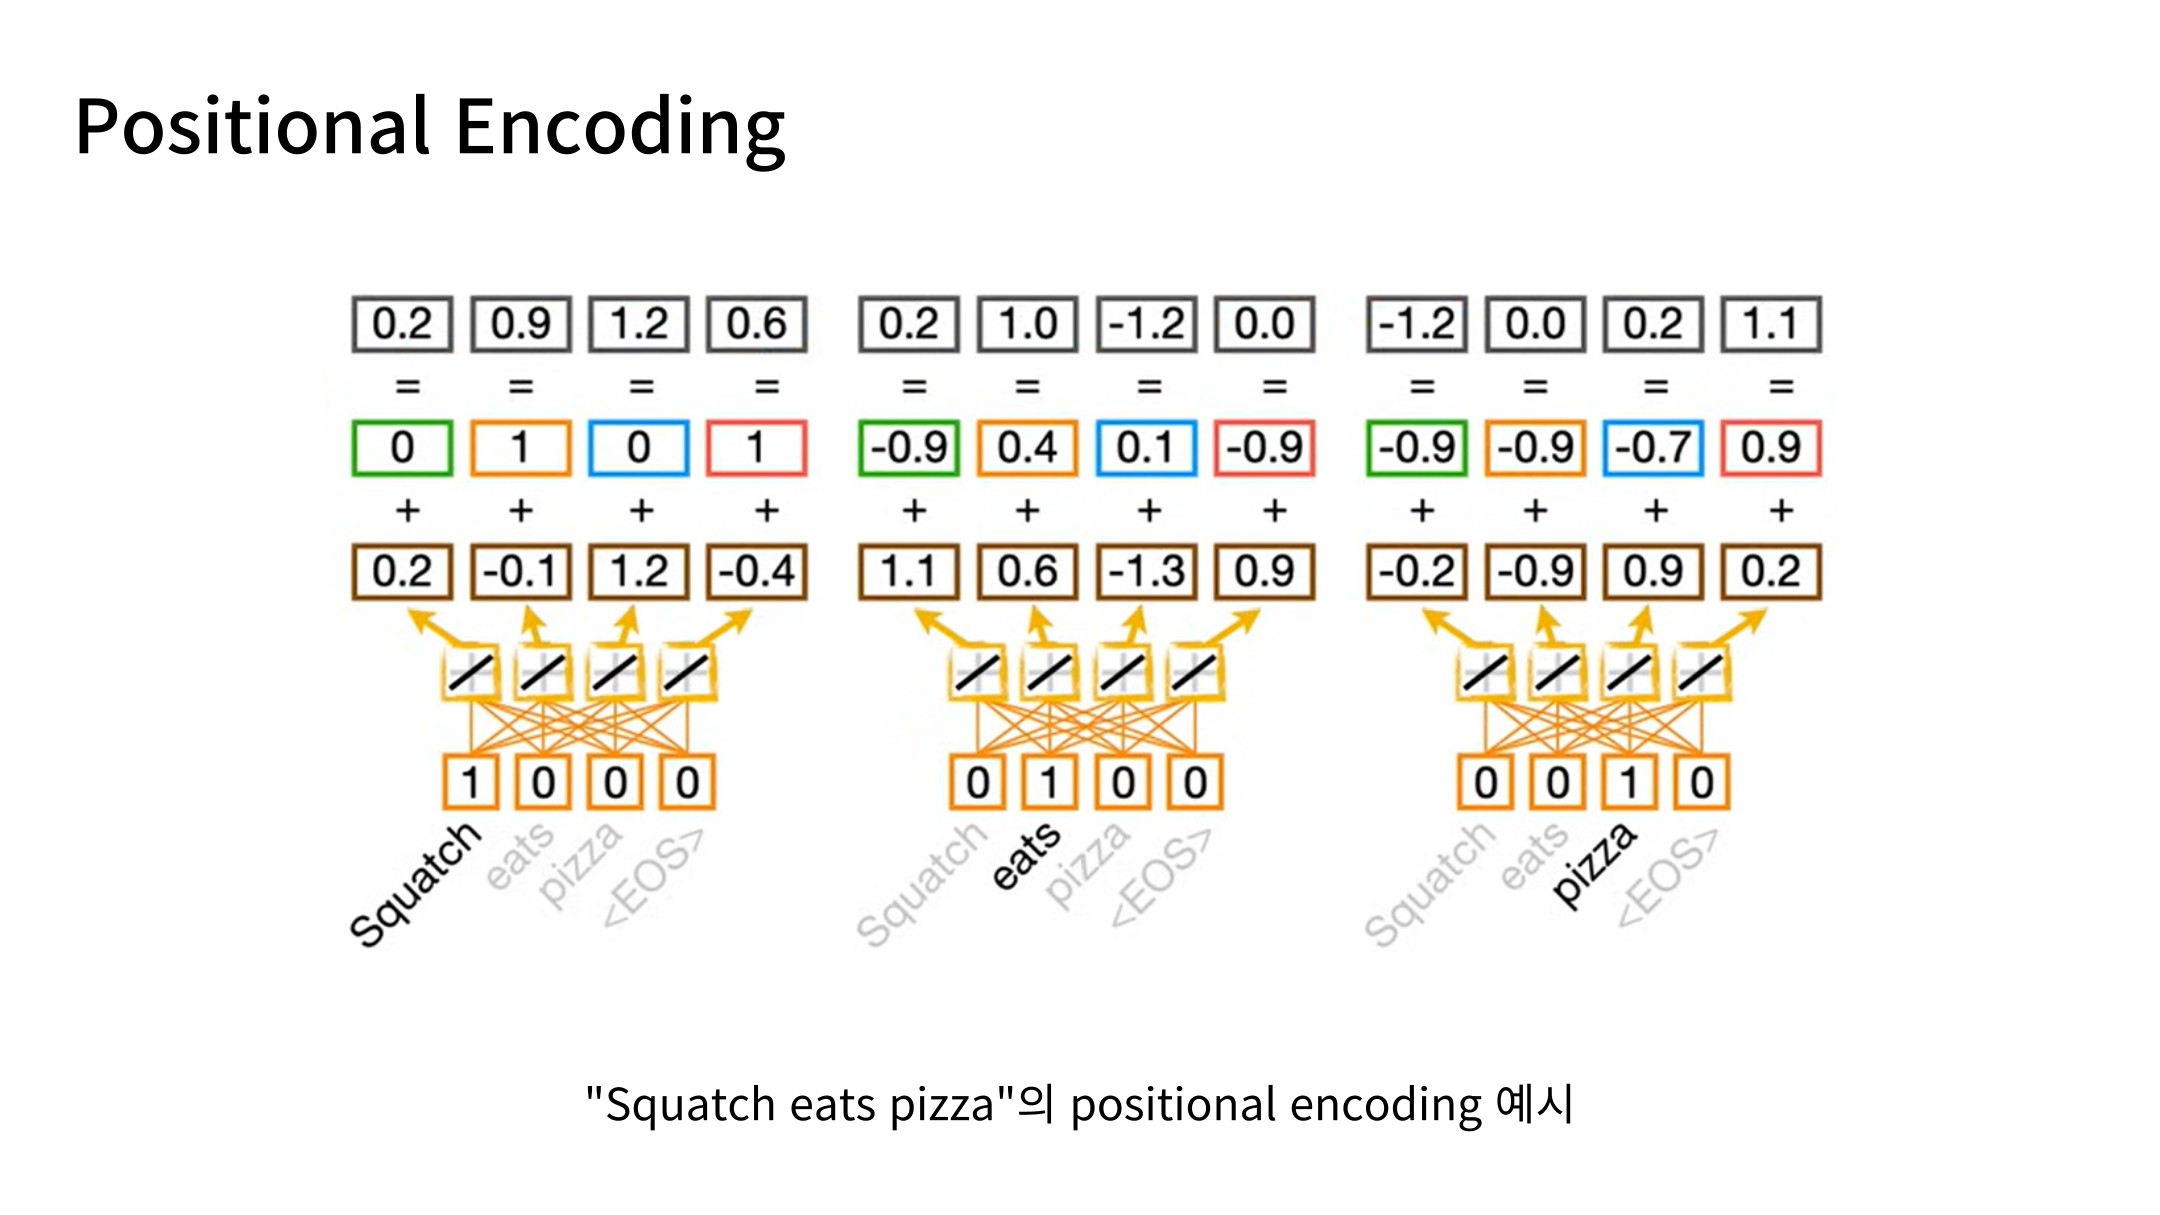
Slide 26: Embedding과 위치 정보의 합
단어 Embedding과 Positional Encoding을 성분별로 더합니다. 이 합이 Attention에 입력되어 단어의 내용과 위치 정보를 함께 전달합니다.
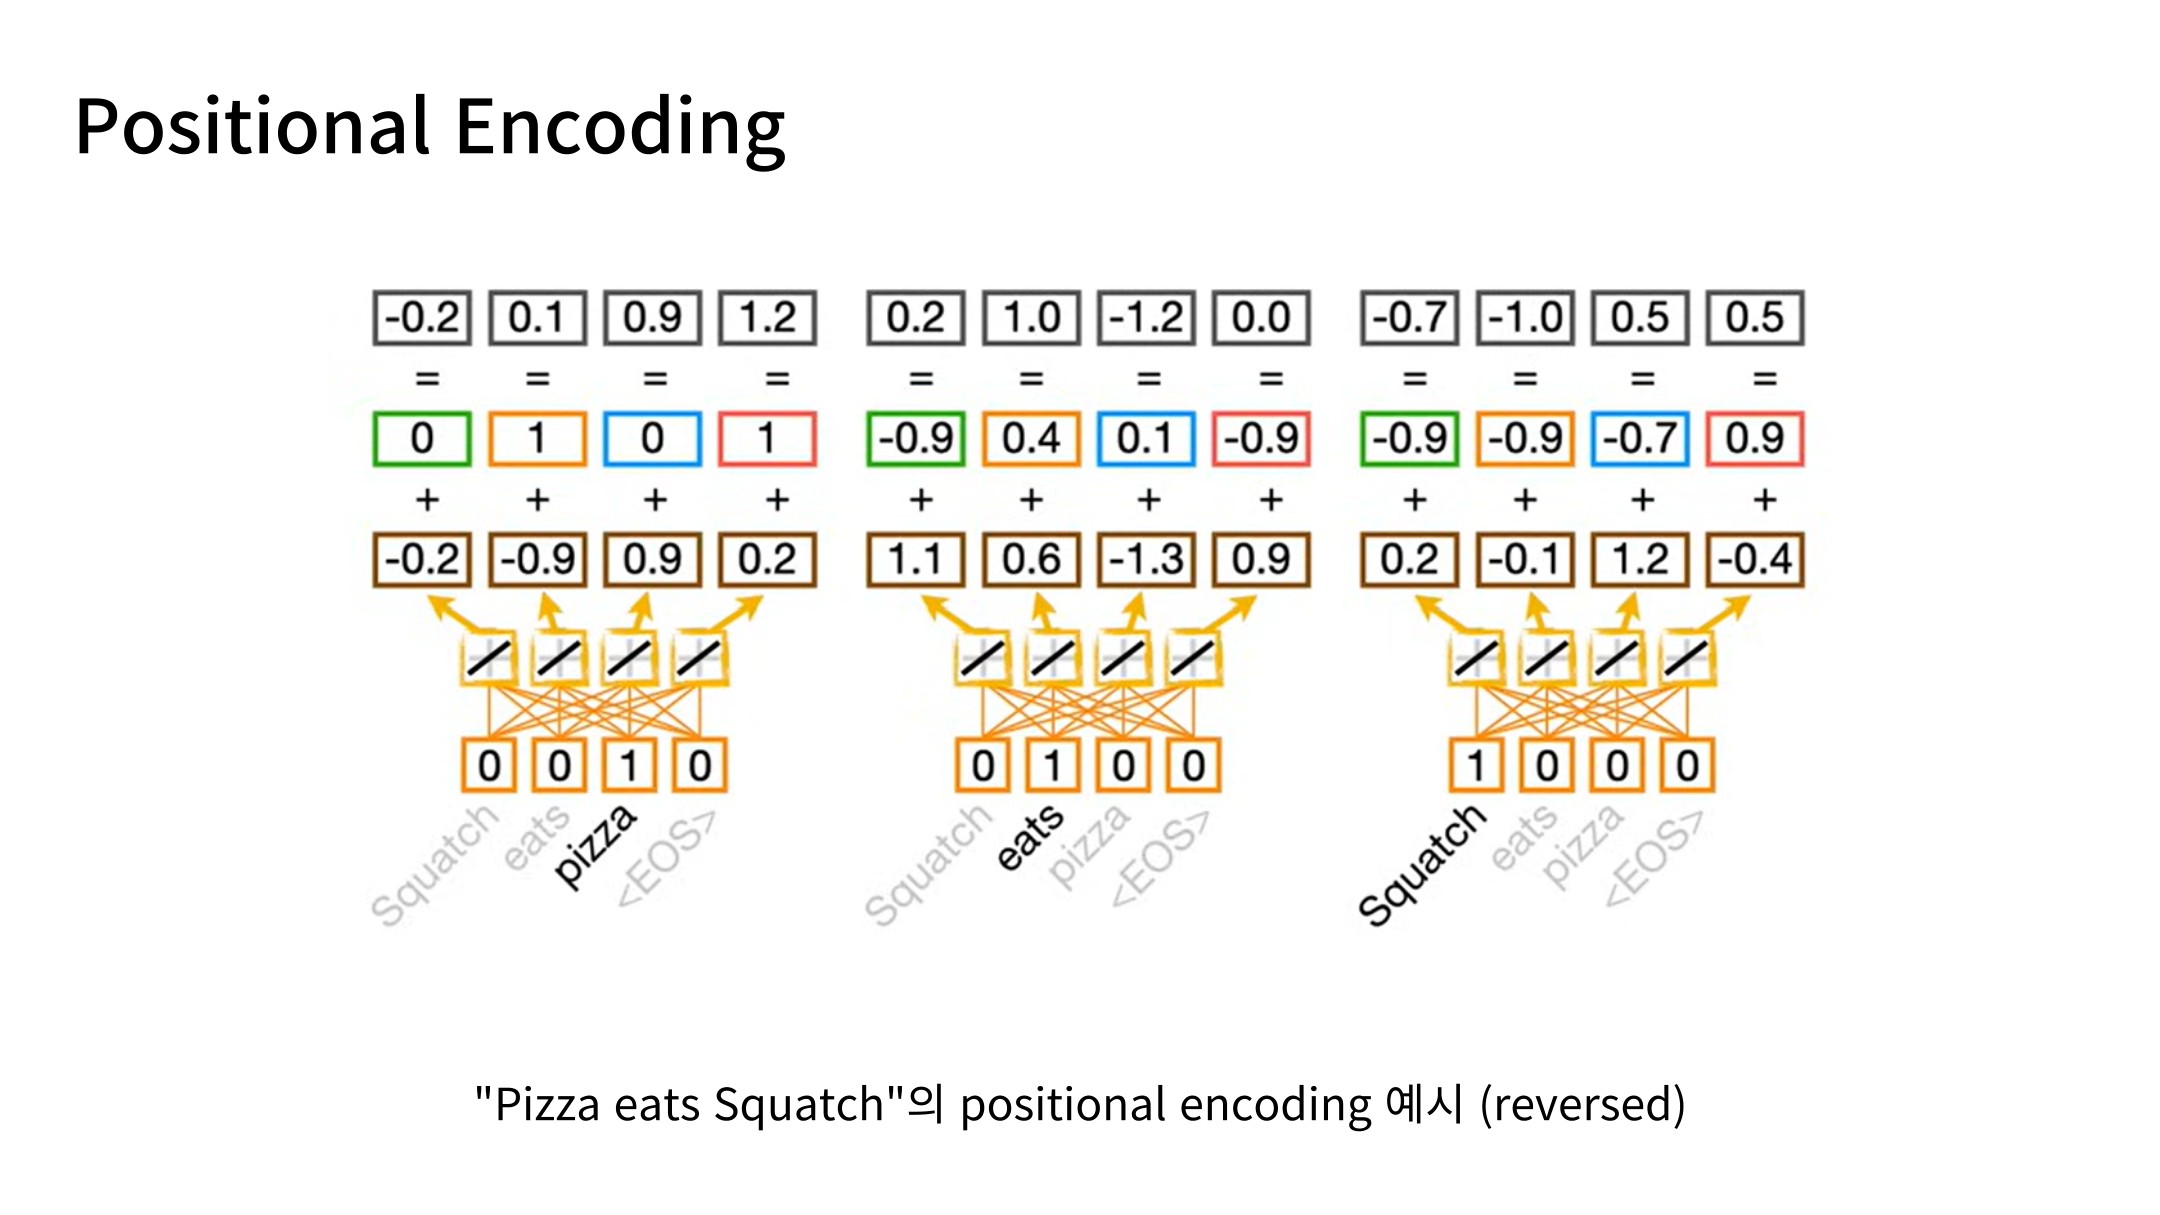
Slide 27: 단어 순서가 달라질 때
“Squatch eats pizza”와 “Pizza eats Squatch”는 같은 단어를 포함해도 의미가 다릅니다. 각 단어에 결합하는 위치 벡터가 달라지므로 입력 표현도 달라집니다.
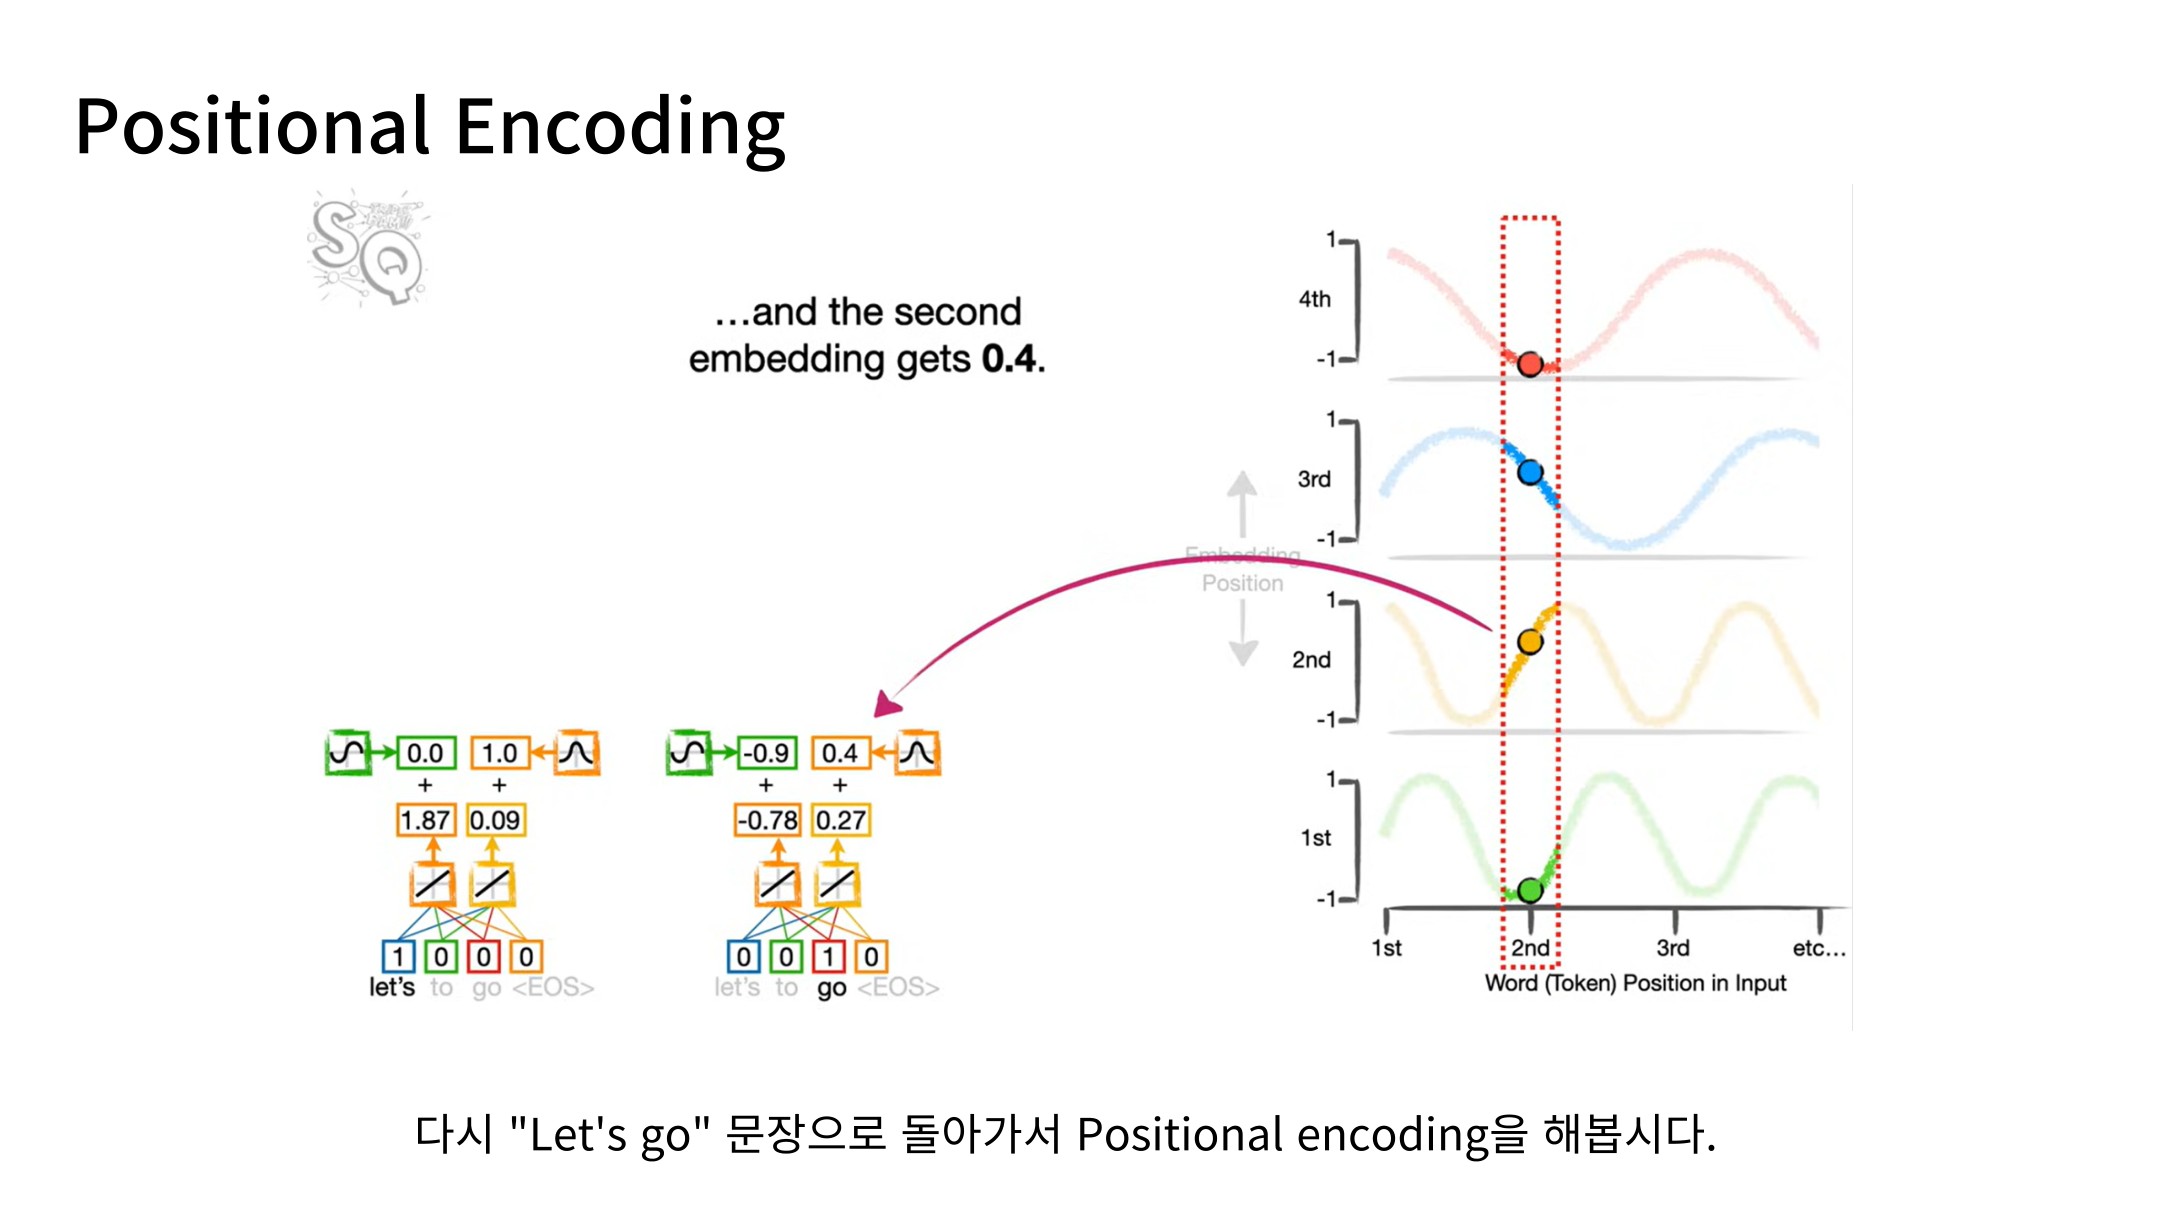
Slide 28: 번역 예시의 위치 인코딩
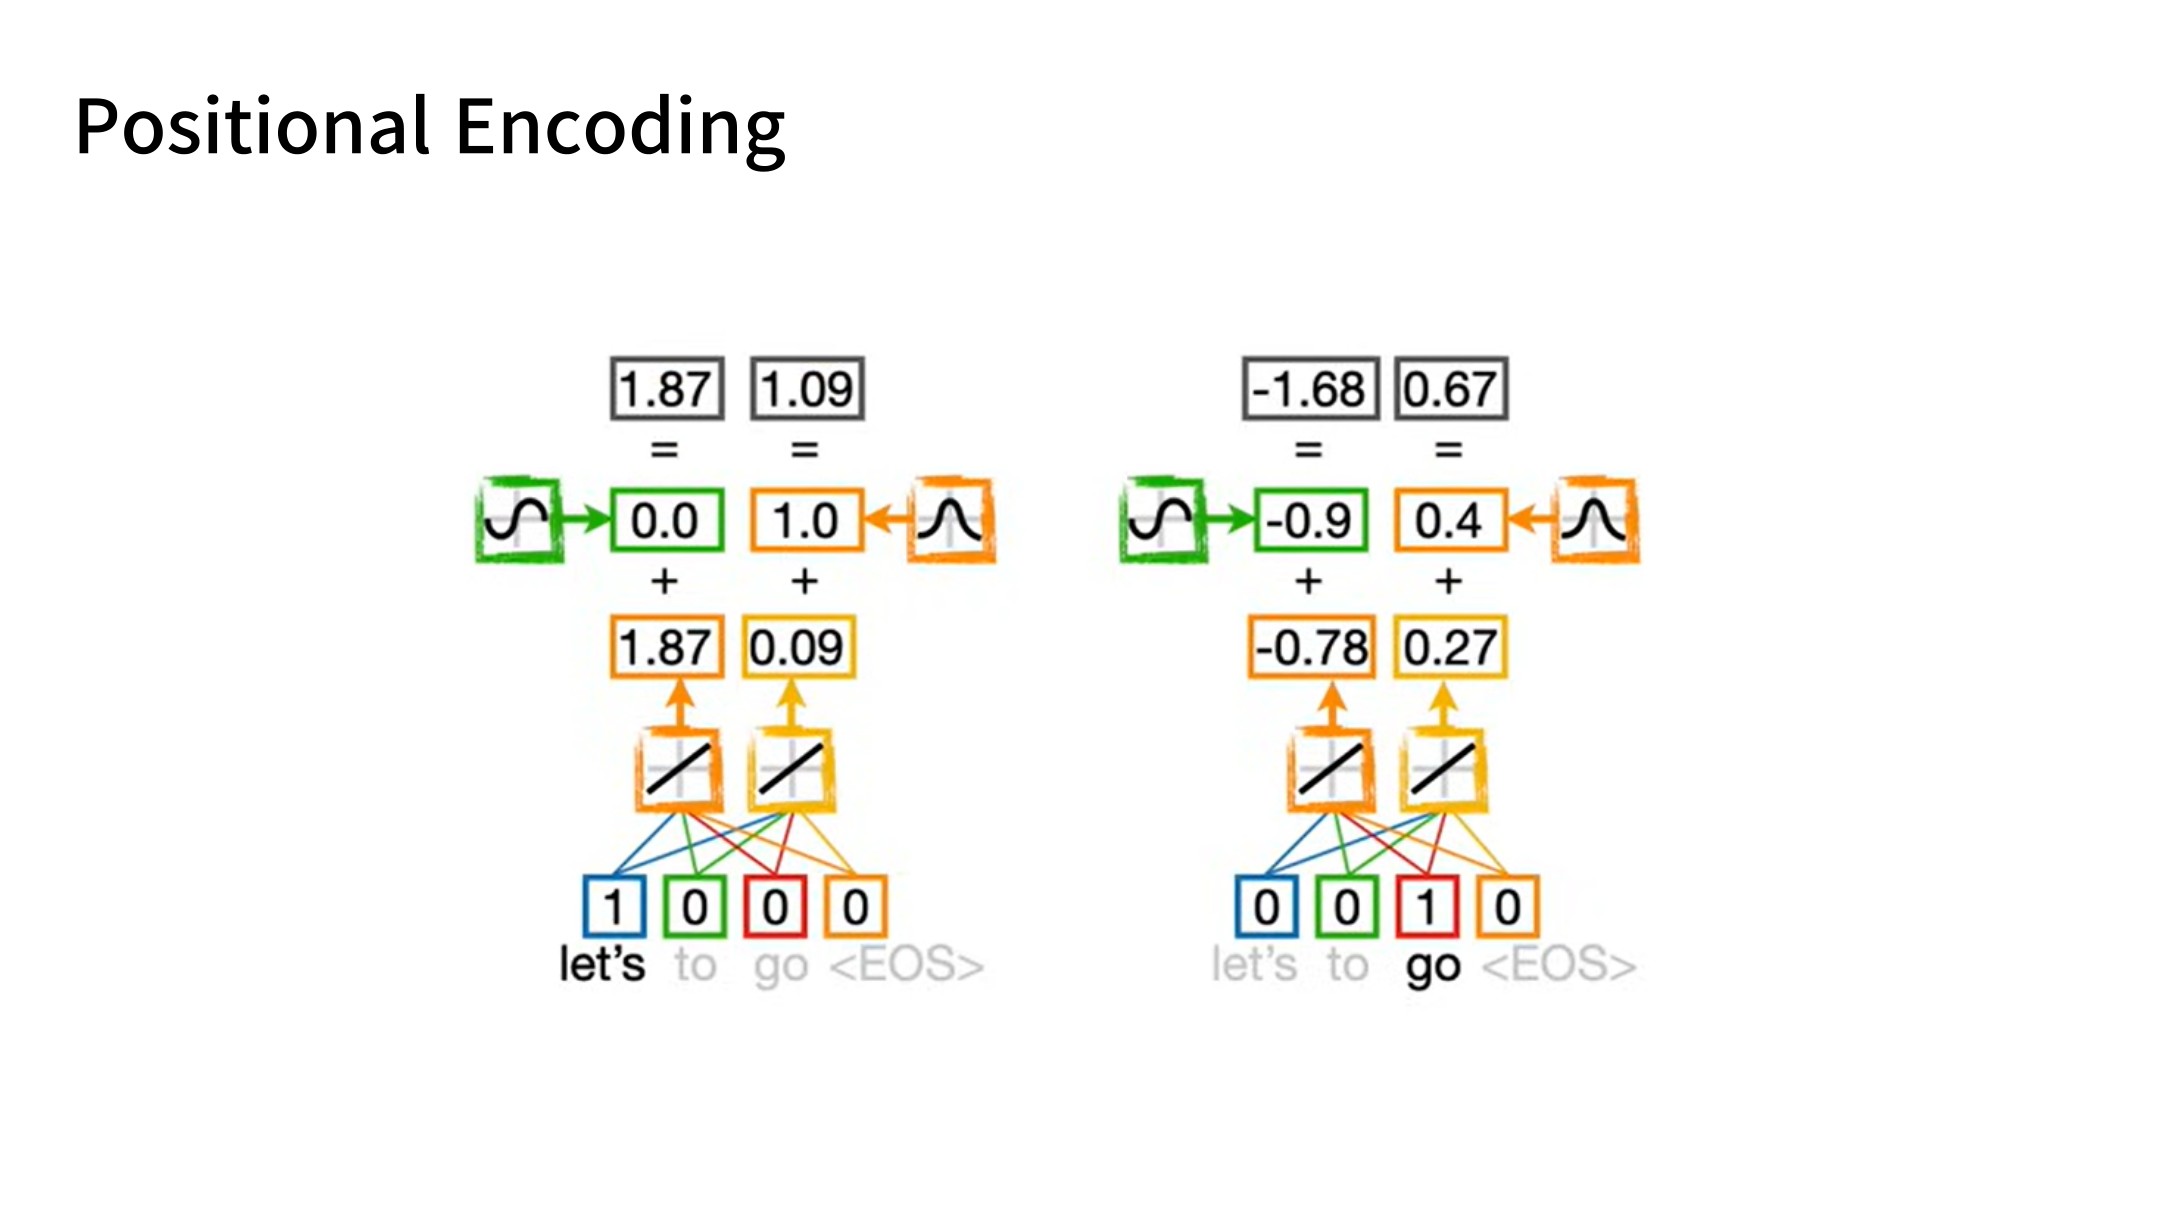
다시 “Let’s go” 예시로 돌아와 위치 벡터를 구성합니다. 그림의 작은 차원은 계산을 보여주기 위한 예시입니다.
Slide 29: Attention에 들어갈 입력
각 토큰의 Embedding에 위치 정보를 더한 결과를 얻었습니다. 다음 단계에서는 이 표현을 선형 변환해 Query, Key, Value를 만듭니다.
Slide 30: Self-Attention
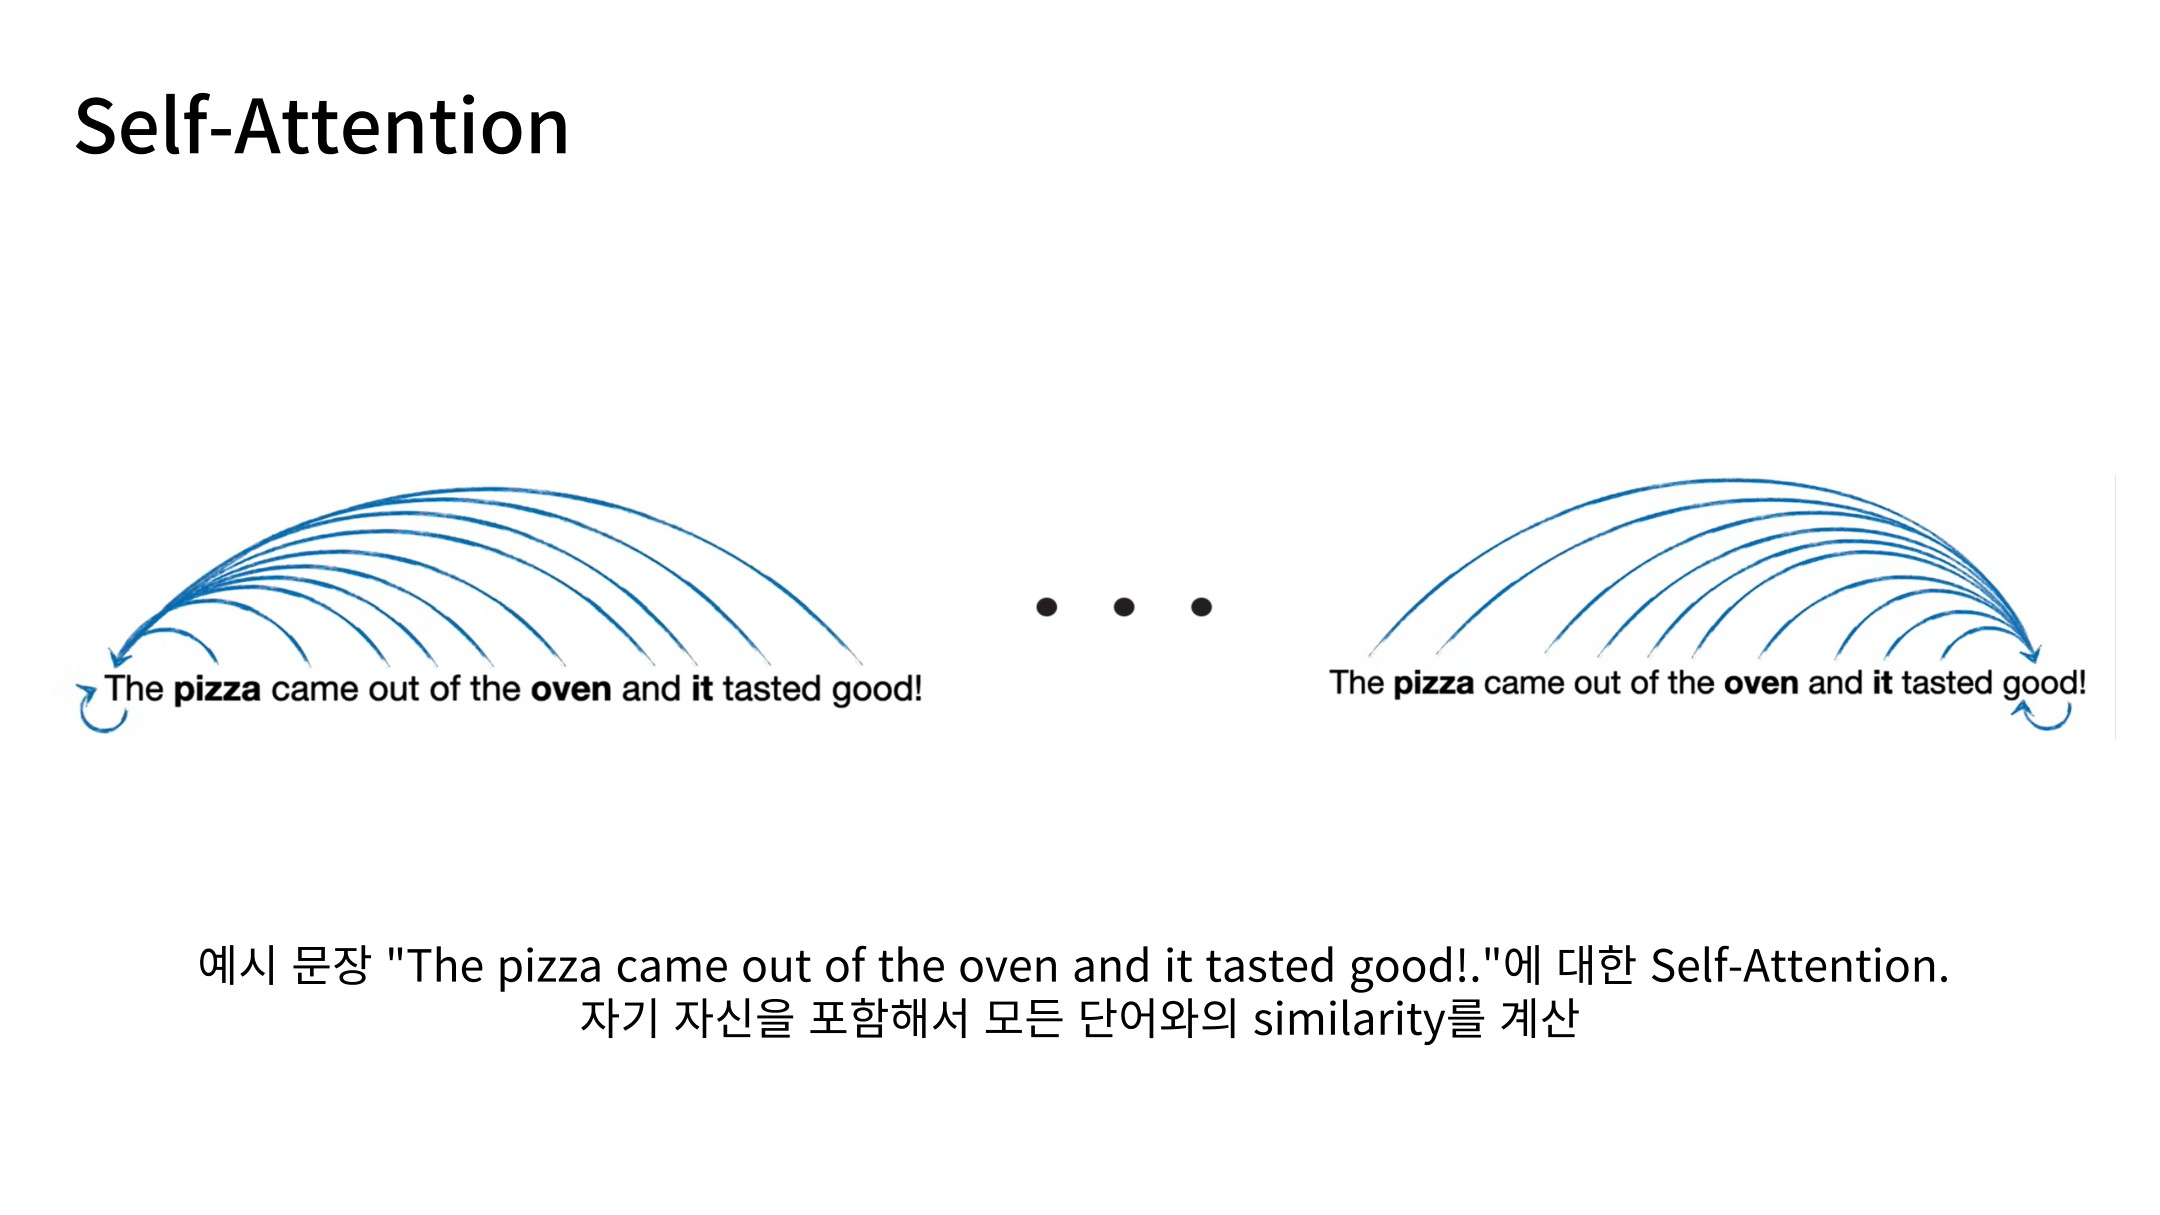
Self-Attention은 같은 시퀀스의 토큰들이 서로를 참조하는 연산입니다. 문장 속 “it”이 무엇을 가리키는지 이해하려면 다른 단어와의 관계가 필요합니다.
Slide 31: 문맥 속 단어 관계
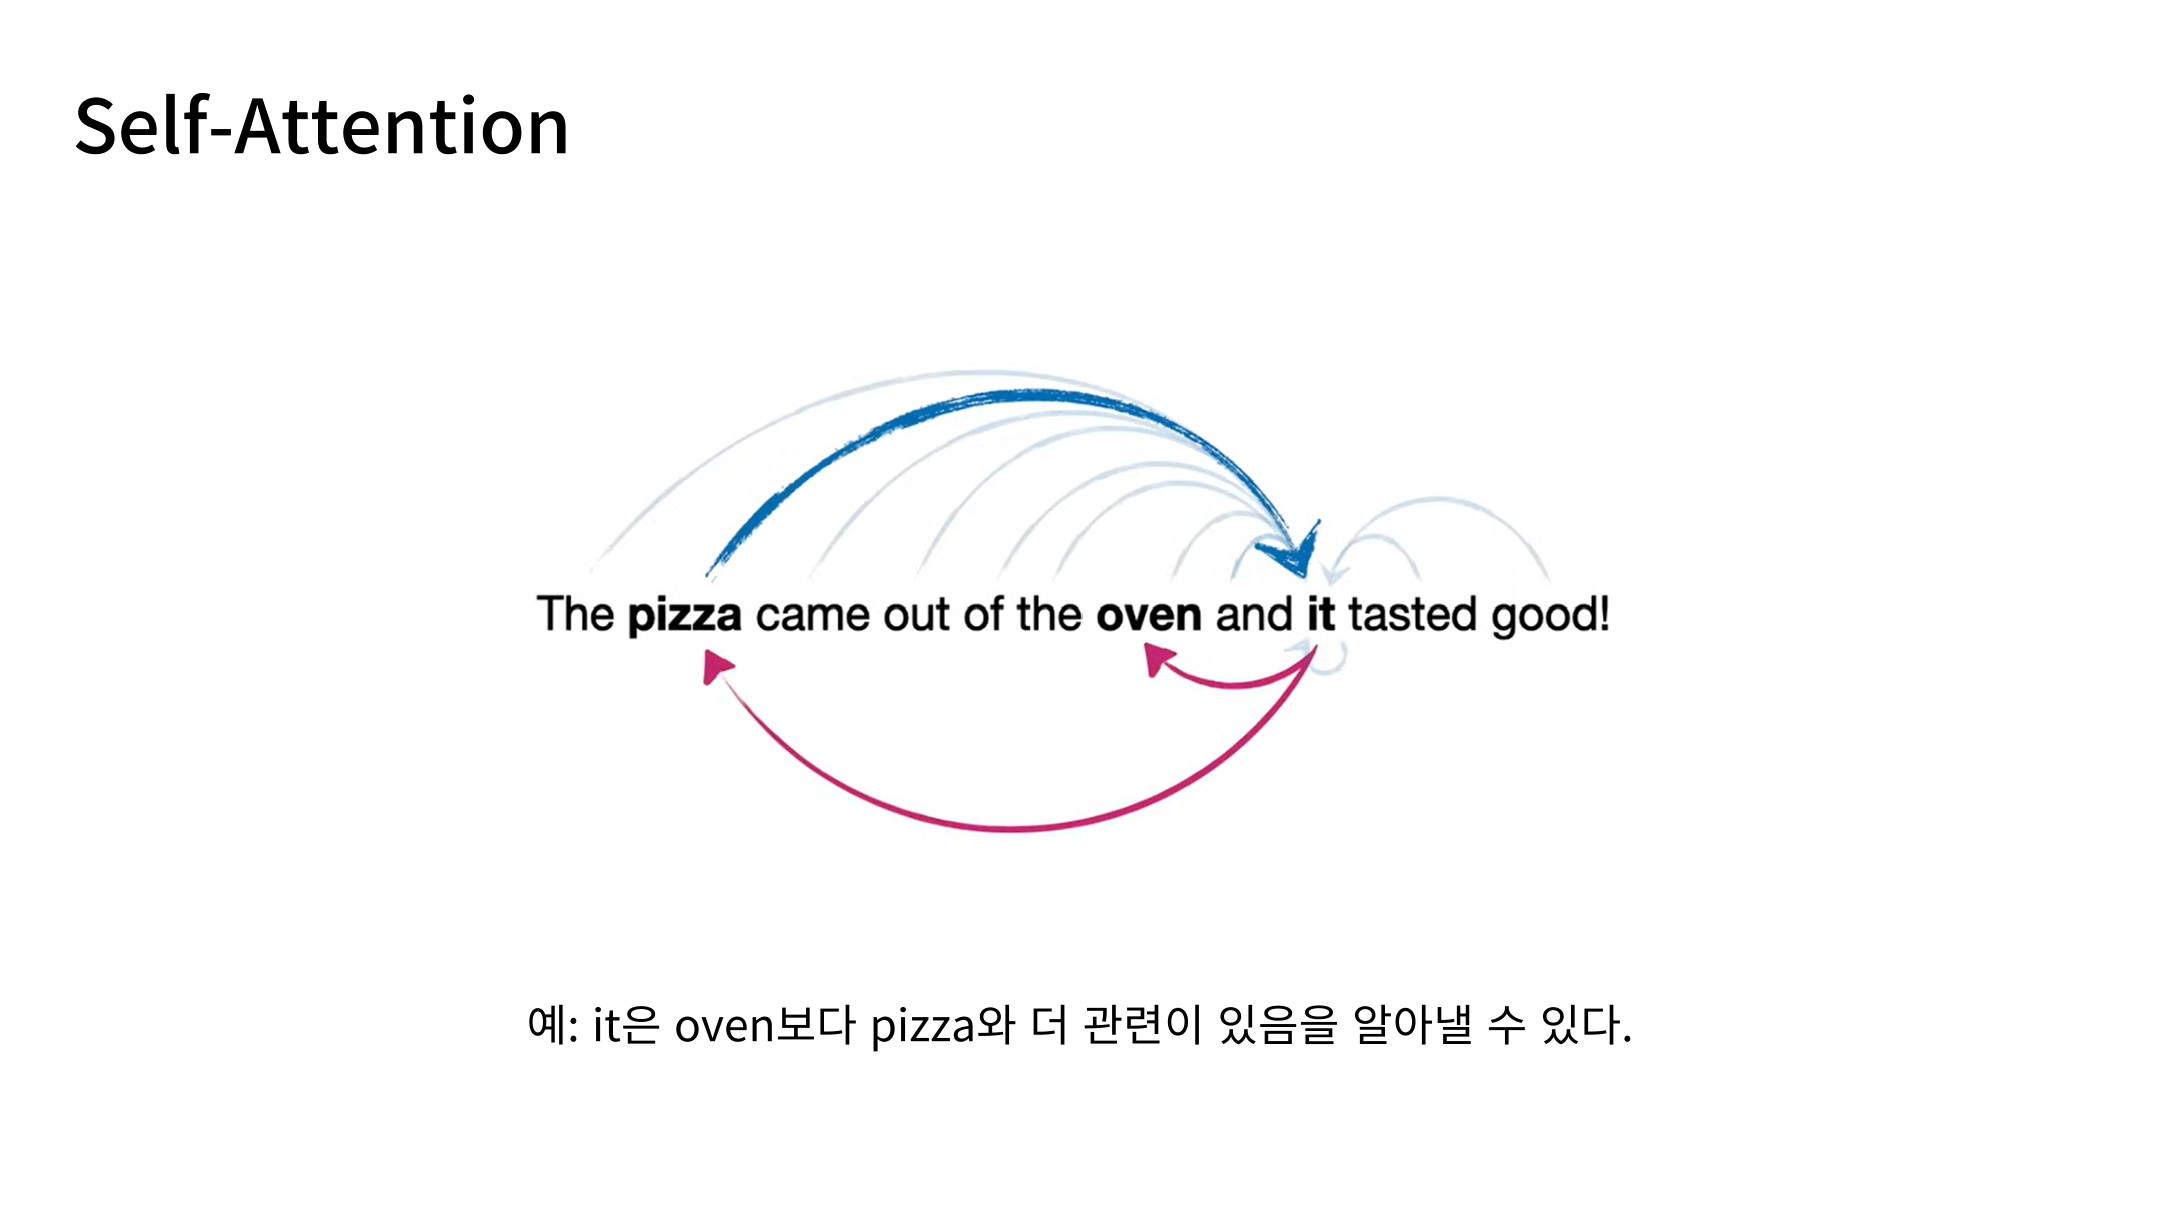
“The pizza came out of the oven and it tasted good”에서 “it”은 “oven”보다 “pizza”와 의미적으로 연결됩니다. Attention은 이런 관계를 학습 가능한 가중치로 표현할 수 있습니다.
Slide 32: Query 생성
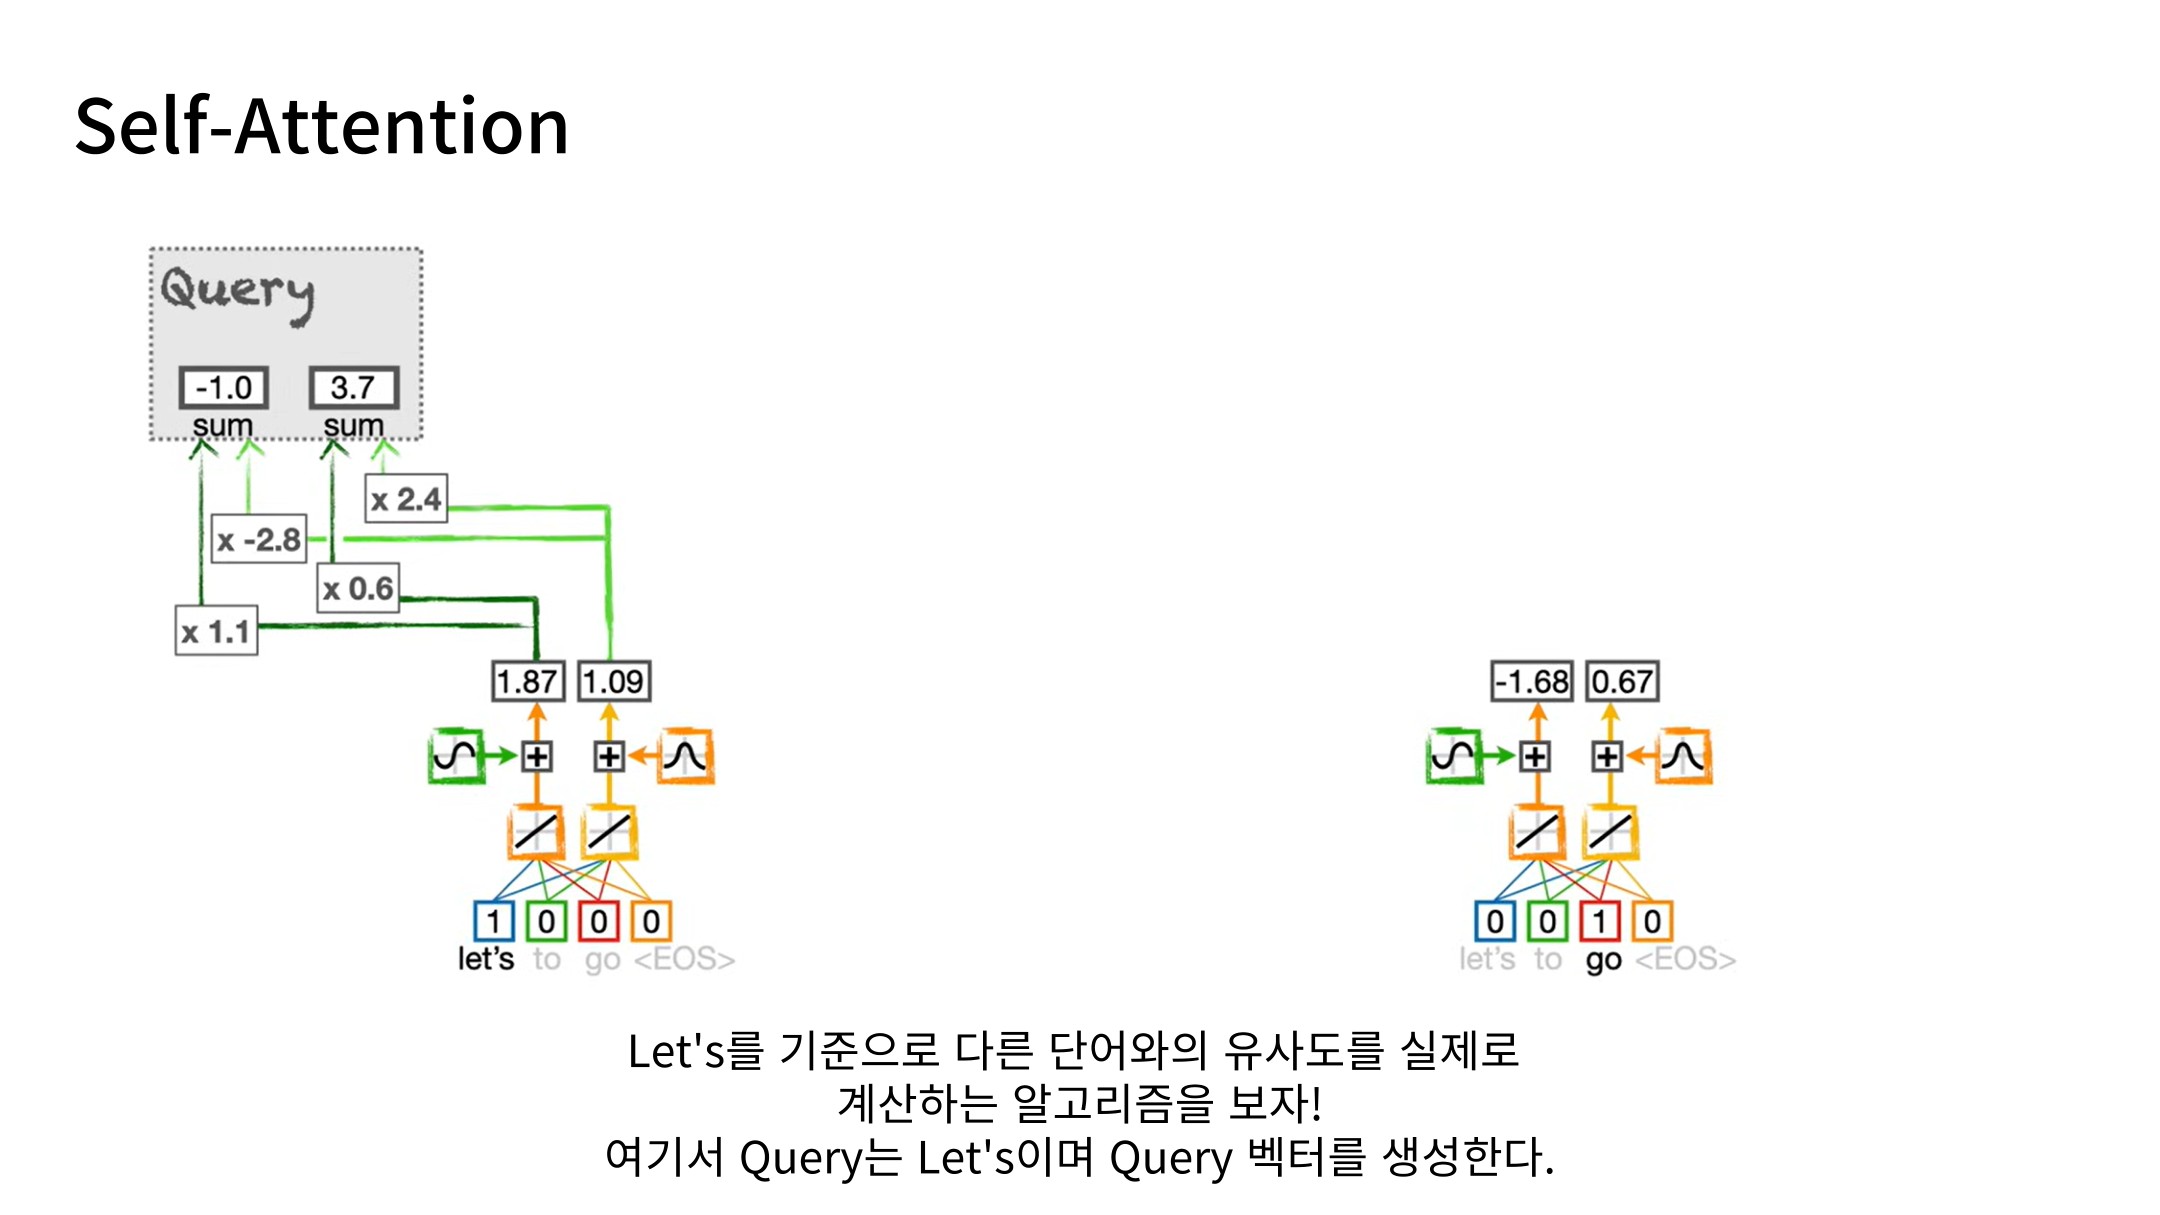
각 토큰 표현에 Query용 선형 변환을 적용합니다. Query는 해당 토큰이 다른 위치에서 어떤 정보를 찾을지를 결정하는 벡터입니다.
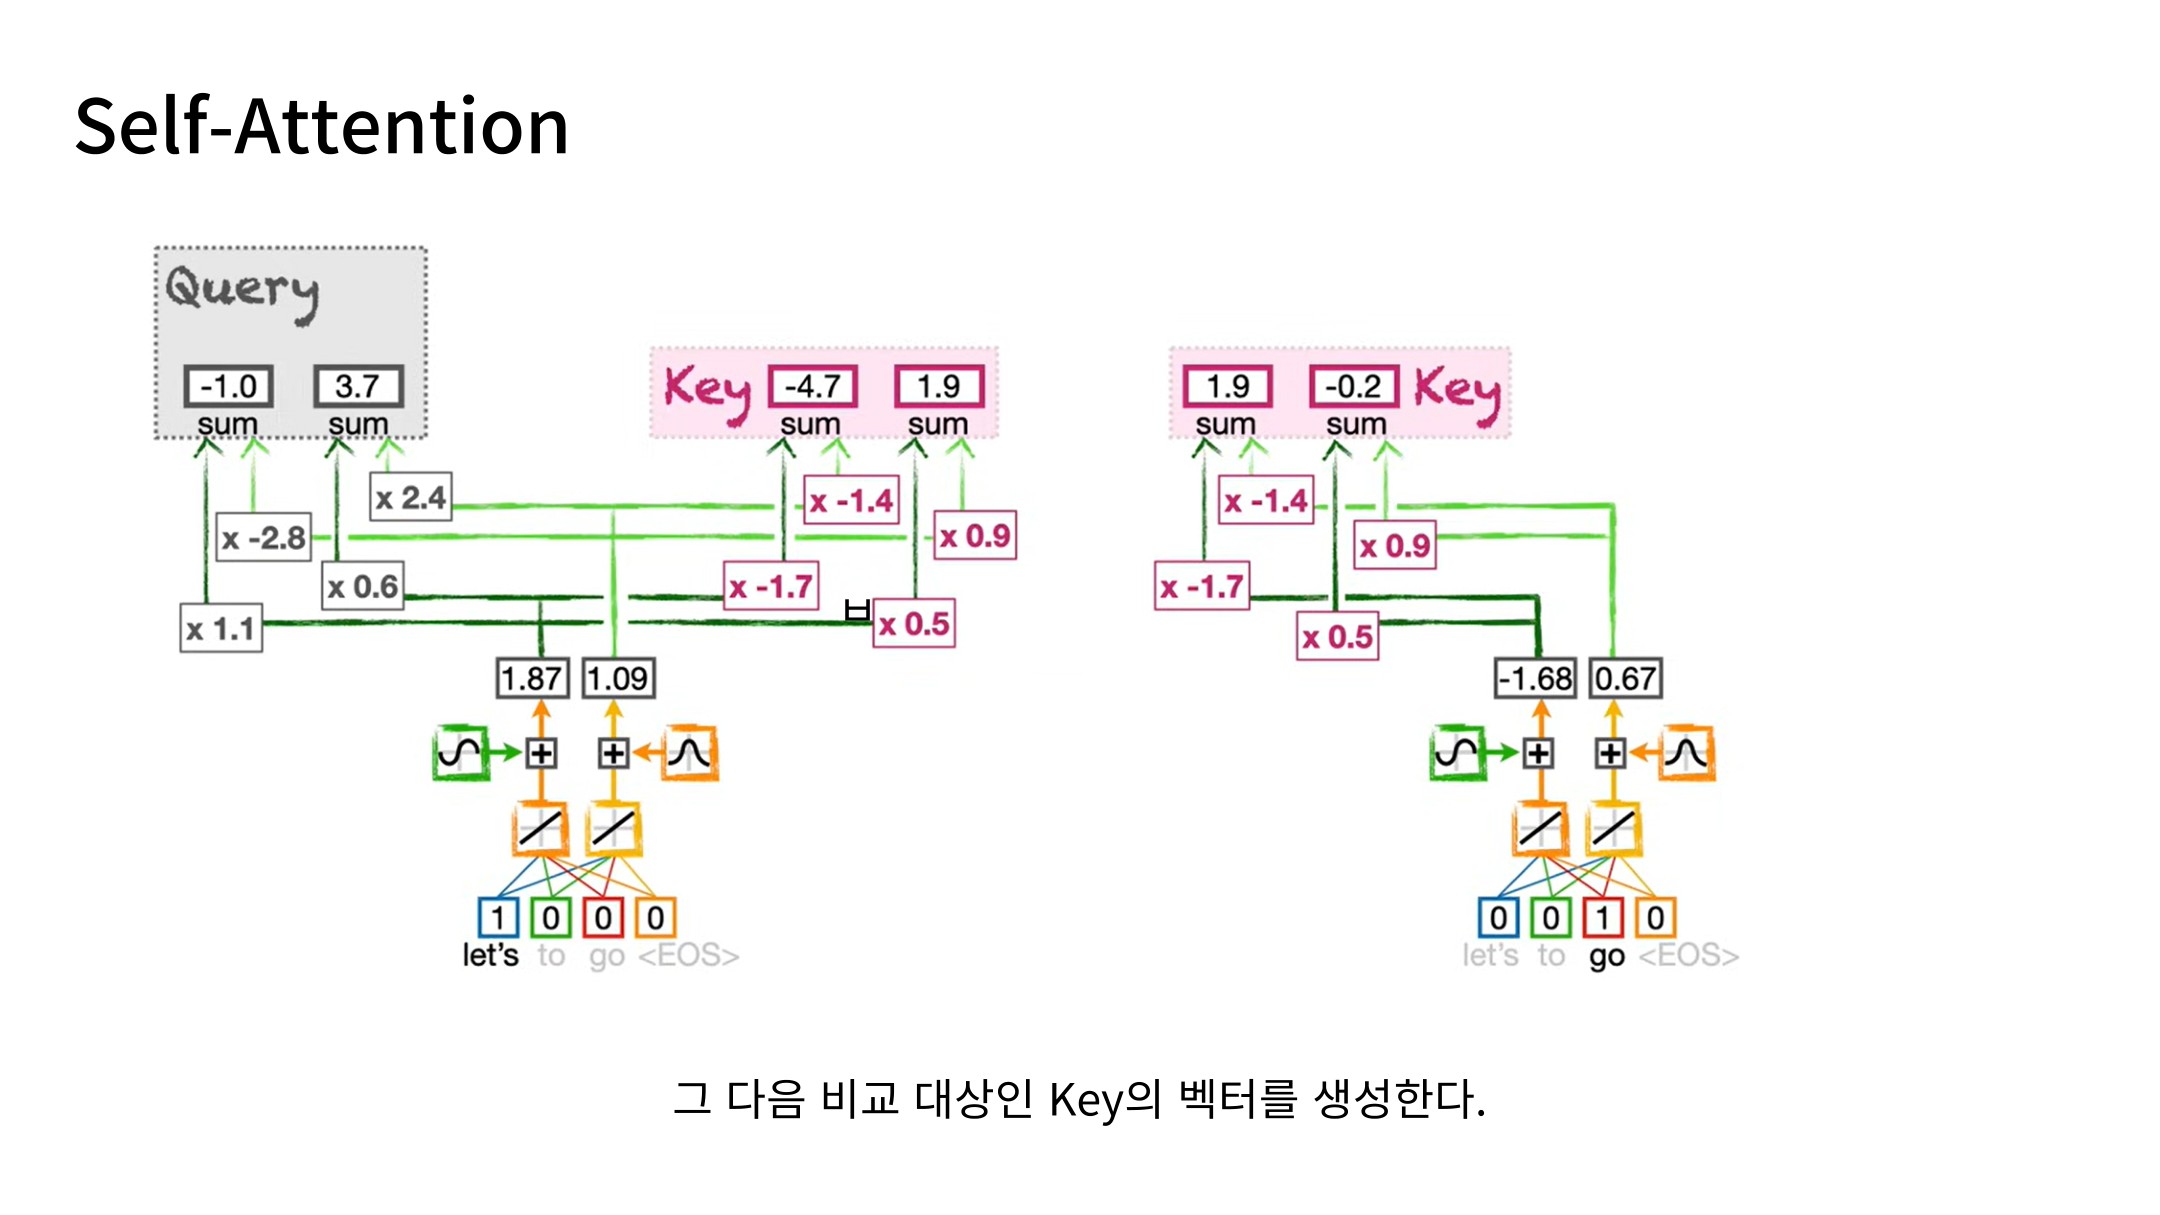
Slide 33: Key 생성
같은 입력 표현에 별도의 Key용 선형 변환을 적용합니다. Query와 Key는 서로 다른 역할을 수행하므로 일반적으로 서로 다른 가중치 행렬을 사용합니다.
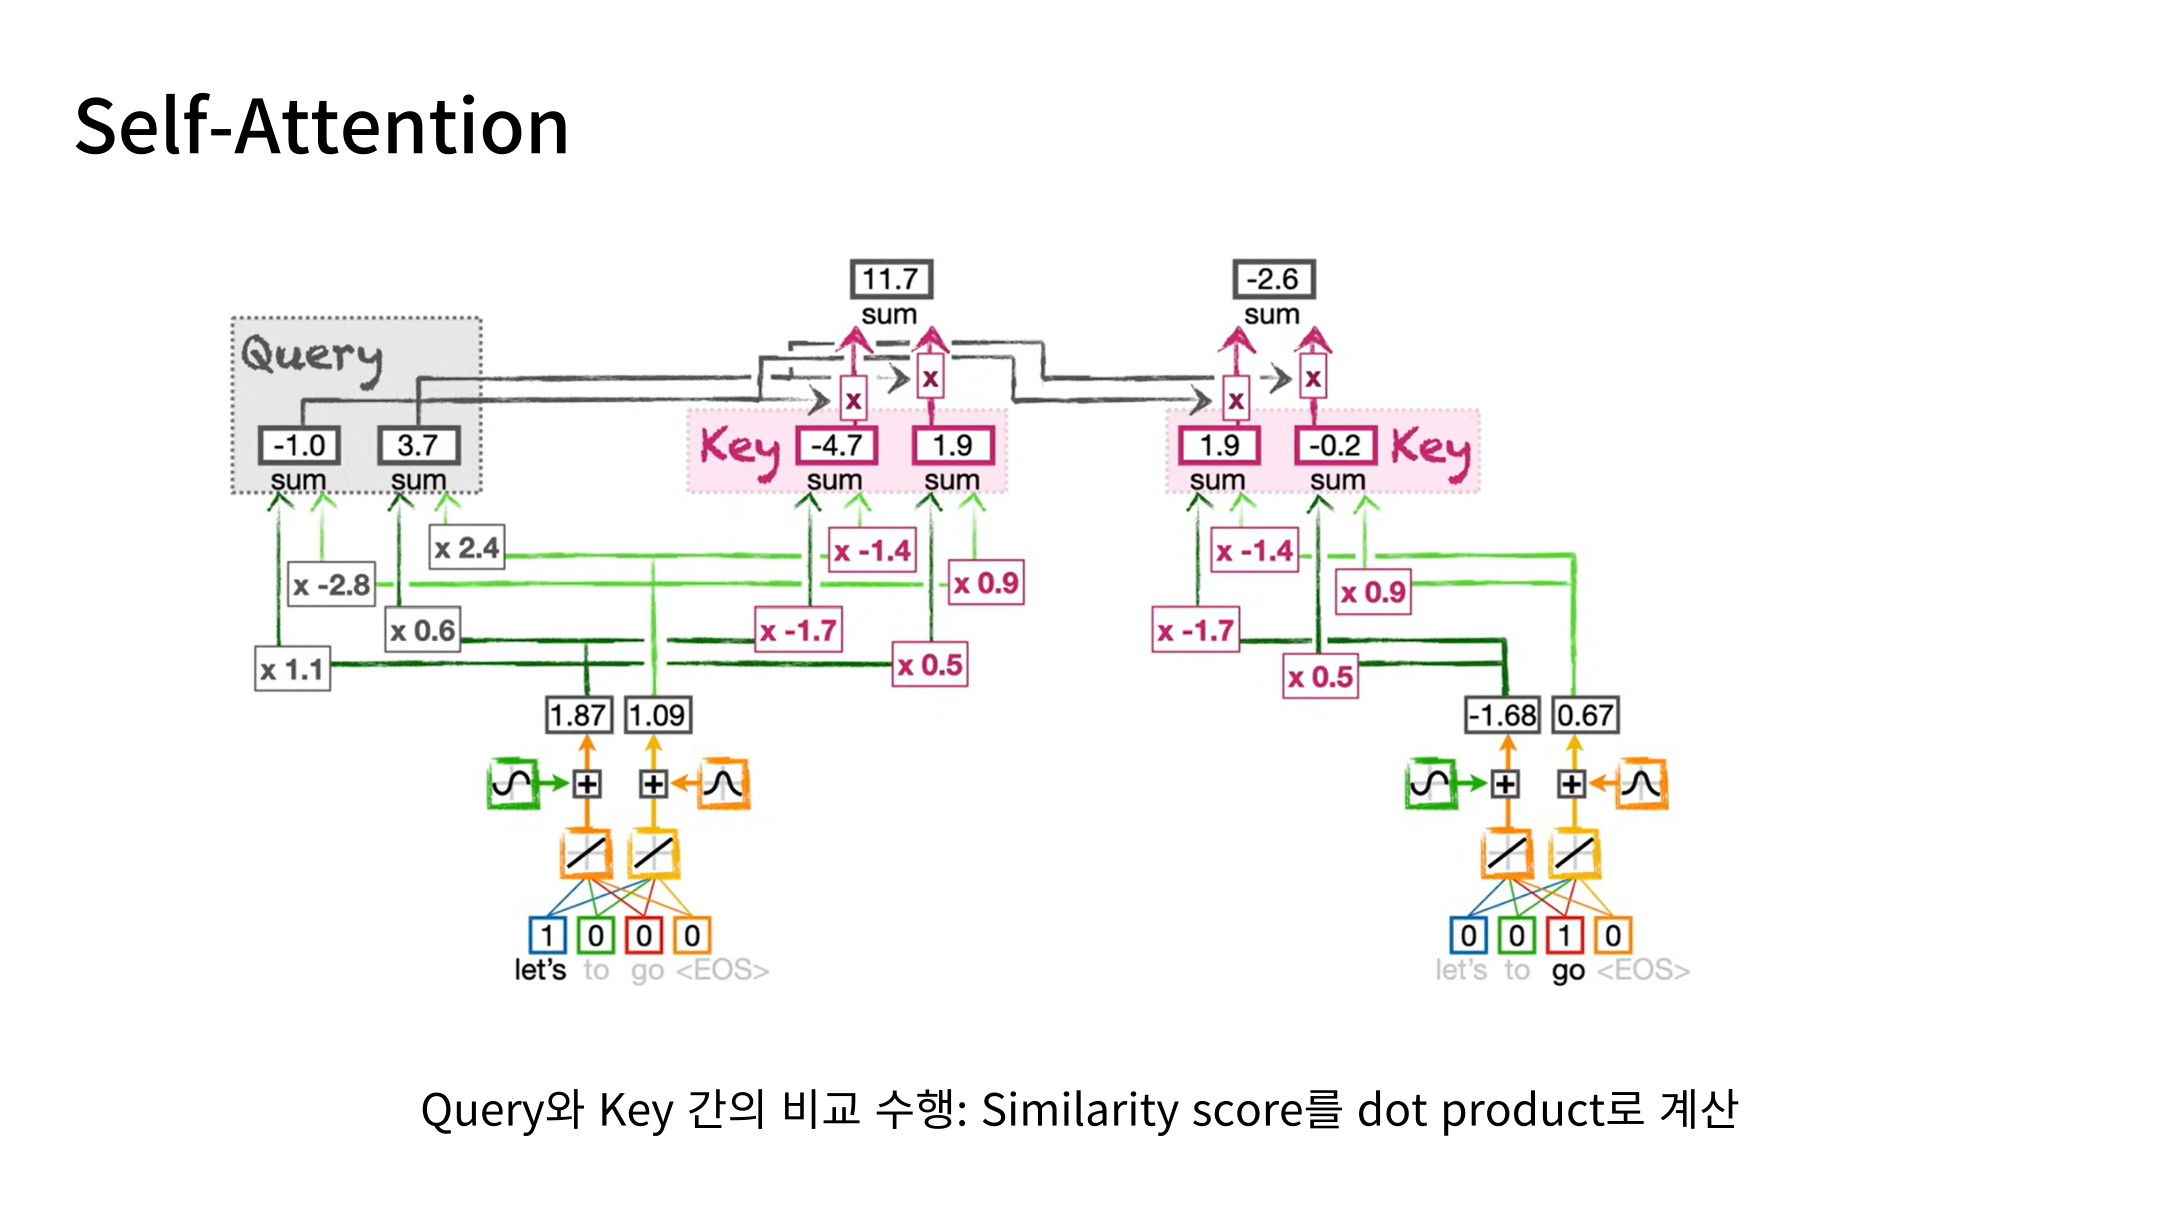
Slide 34: Query–Key 점수
한 토큰의 Query와 모든 토큰의 Key 사이의 내적을 계산합니다. 원래 Scaled Dot-Product Attention에서는 이 값을 $\sqrt{d_k}$로 나누어 점수의 규모를 조절합니다.
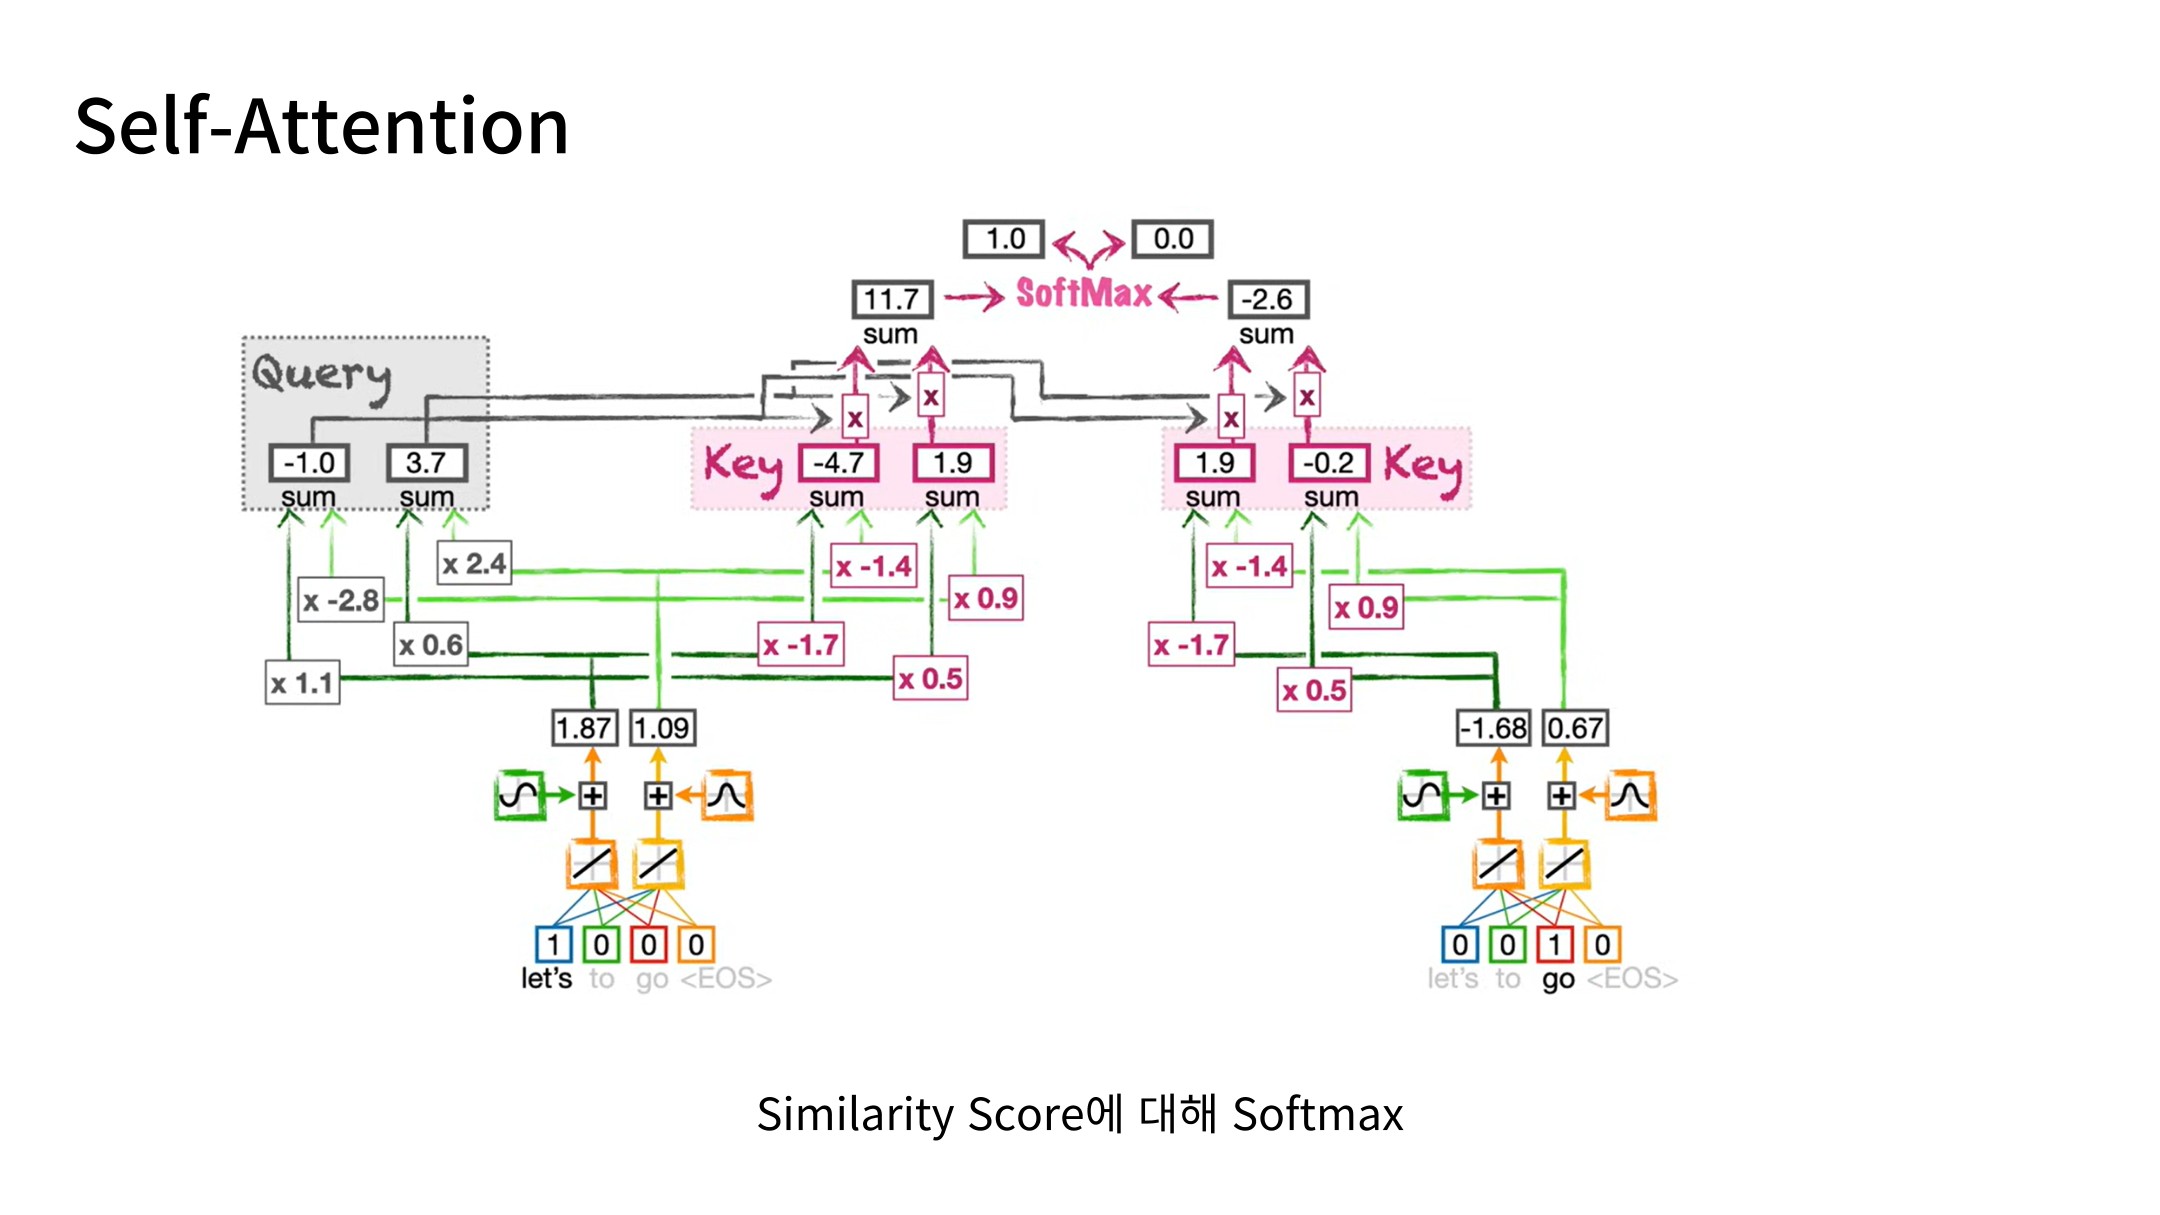
Slide 35: Attention 가중치
점수에 Softmax를 적용해 현재 Query가 각 입력 위치를 얼마나 참고할지 결정합니다. Encoder의 Self-Attention에서는 일반적으로 입력의 앞뒤 위치를 모두 볼 수 있습니다.
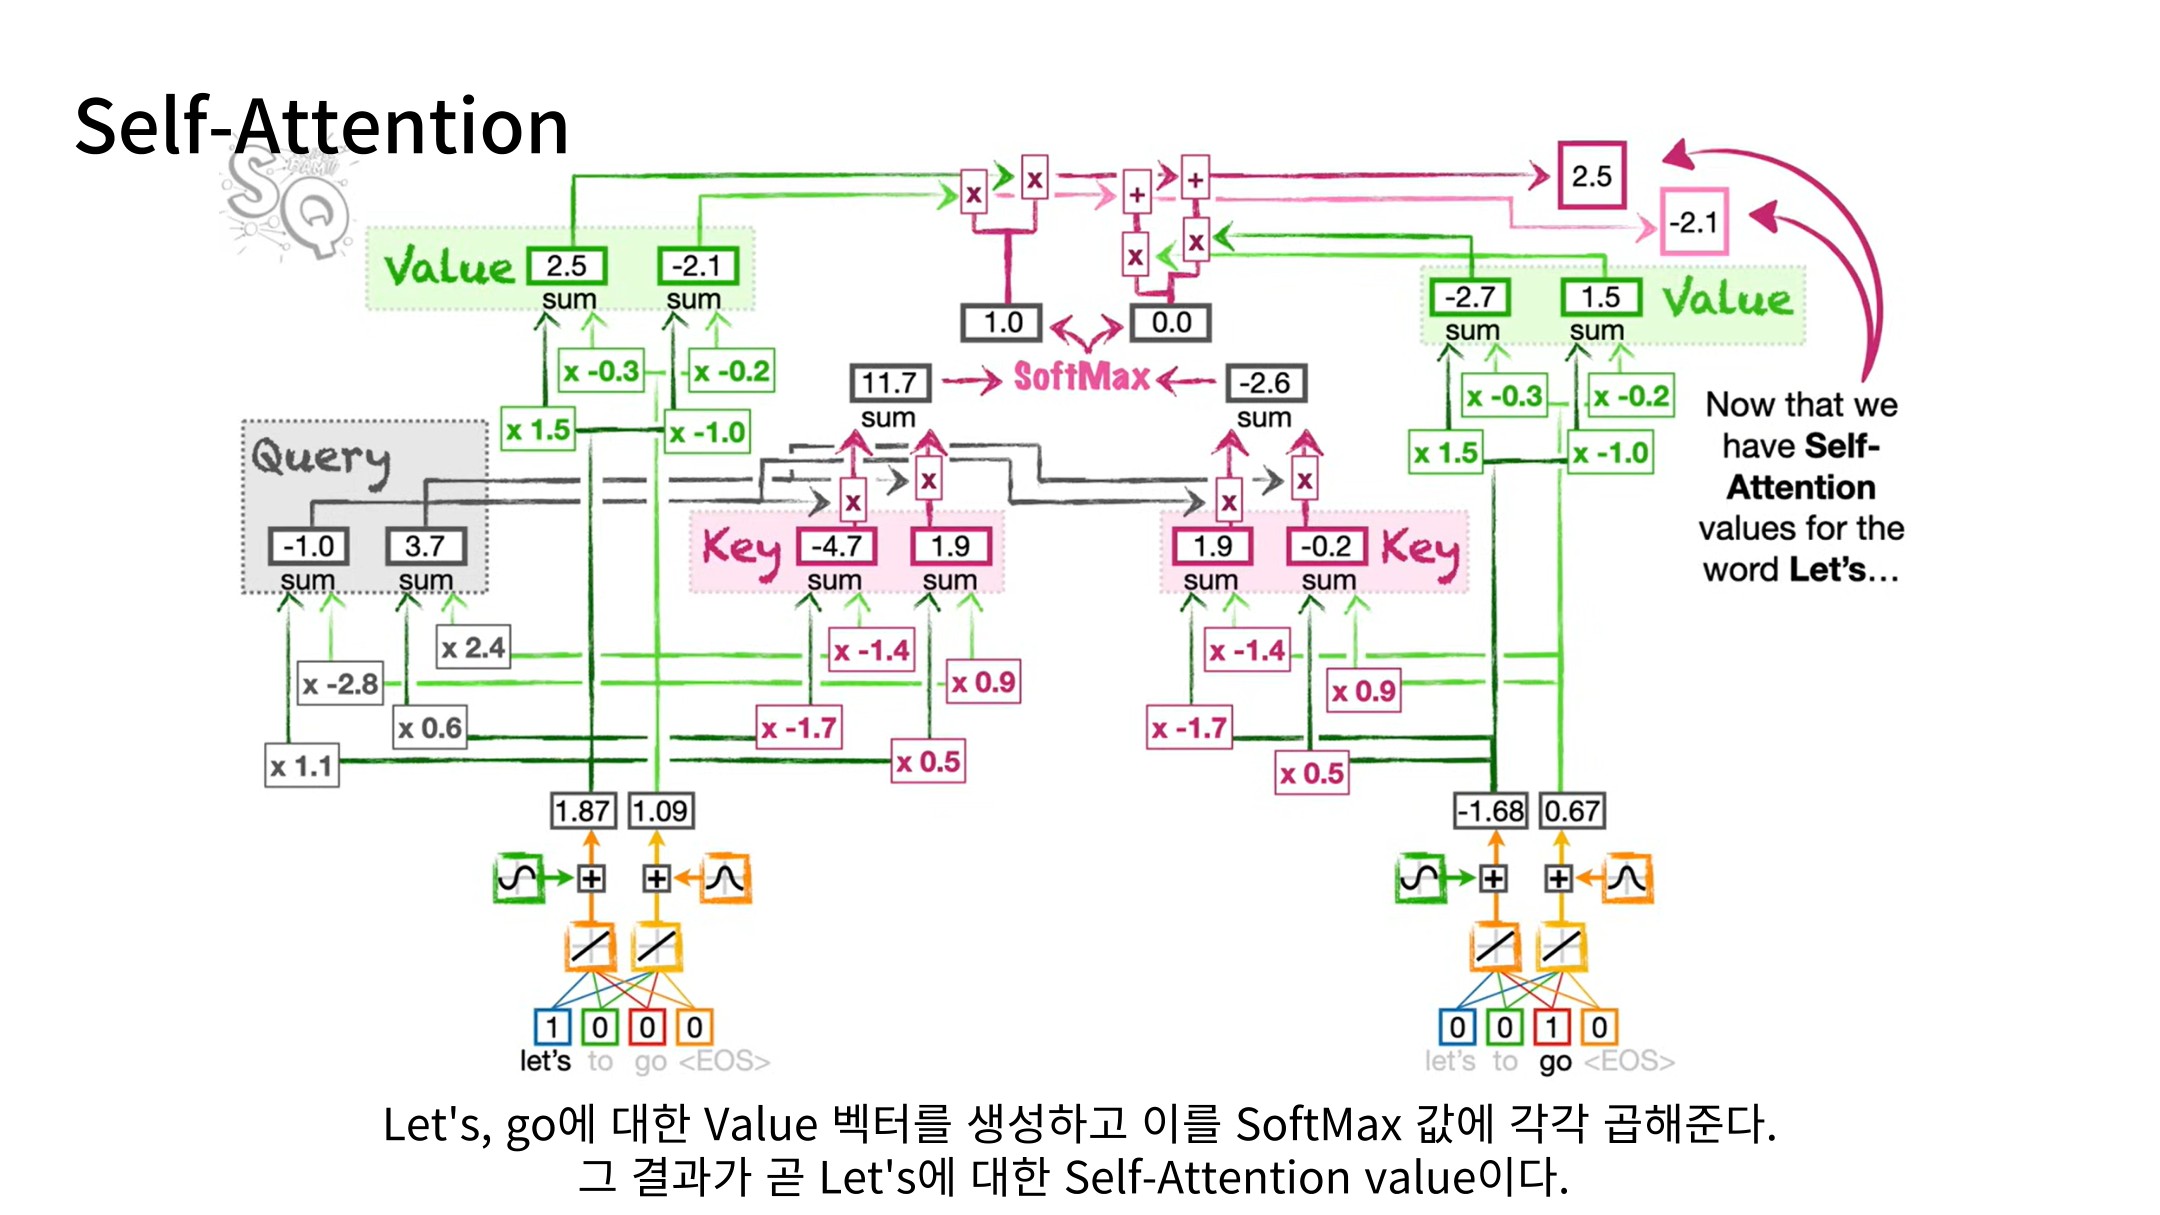
Slide 36: Value 가중합
Value용 선형 변환으로 얻은 벡터들에 Attention 가중치를 곱해 더합니다. 이 가중합이 해당 Query 위치의 Attention 출력입니다.
Slide 37: 다른 토큰의 Attention
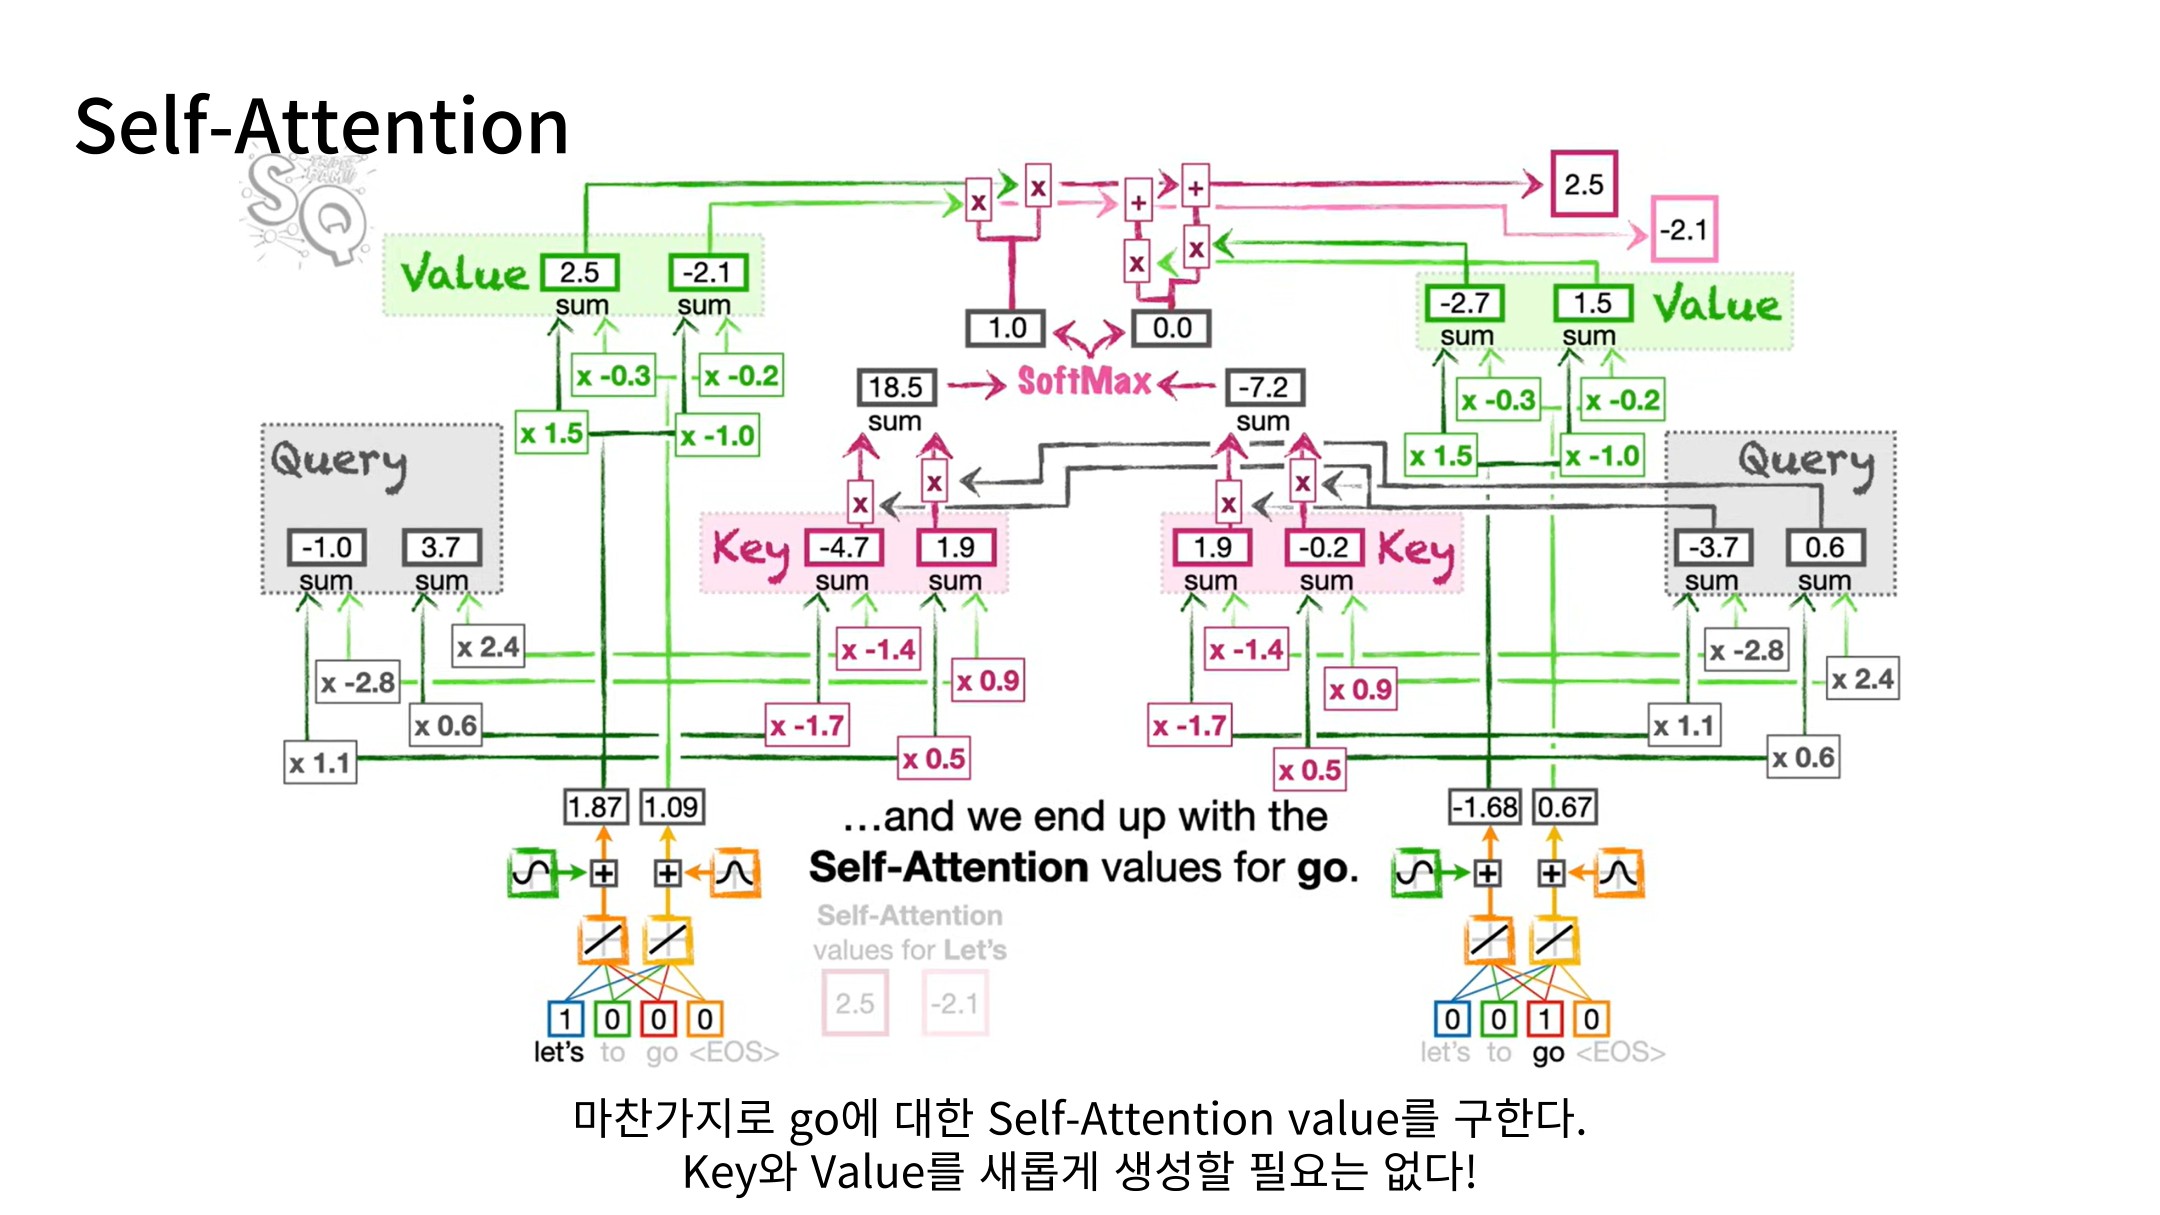
다른 토큰도 자신의 Query로 같은 과정을 수행합니다. Key와 Value를 토큰마다 별도의 모형으로 새로 만드는 것이 아니라, 공유된 변환을 각 토큰에 적용합니다.
Slide 38: 병렬 계산
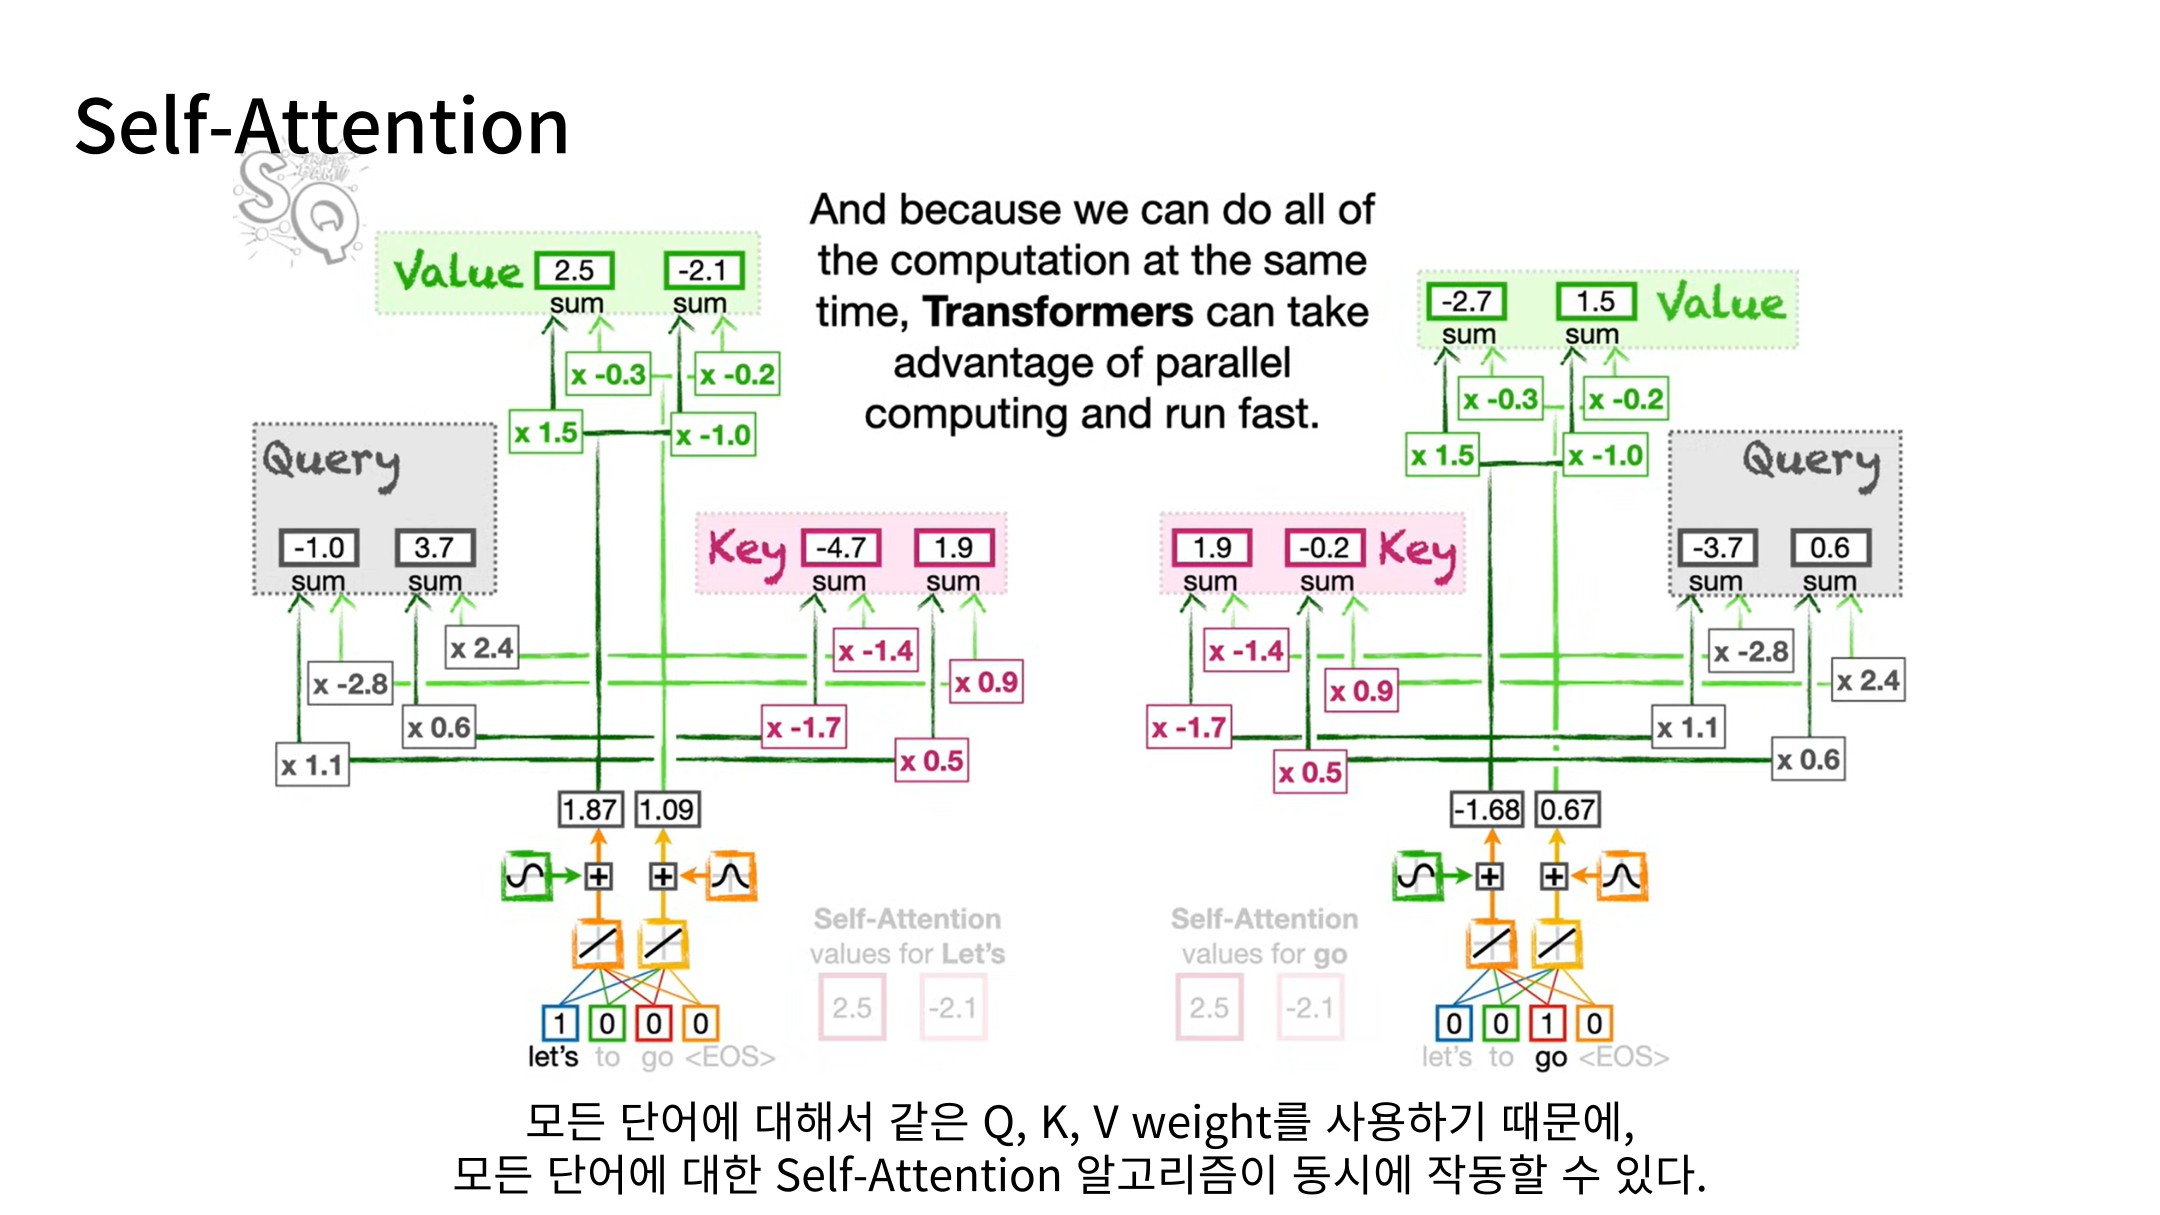
모든 위치의 Query, Key, Value를 행렬로 모으면 Attention을 행렬 연산으로 계산할 수 있습니다. 순환 신경망과 달리 Encoder의 각 위치를 순서대로 처리할 필요가 없습니다.
Slide 39: Residual Connection
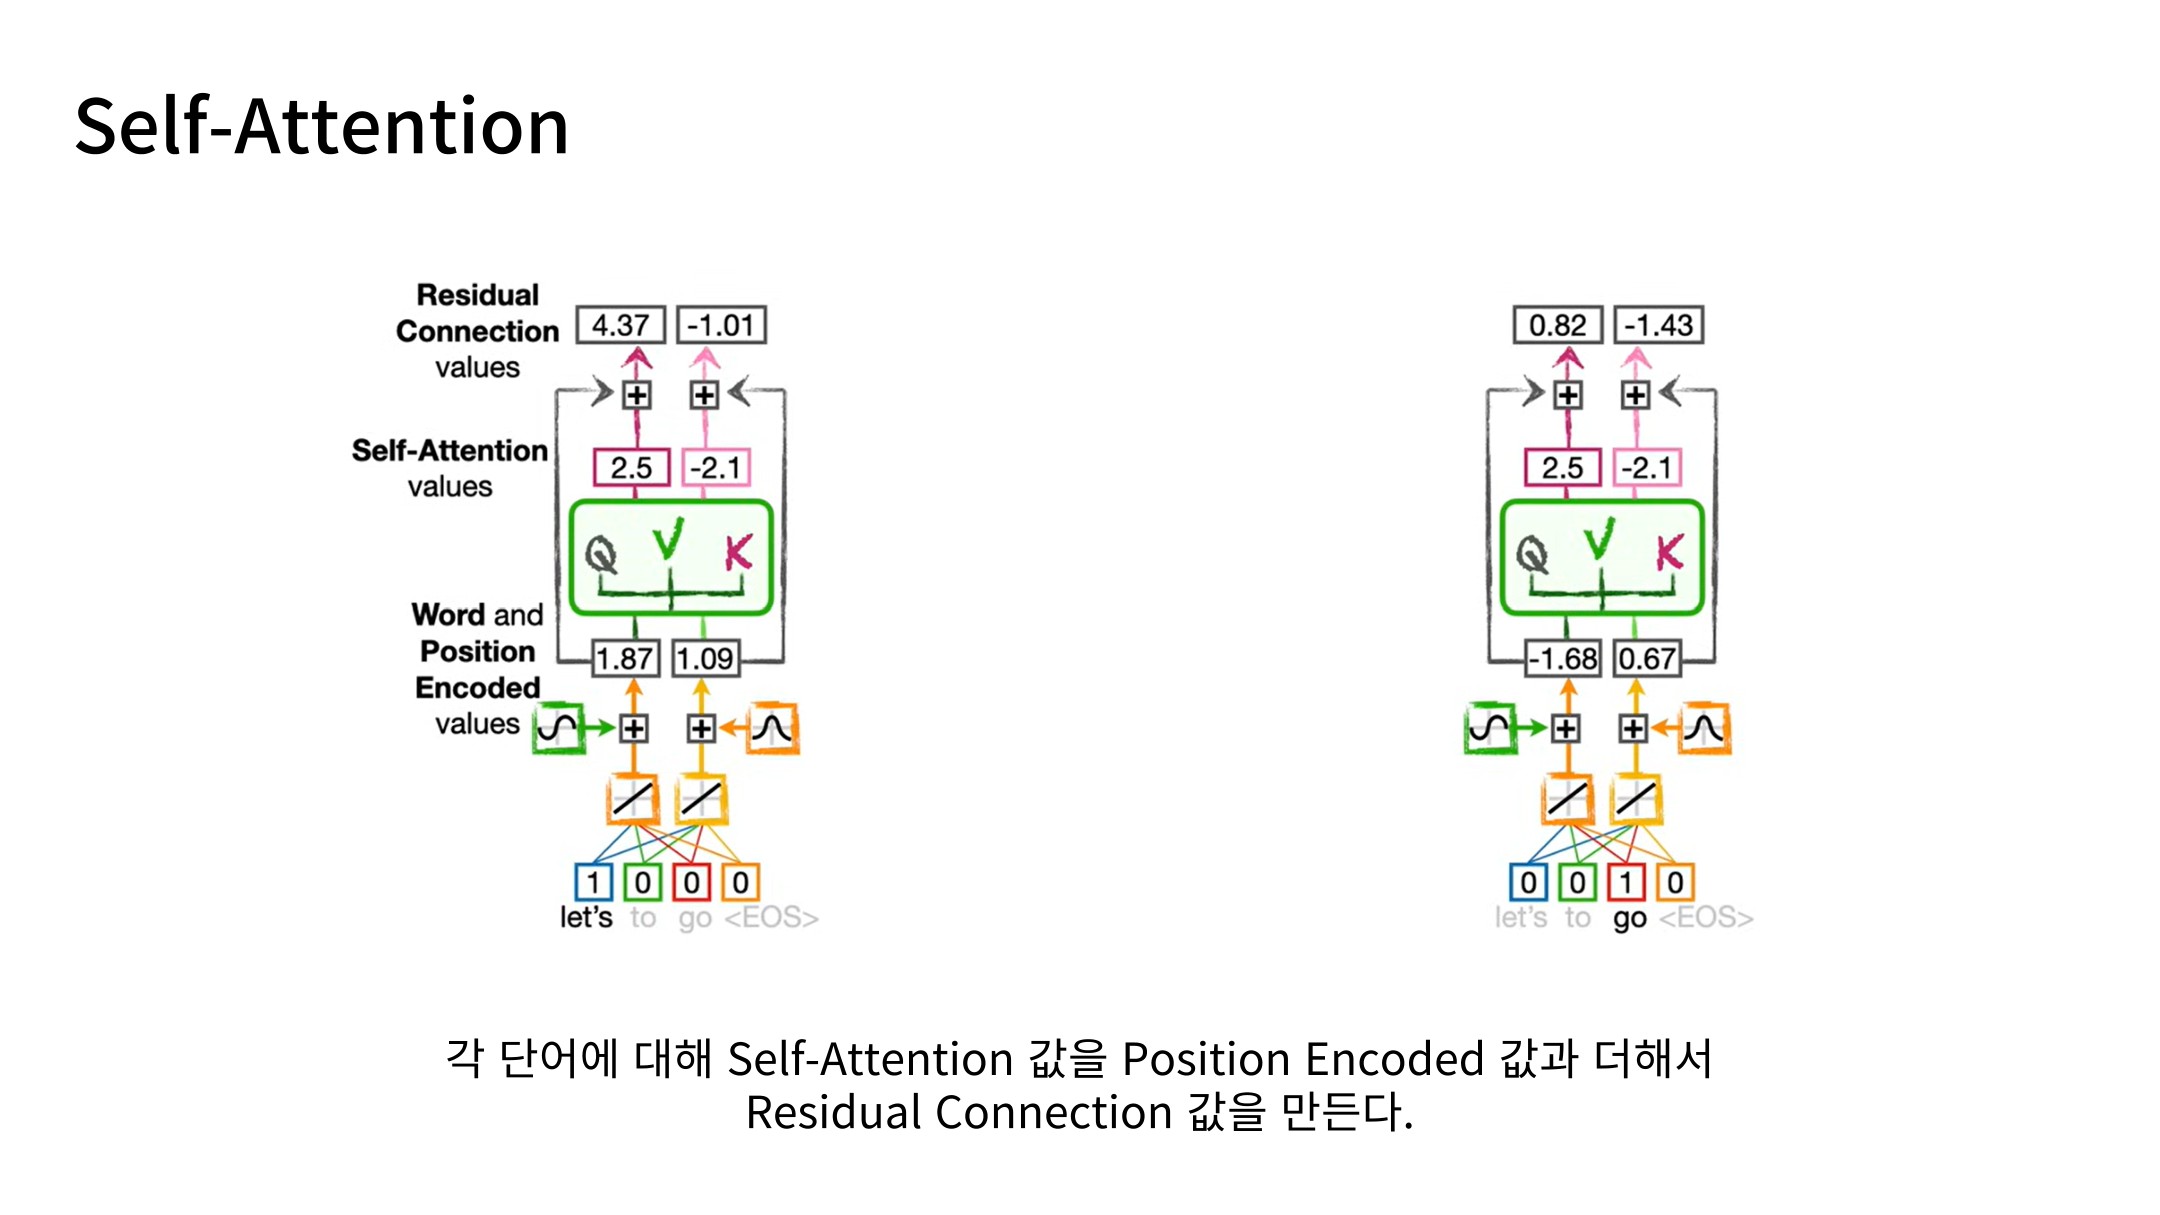
Attention의 출력에 입력 표현을 더하는 잔차 연결을 사용합니다. 원래 Transformer에는 정규화와 위치별 Feed-Forward Network도 포함되며, 이 그림은 흐름을 단순화한 것입니다.
Slide 40: Encoder 계산 정리
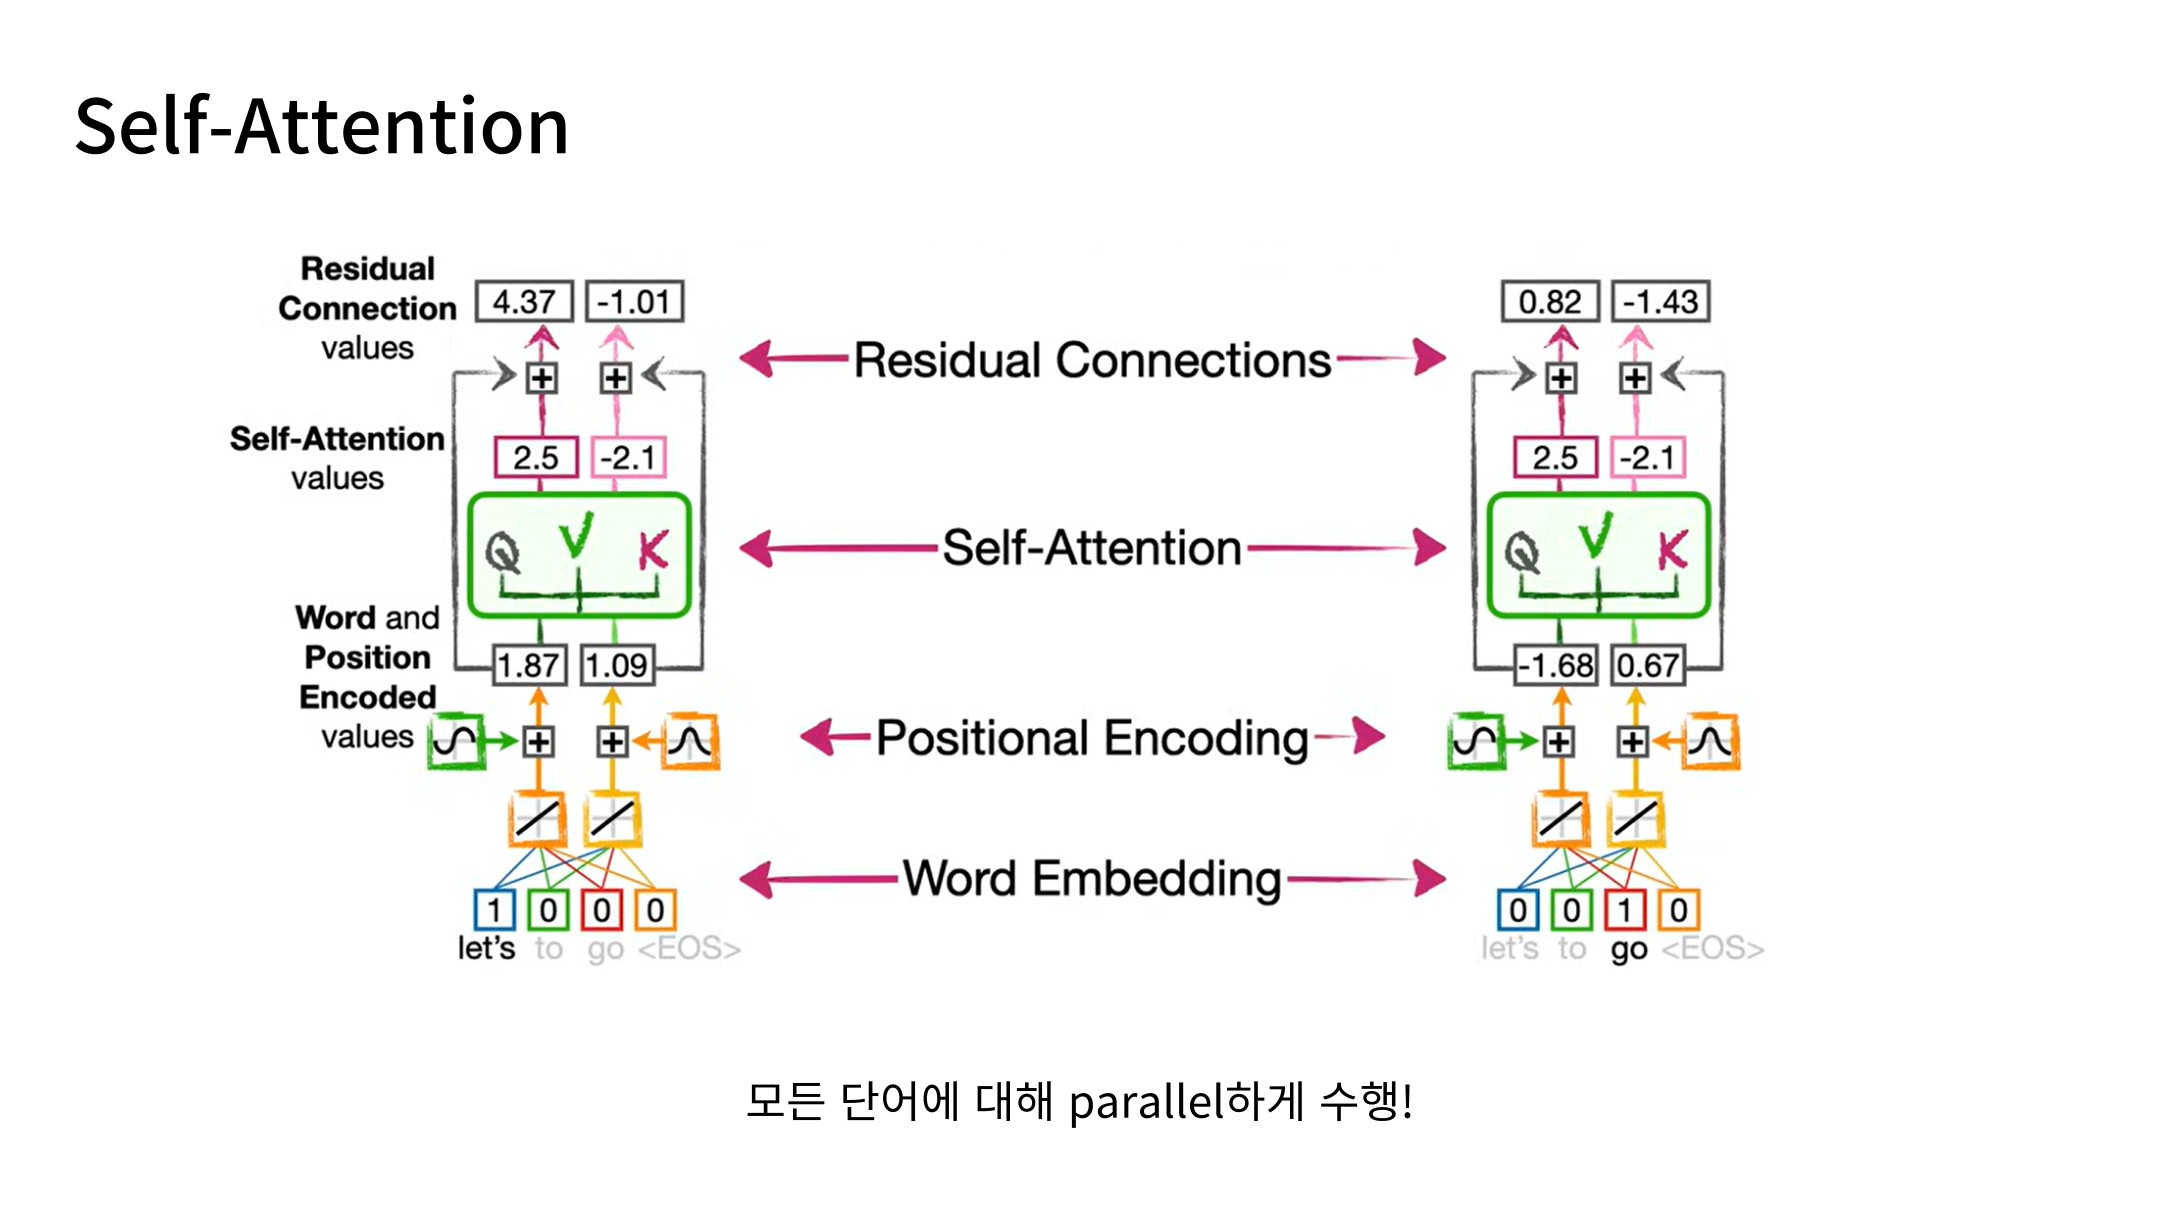
Word Embedding → Positional Encoding → Self-Attention → 잔차 연결의 흐름을 정리합니다. 실제 Encoder 블록은 Multi-Head Attention, Add & Norm, Feed-Forward Network를 포함하고 여러 층으로 쌓입니다.
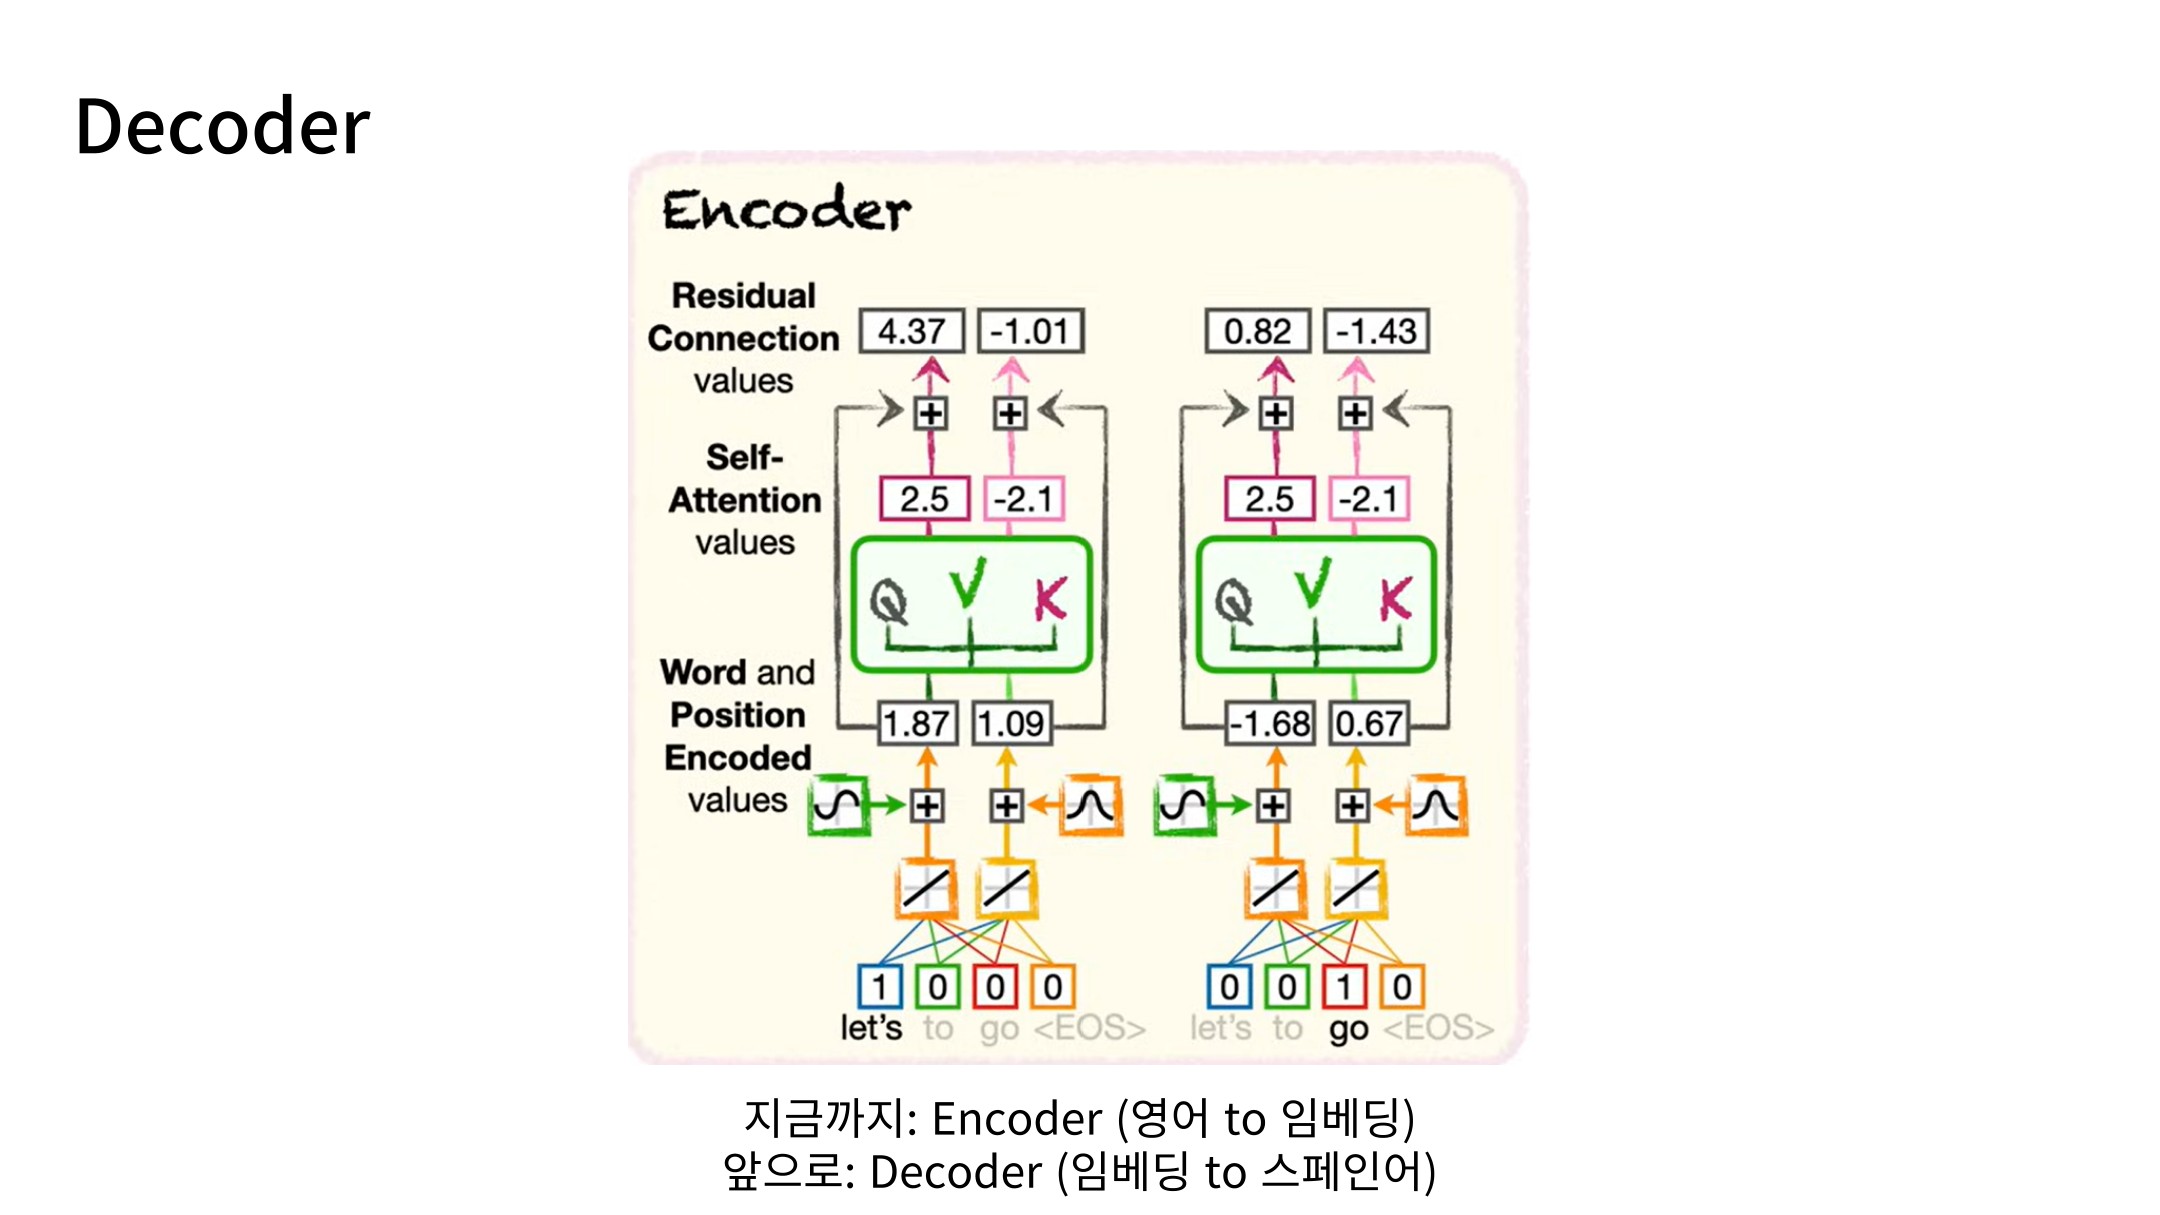
Slide 41: Decoder로 이동
Encoder가 입력 문장을 표현했다면, Decoder는 출력 문장을 생성합니다. 그림의 왼쪽은 입력 언어, 오른쪽은 출력 언어의 토큰을 처리합니다.
Slide 42: Encoder와 Decoder의 차이
Decoder도 Embedding과 Attention을 사용하지만 원래 Transformer에서 Encoder와 완전히 같지는 않습니다. 미래 토큰을 가리는 Masked Self-Attention과 Encoder–Decoder Attention이 추가적인 핵심입니다.
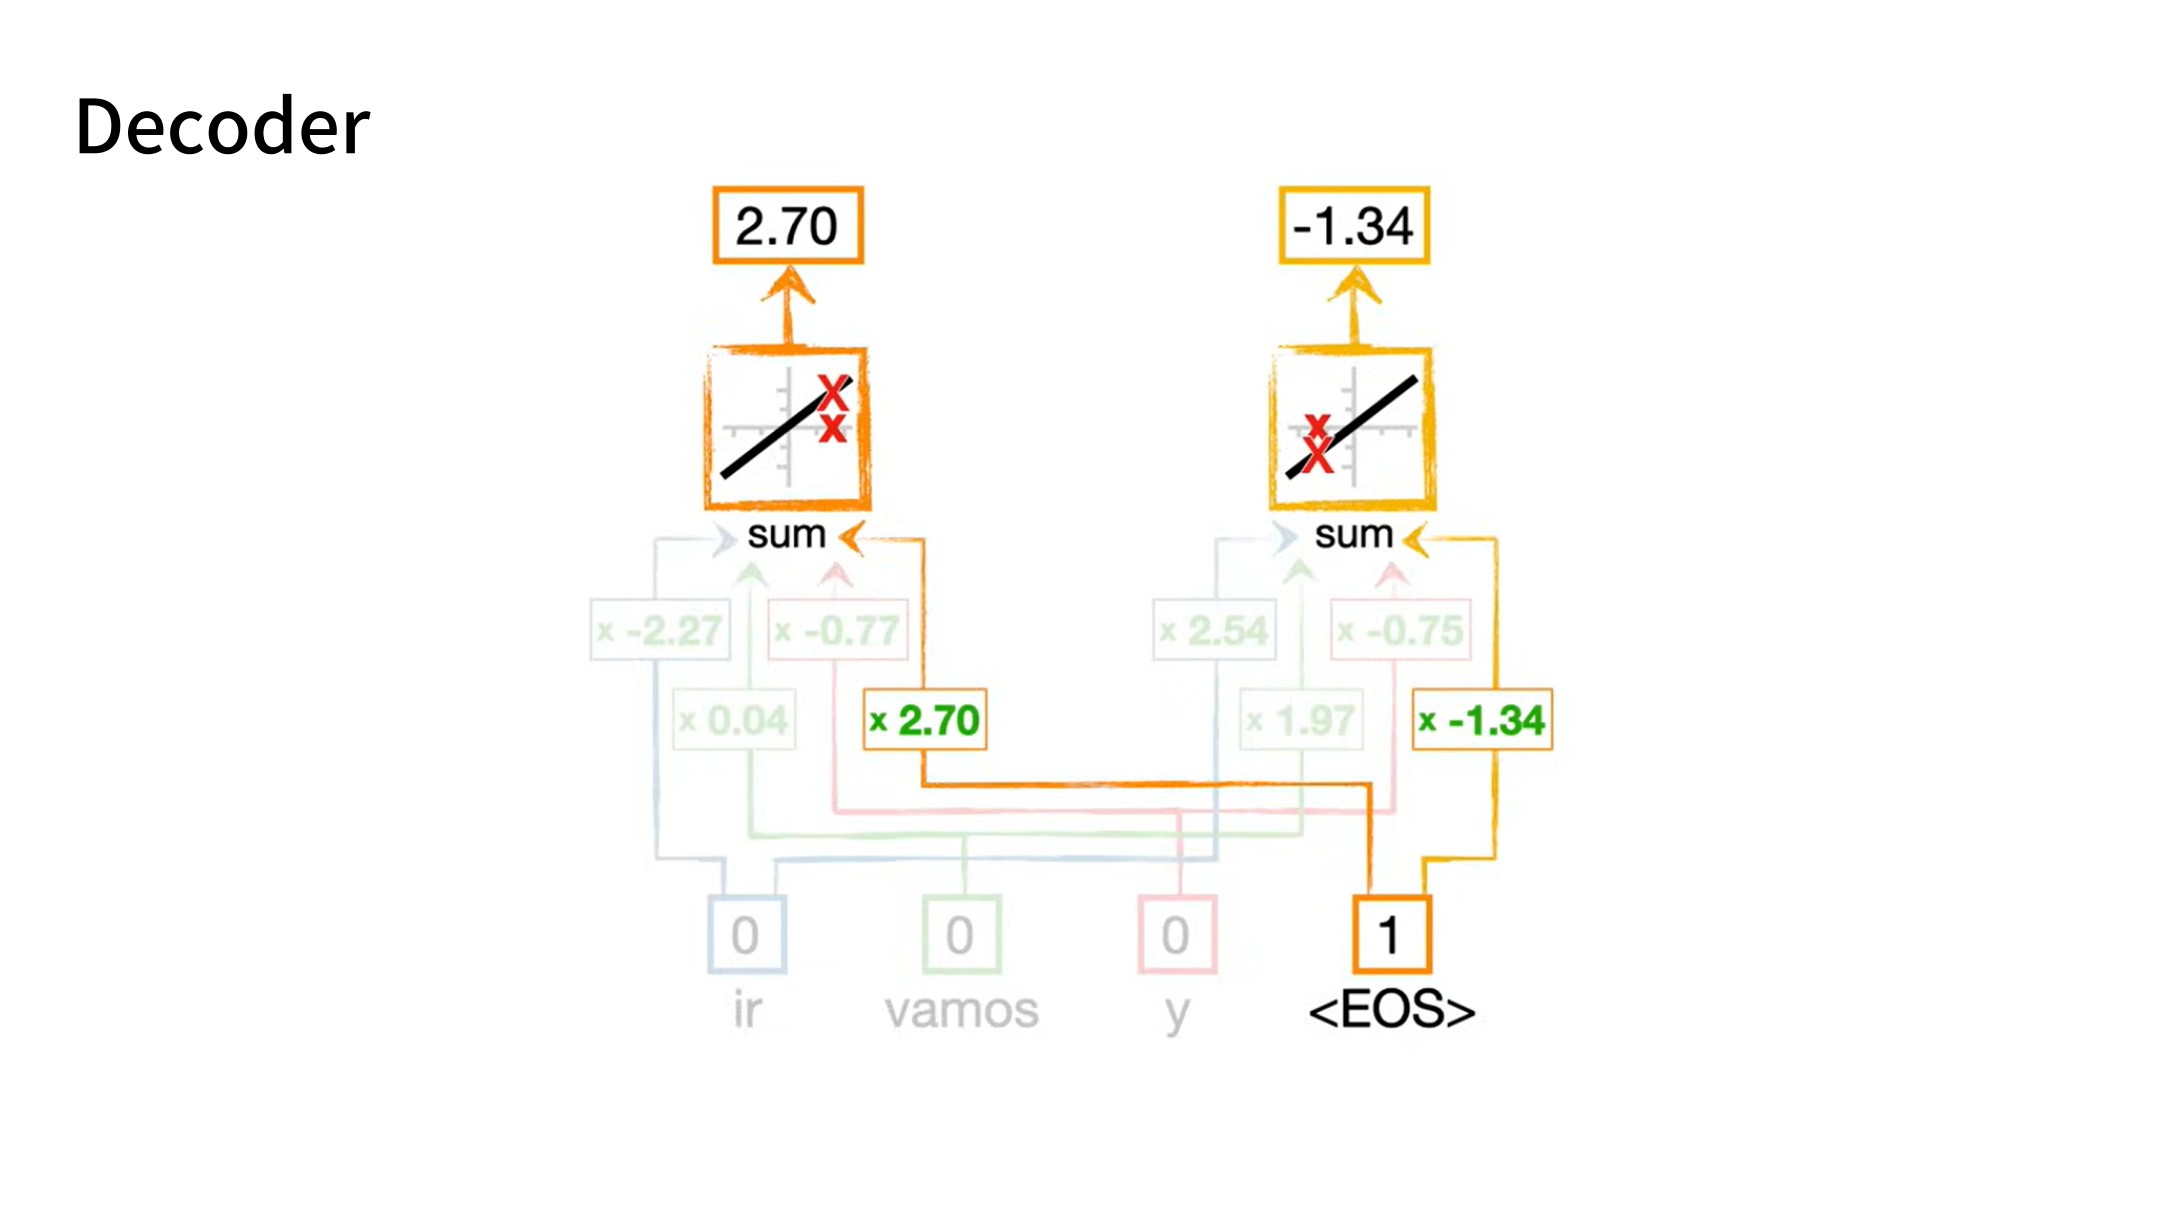
Slide 43: Decoder Embedding
출력 측의 시작 토큰이나 이전 토큰을 Embedding으로 변환합니다. 그 표현에 위치 정보를 더해 Decoder의 입력을 만듭니다.
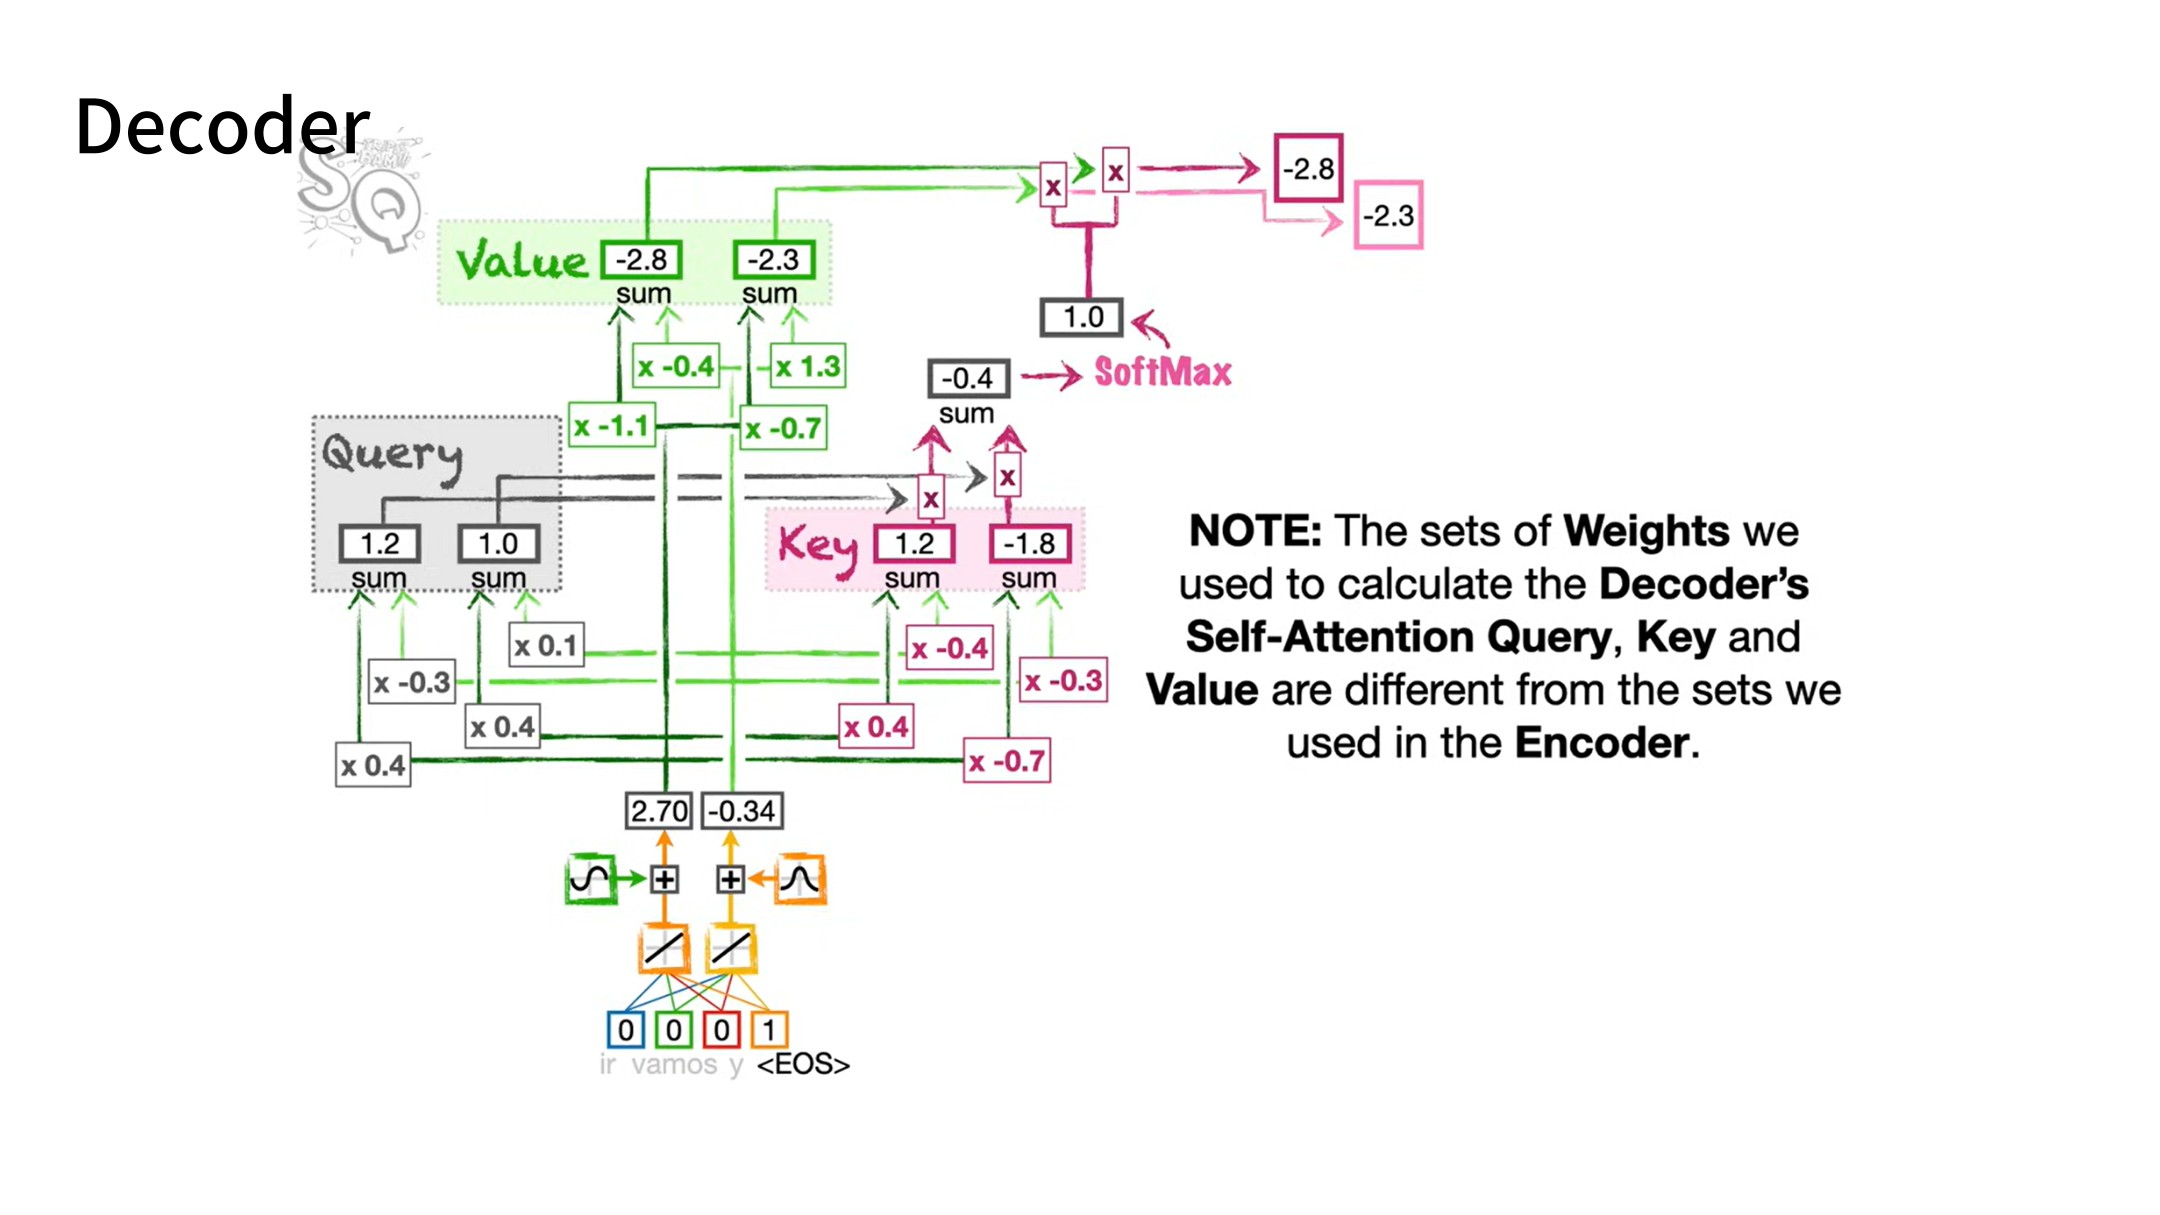
Slide 44: Decoder Self-Attention
Decoder의 Query·Key·Value 변환은 Encoder와 별도로 학습됩니다. 자기회귀 학습에서는 현재 위치가 미래의 정답 토큰을 보지 않도록 Causal Mask를 적용합니다.
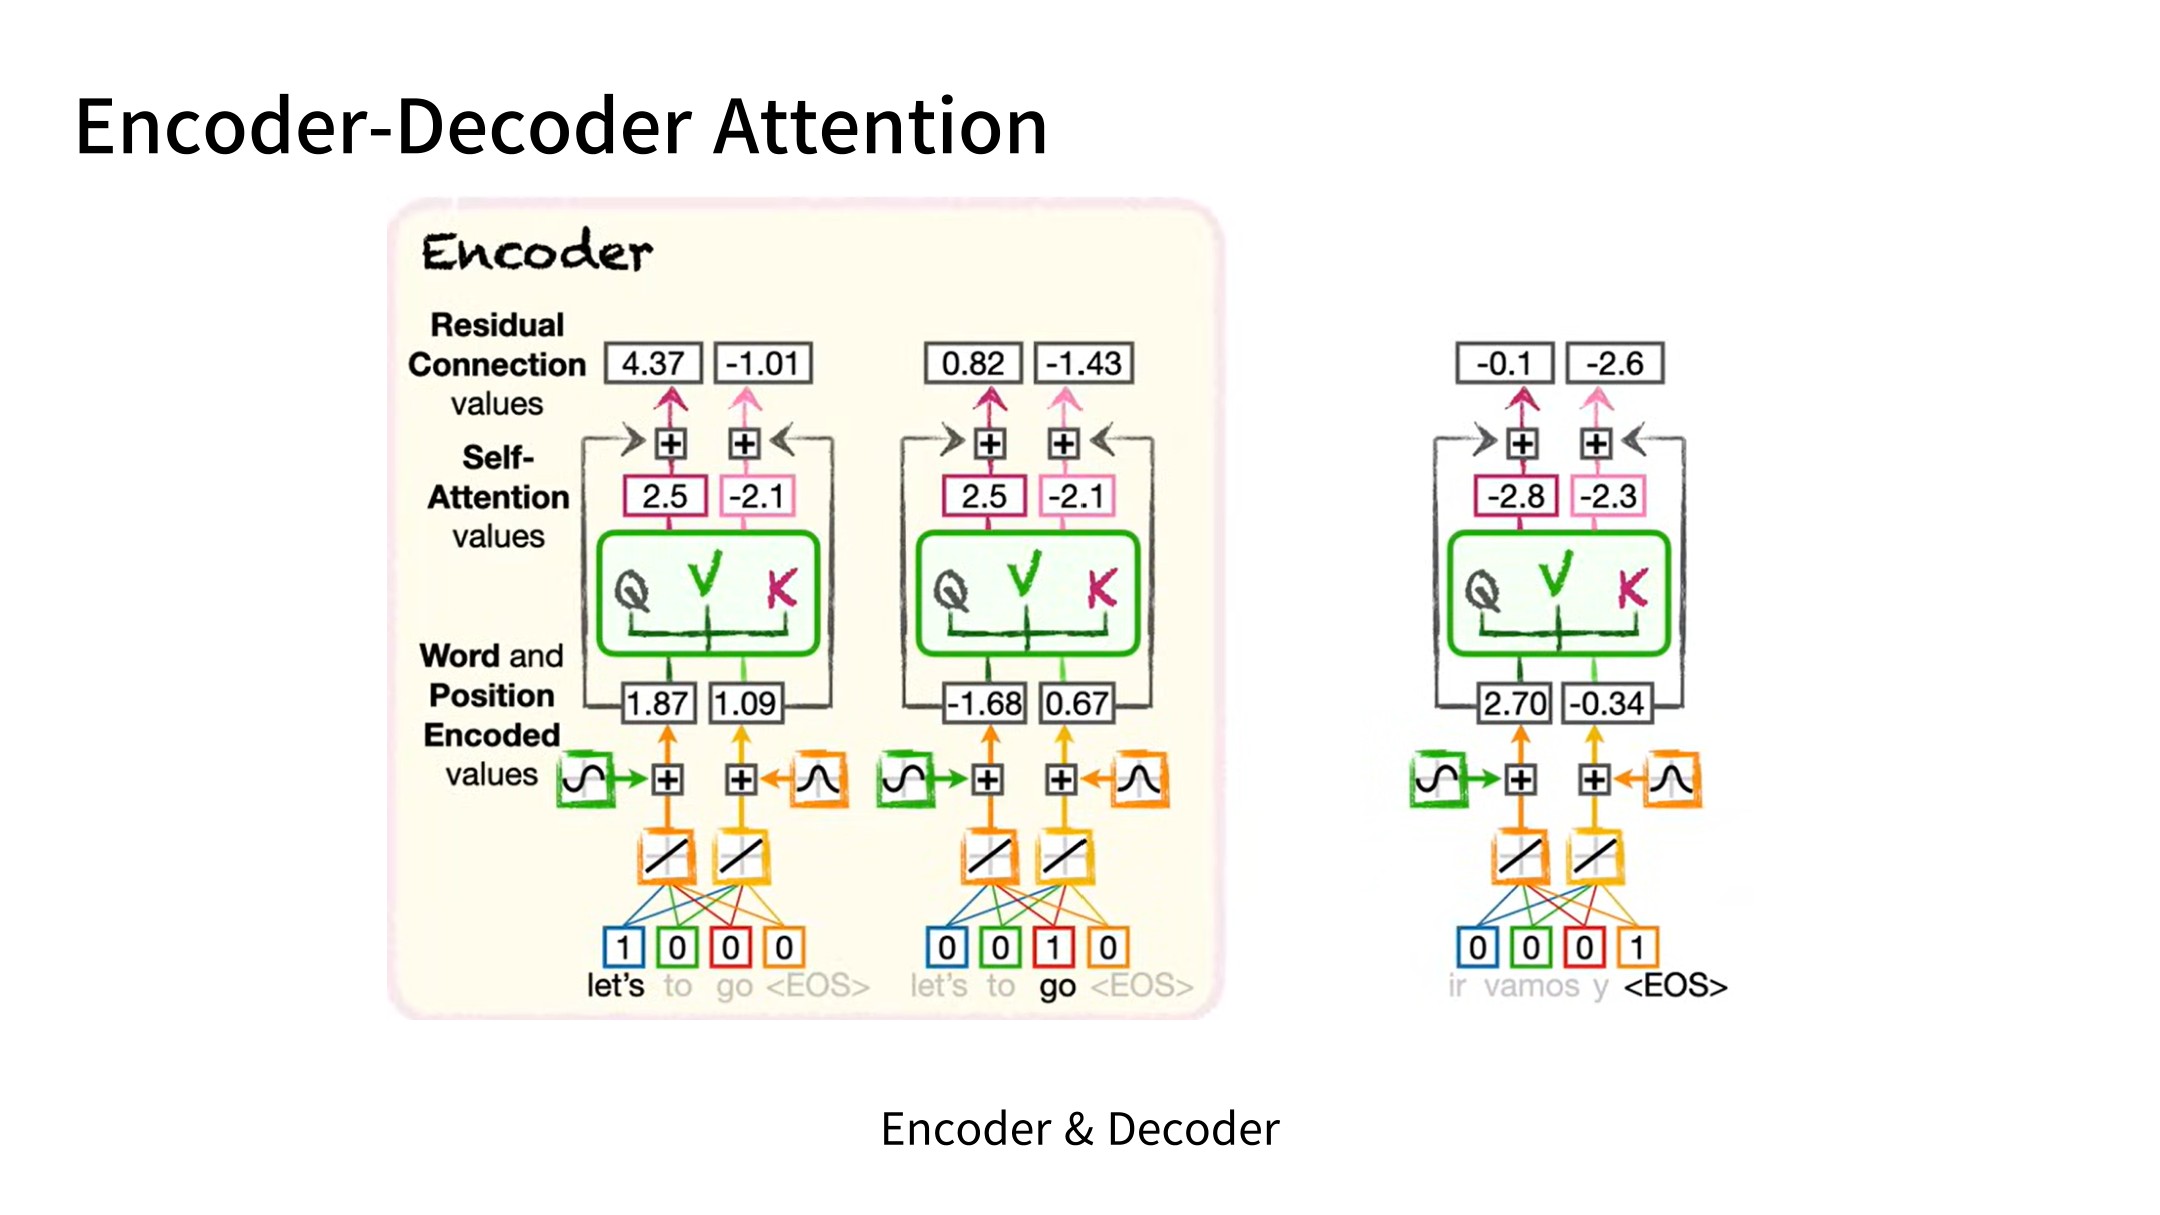
Slide 45: Encoder–Decoder Attention
Cross-Attention은 Decoder가 Encoder의 출력을 참고하는 단계입니다. 생성 중인 출력 문장과 입력 문장을 연결합니다.
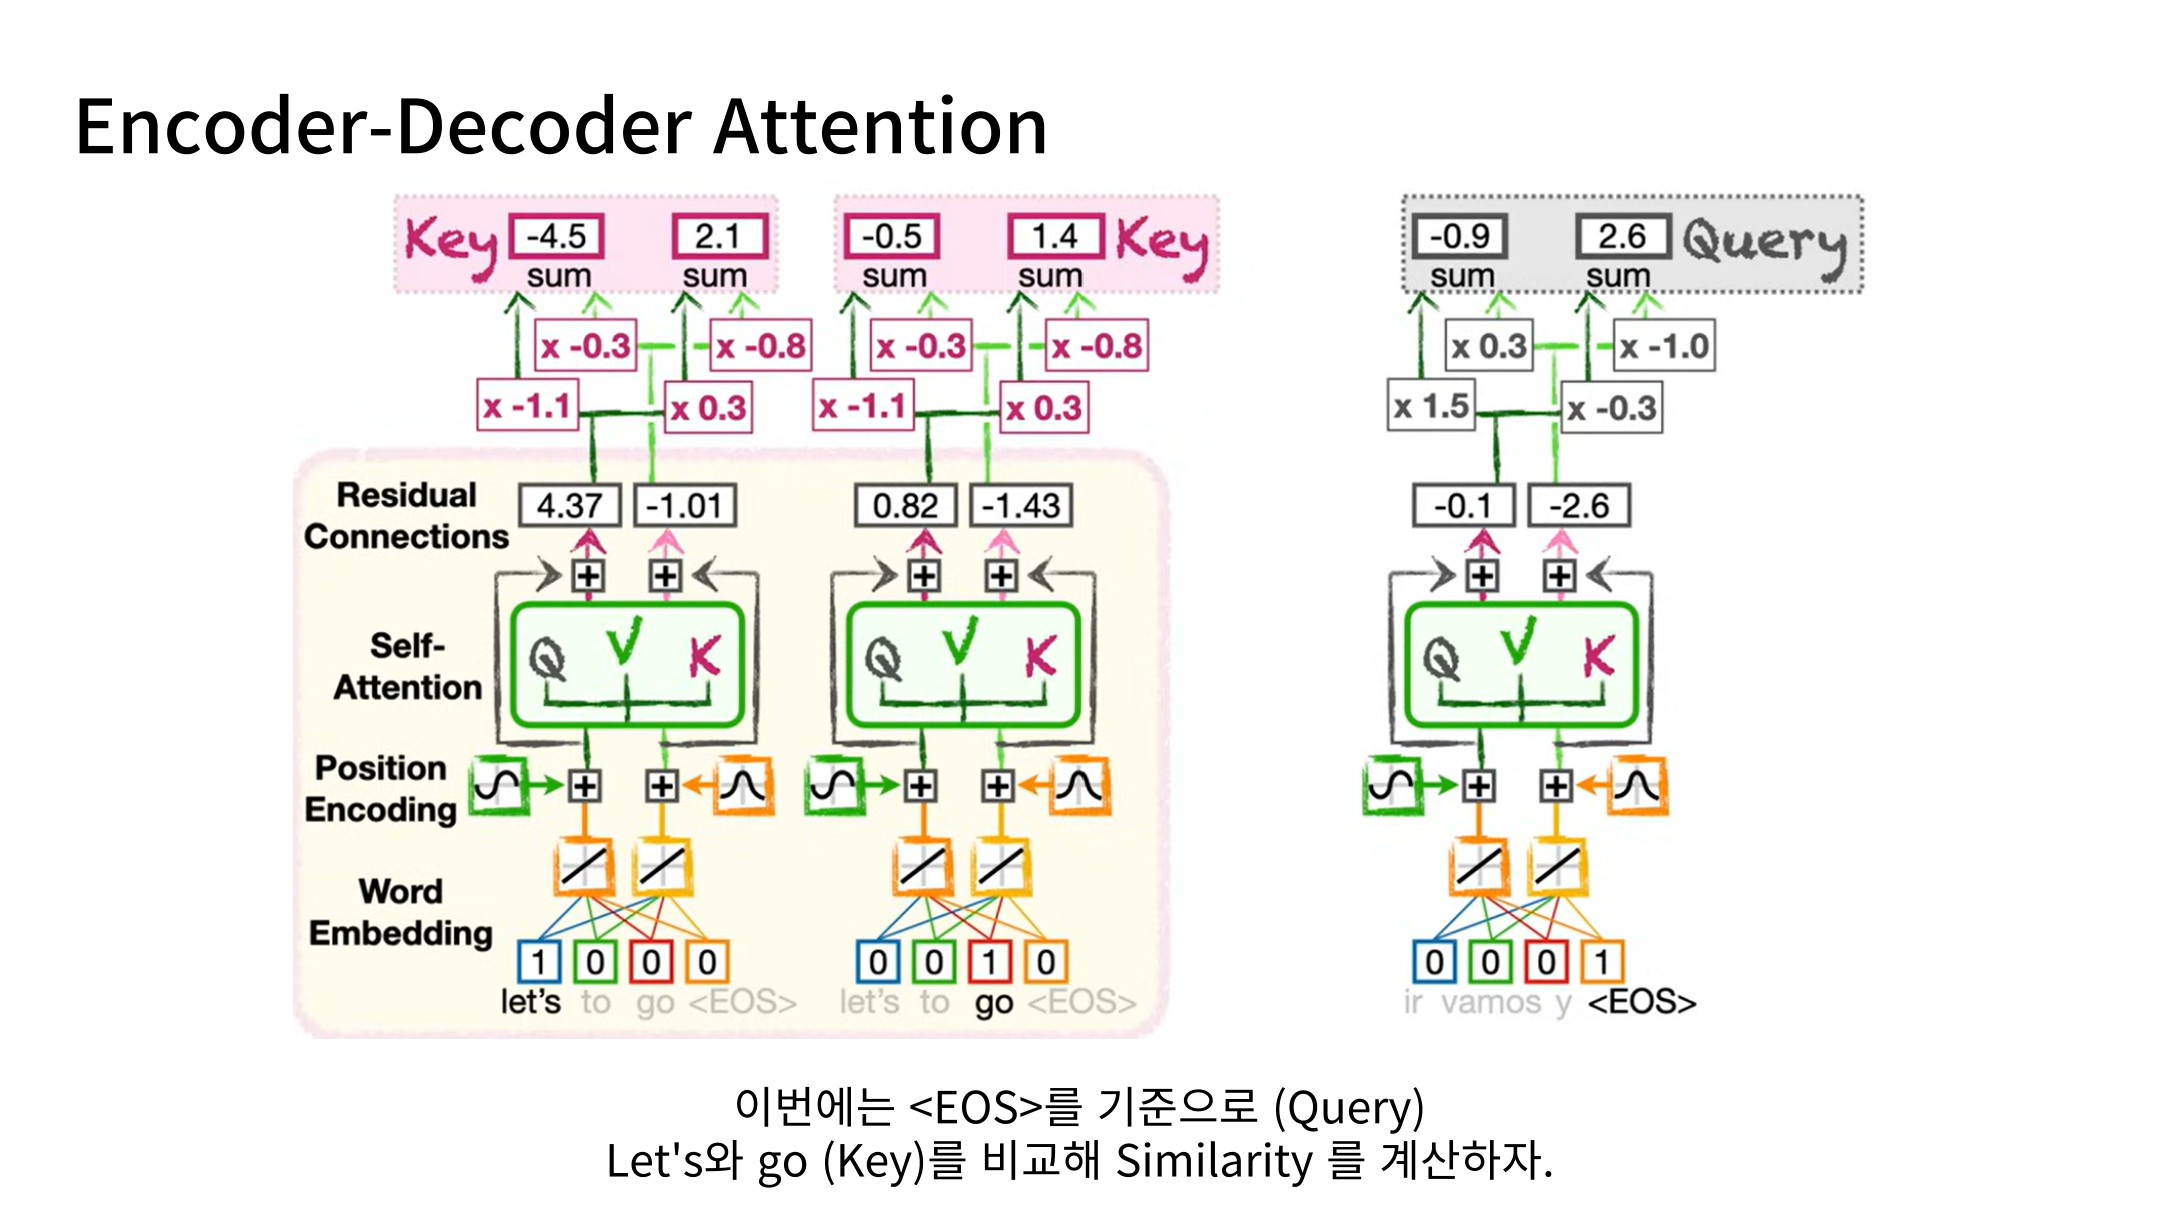
Slide 46: Cross-Attention의 Query와 Key
Query는 Decoder의 표현에서, Key와 Value는 Encoder의 출력에서 만들어집니다. 현재 생성하려는 토큰이 입력 문장의 어느 위치와 관련 있는지 비교합니다.
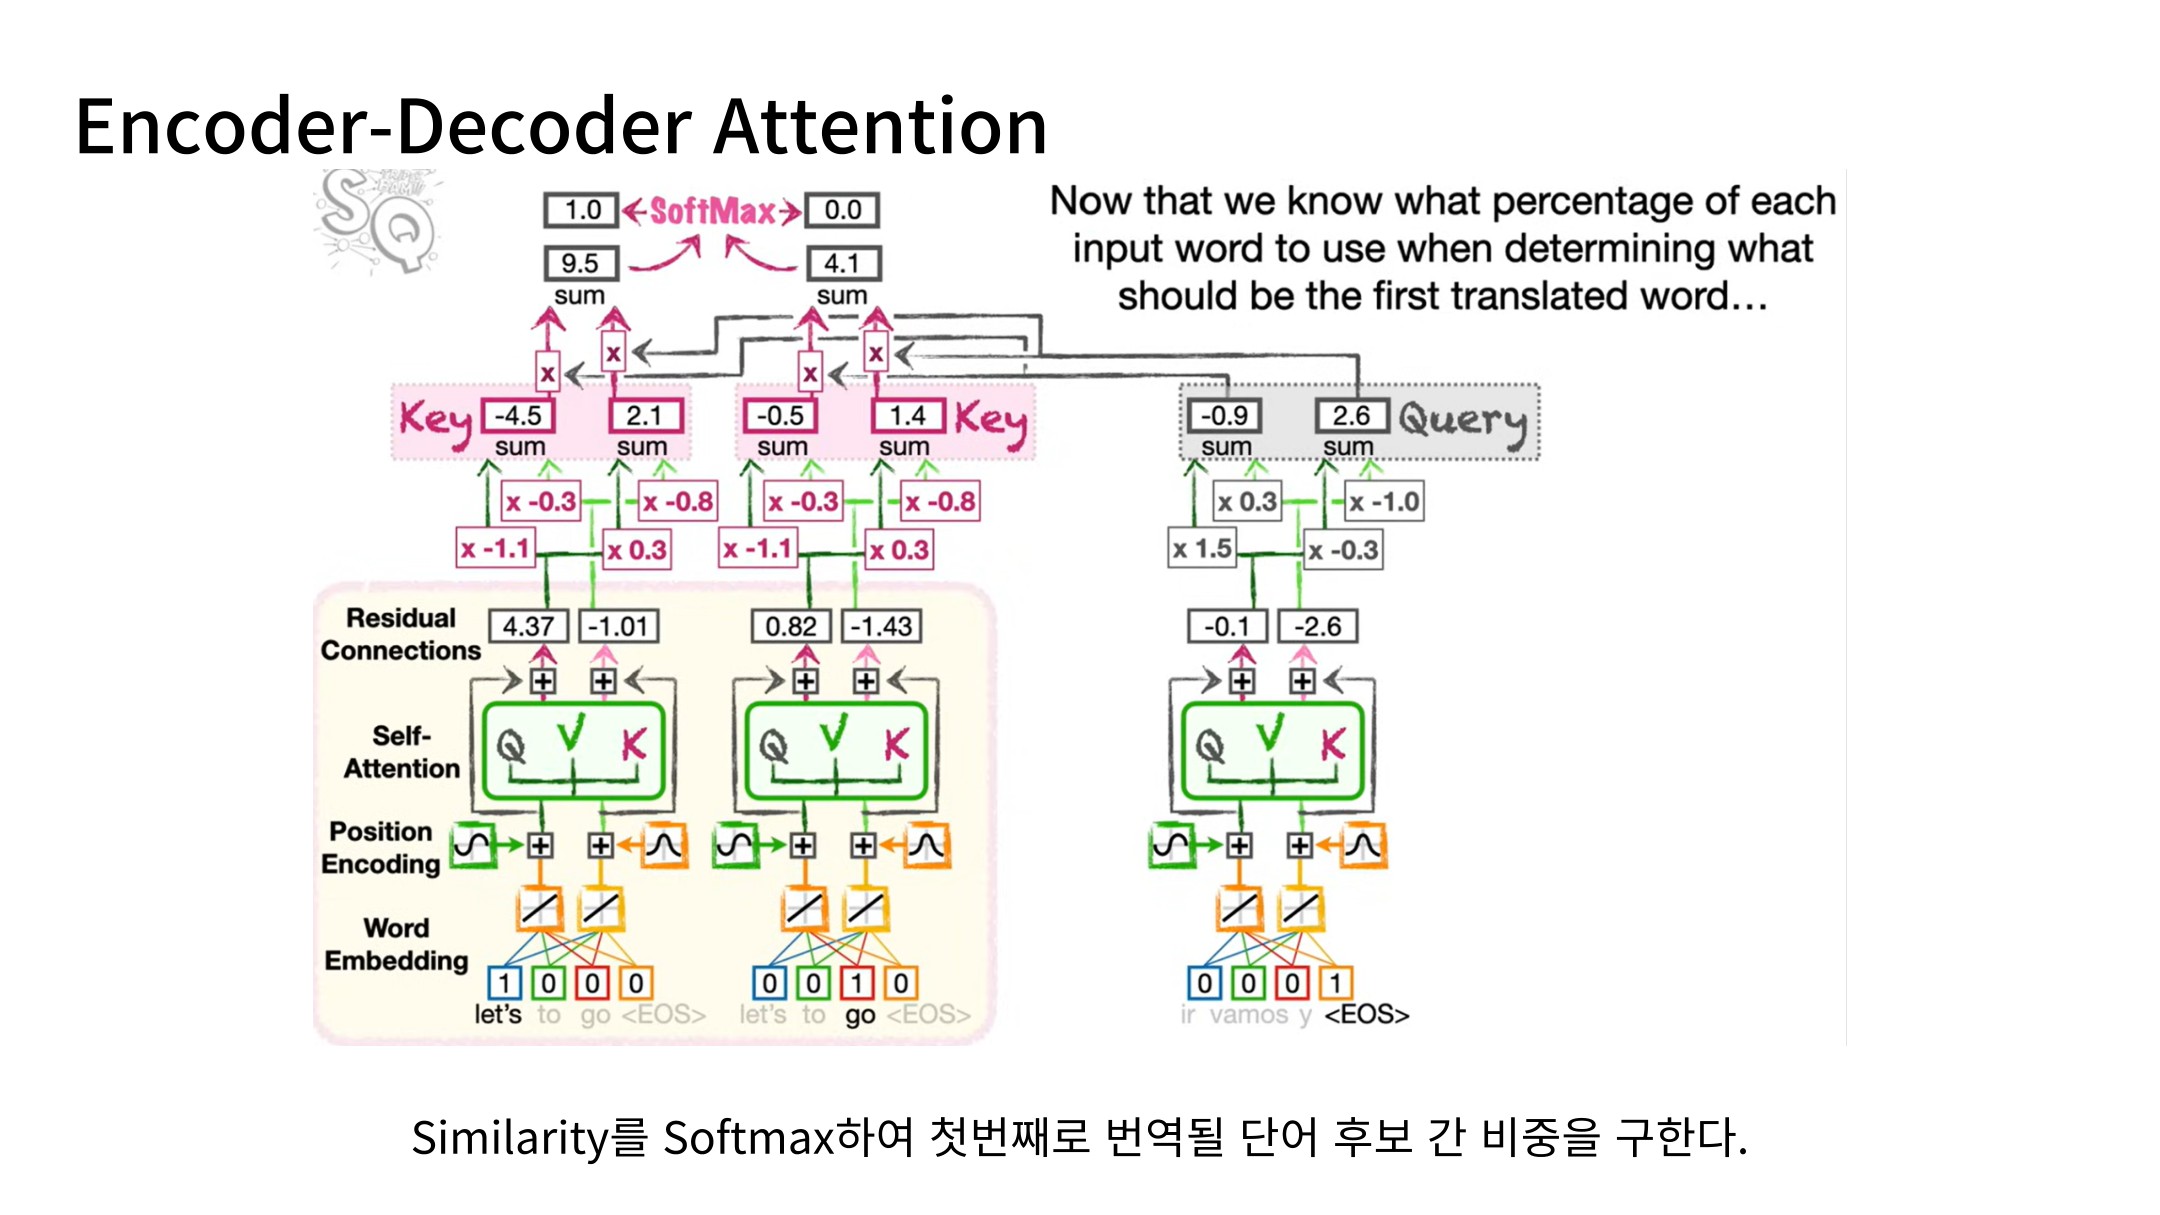
Slide 47: 입력 위치별 가중치
Decoder Query와 Encoder Key의 점수를 정규화합니다. 각 입력 위치에 배정된 가중치는 현재 출력 단계에서 참고할 비중을 나타냅니다.
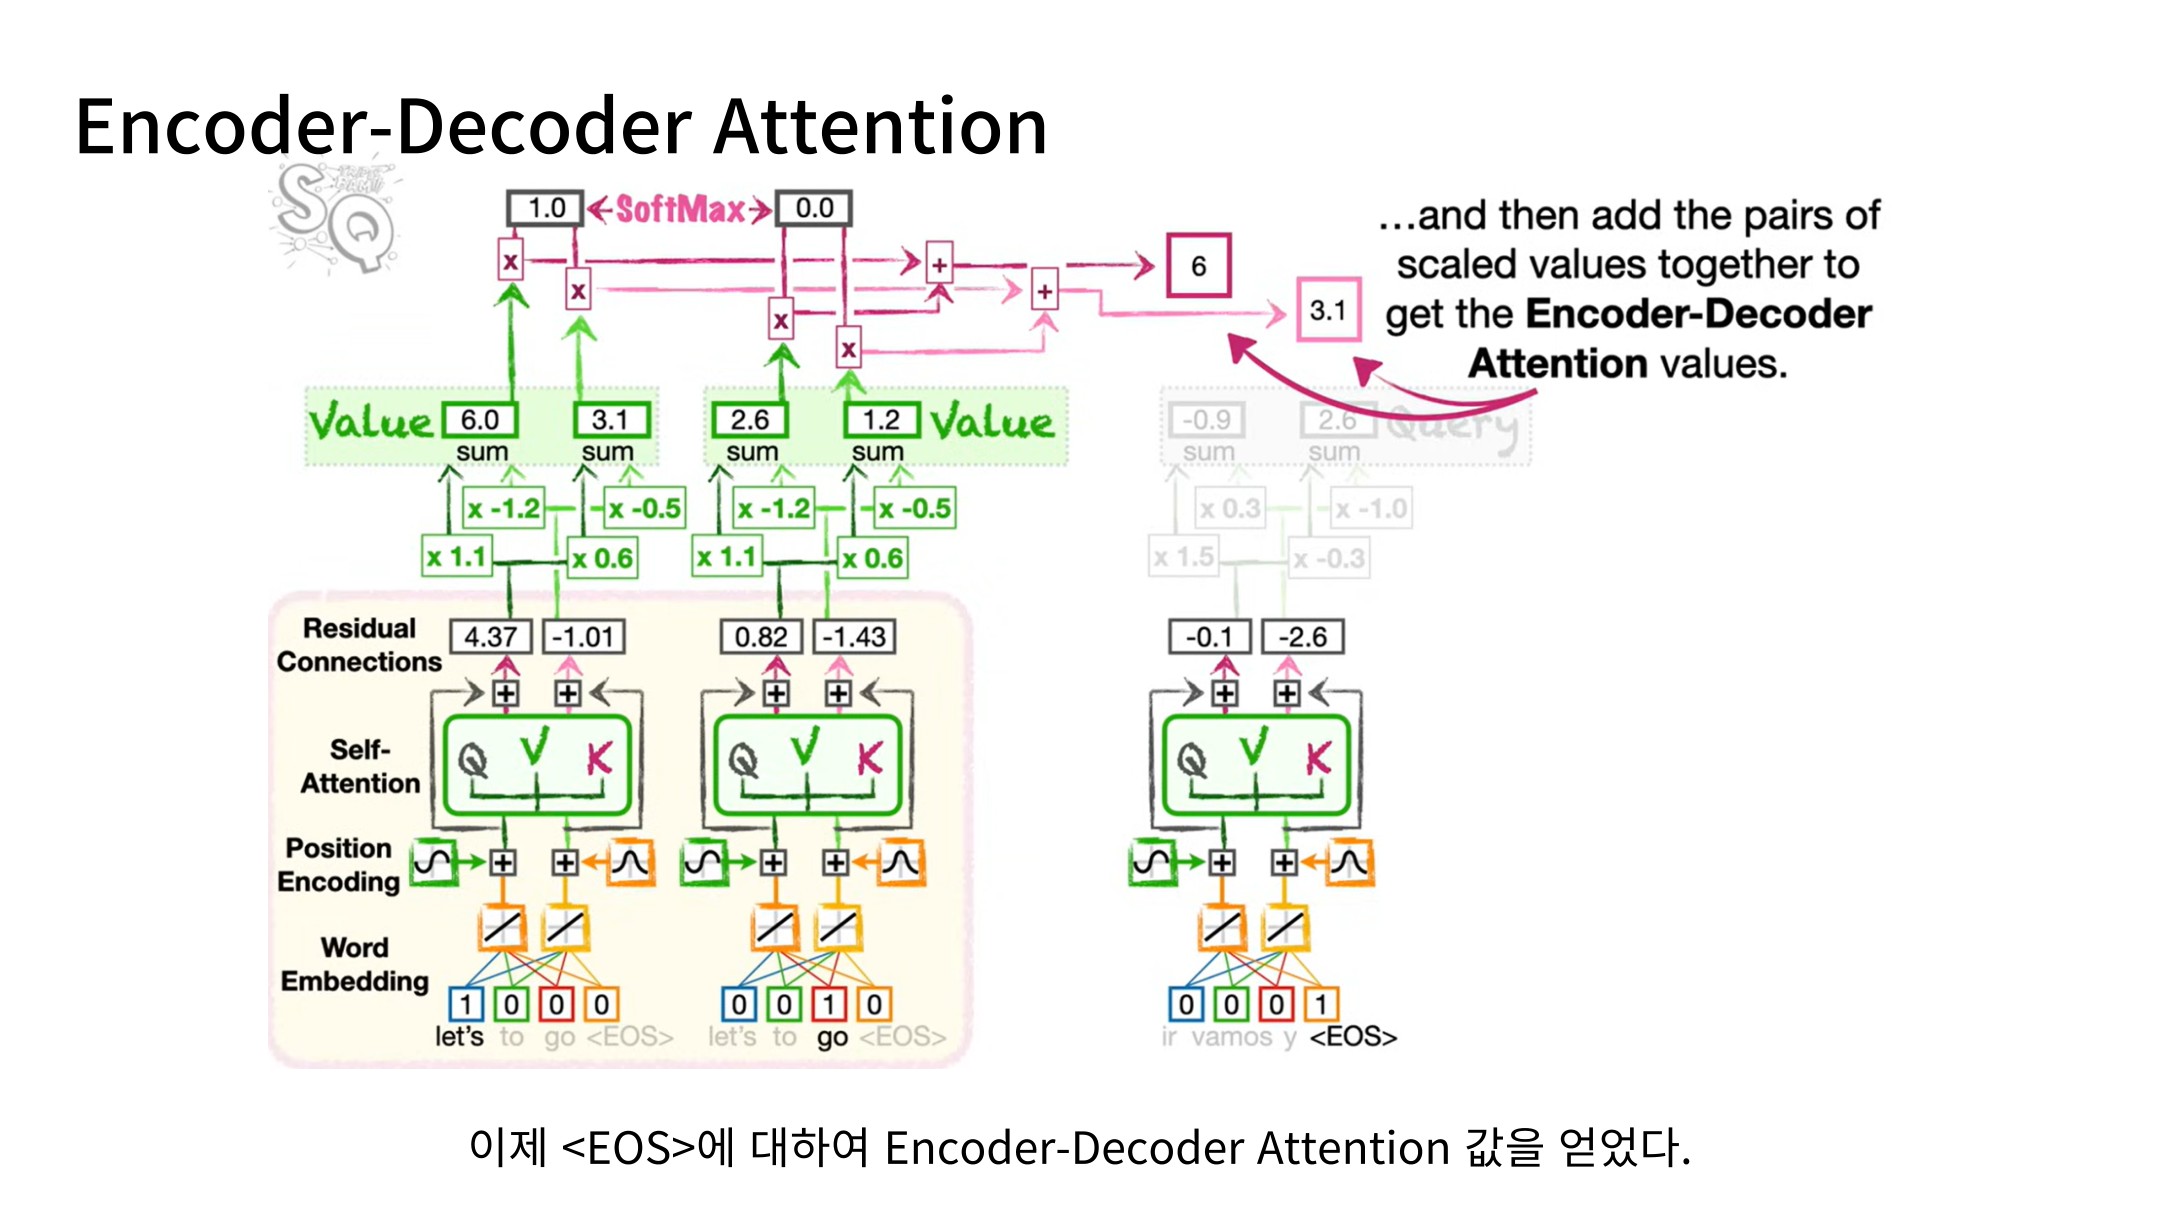
Slide 48: Encoder 정보의 가중합
Encoder에서 얻은 Value에 가중치를 적용해 Context를 만듭니다. Decoder는 입력 문장에서 필요한 정보를 선택적으로 받아들입니다.
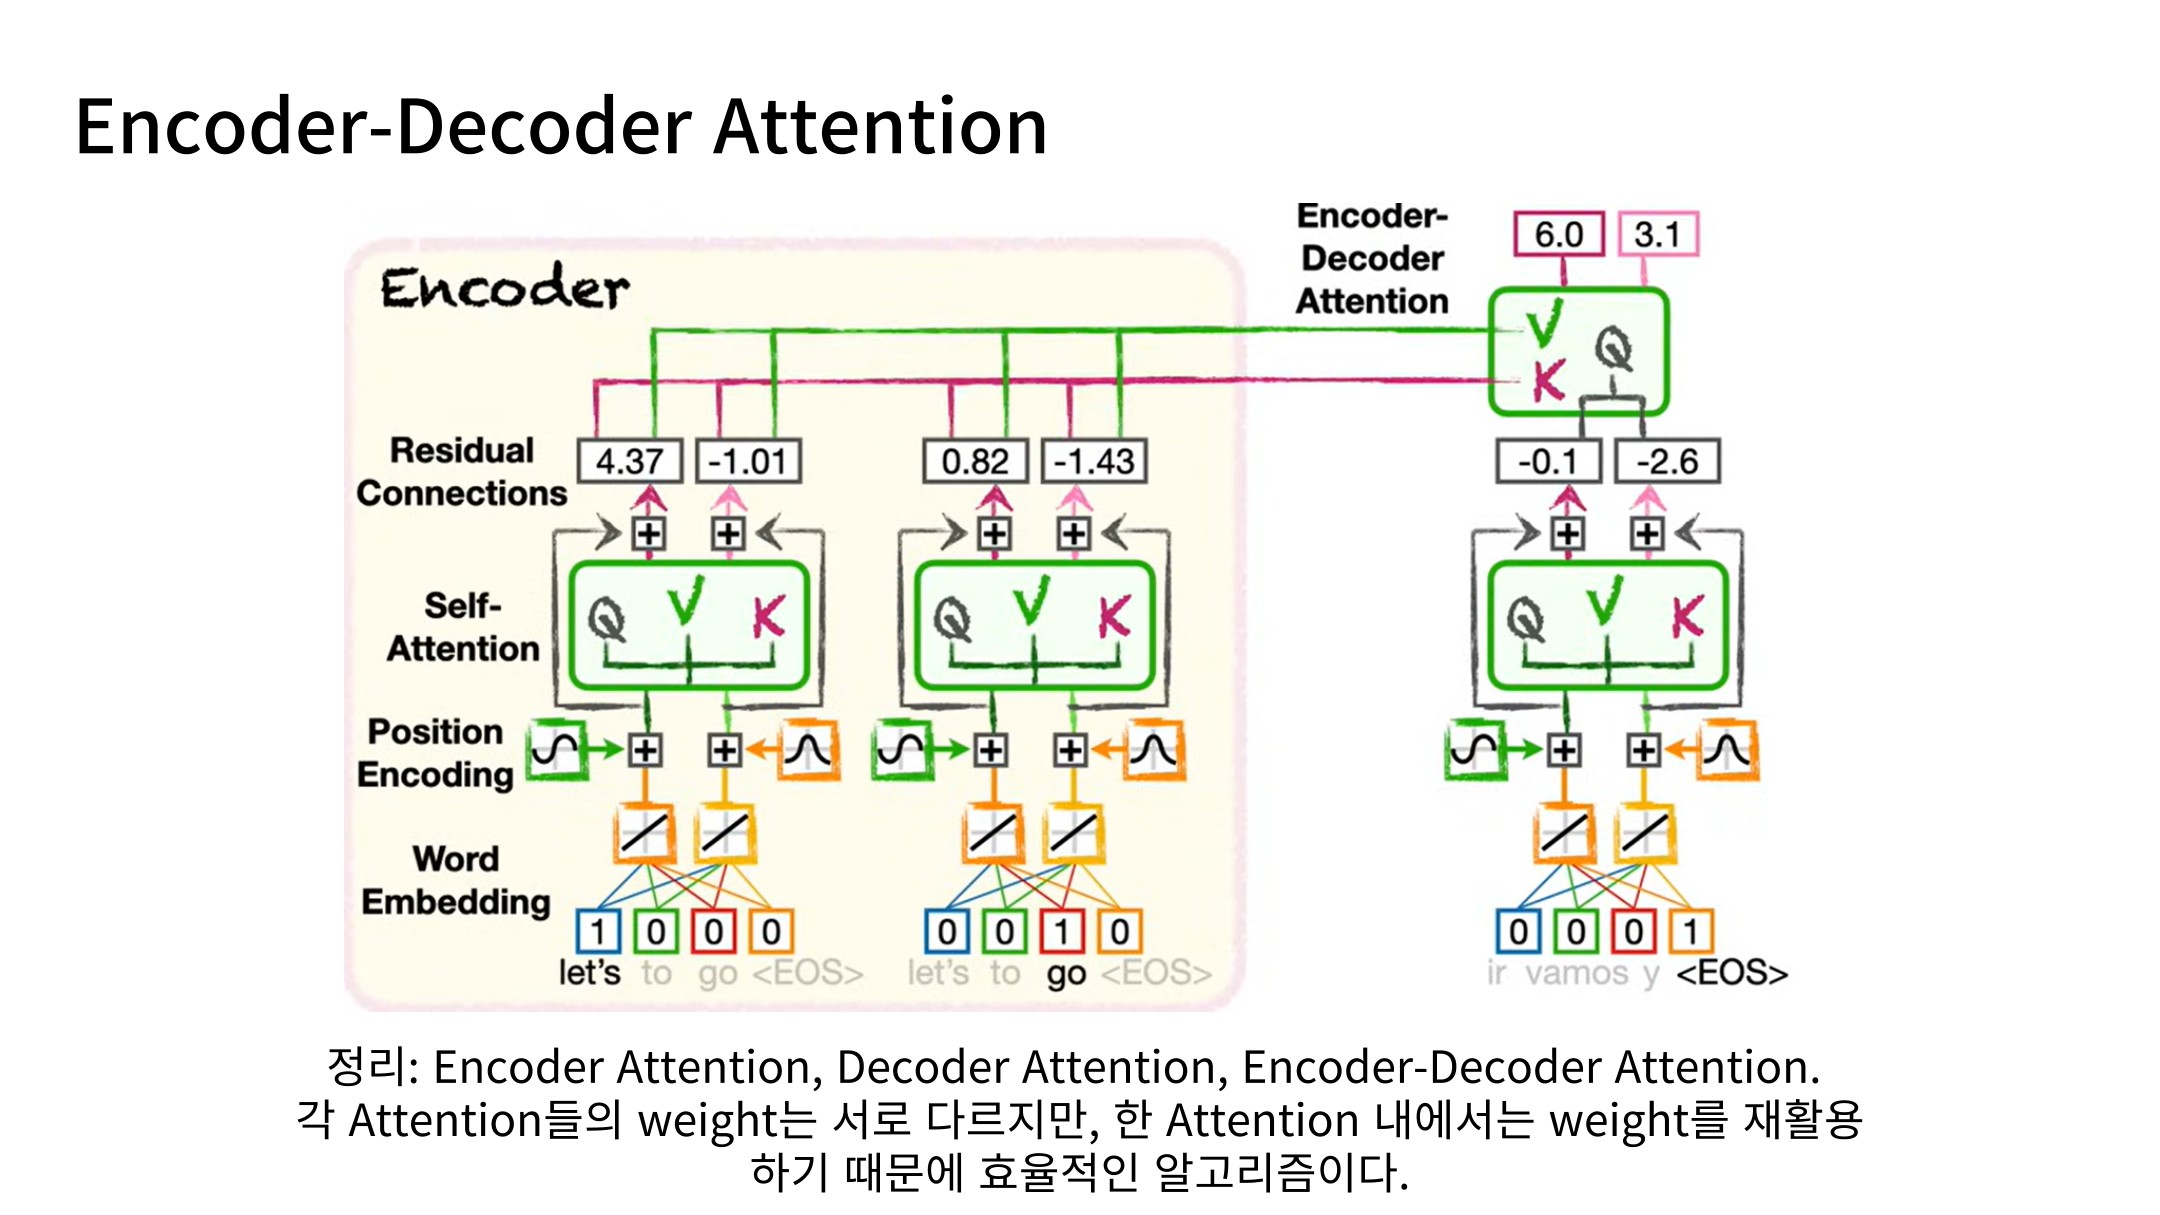
Slide 49: 세 가지 Attention의 역할
Encoder Self-Attention은 입력 내부 관계, Decoder Self-Attention은 출력의 이전 문맥, Cross-Attention은 입력과 출력 사이의 관계를 처리합니다. 각 모듈은 보통 별도의 가중치를 사용하며, 같은 모듈의 변환은 토큰 위치에 걸쳐 공유됩니다.
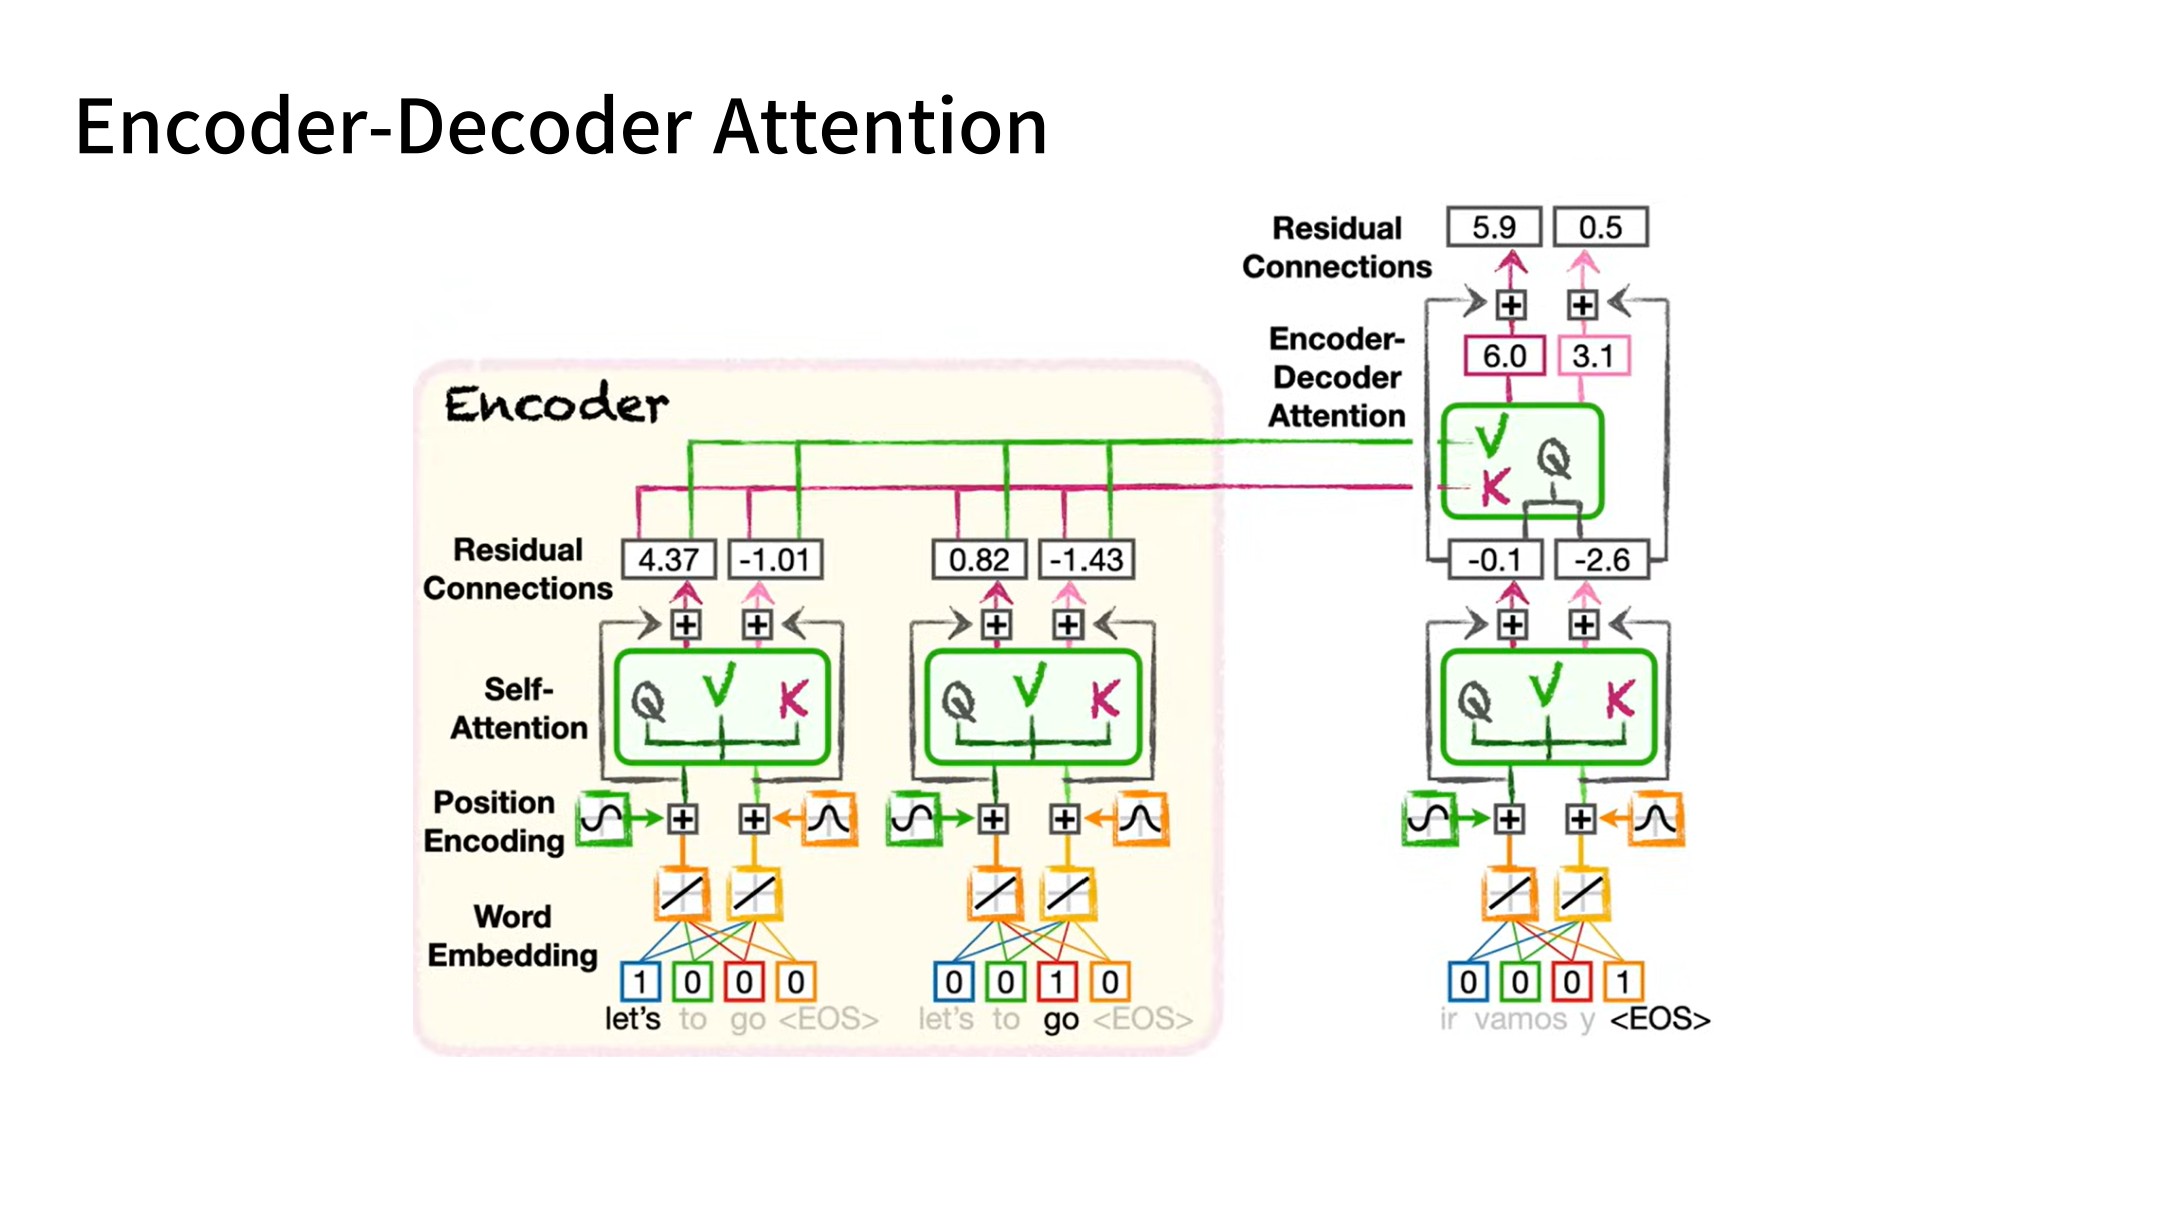
Slide 50: Decoder의 잔차 연결
Cross-Attention의 출력에도 잔차 연결을 적용합니다. 전체 Decoder 블록에서는 정규화와 Feed-Forward Network가 함께 사용됩니다.
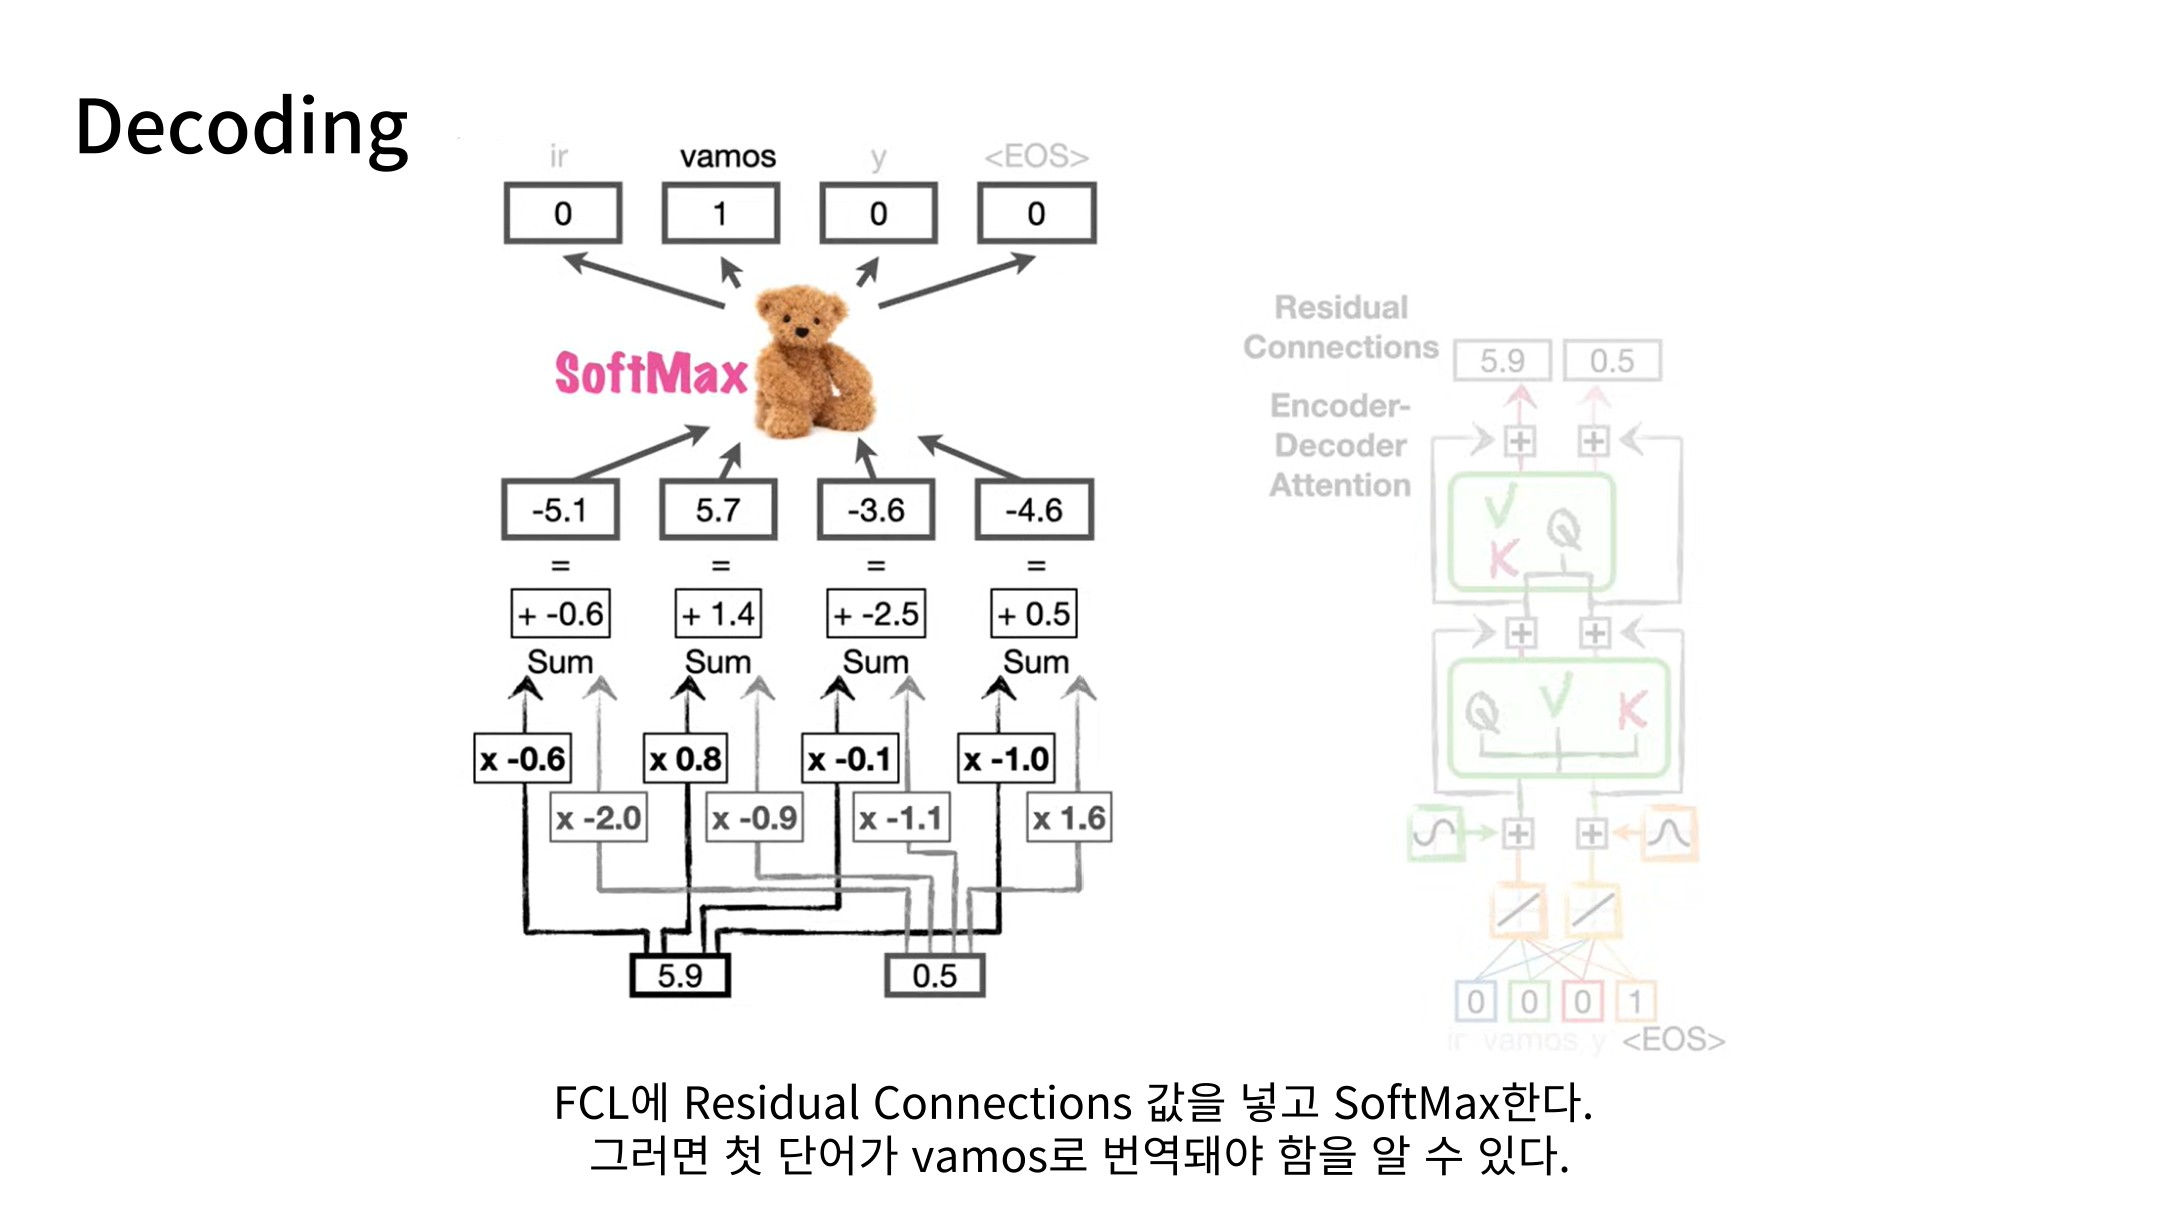
Slide 51: 첫 번째 토큰 예측
Decoder의 최종 표현을 어휘 집합 크기의 점수 벡터로 변환하고 Softmax를 적용합니다. 예시에서는 첫 번역 토큰으로 “vamos”를 얻습니다.
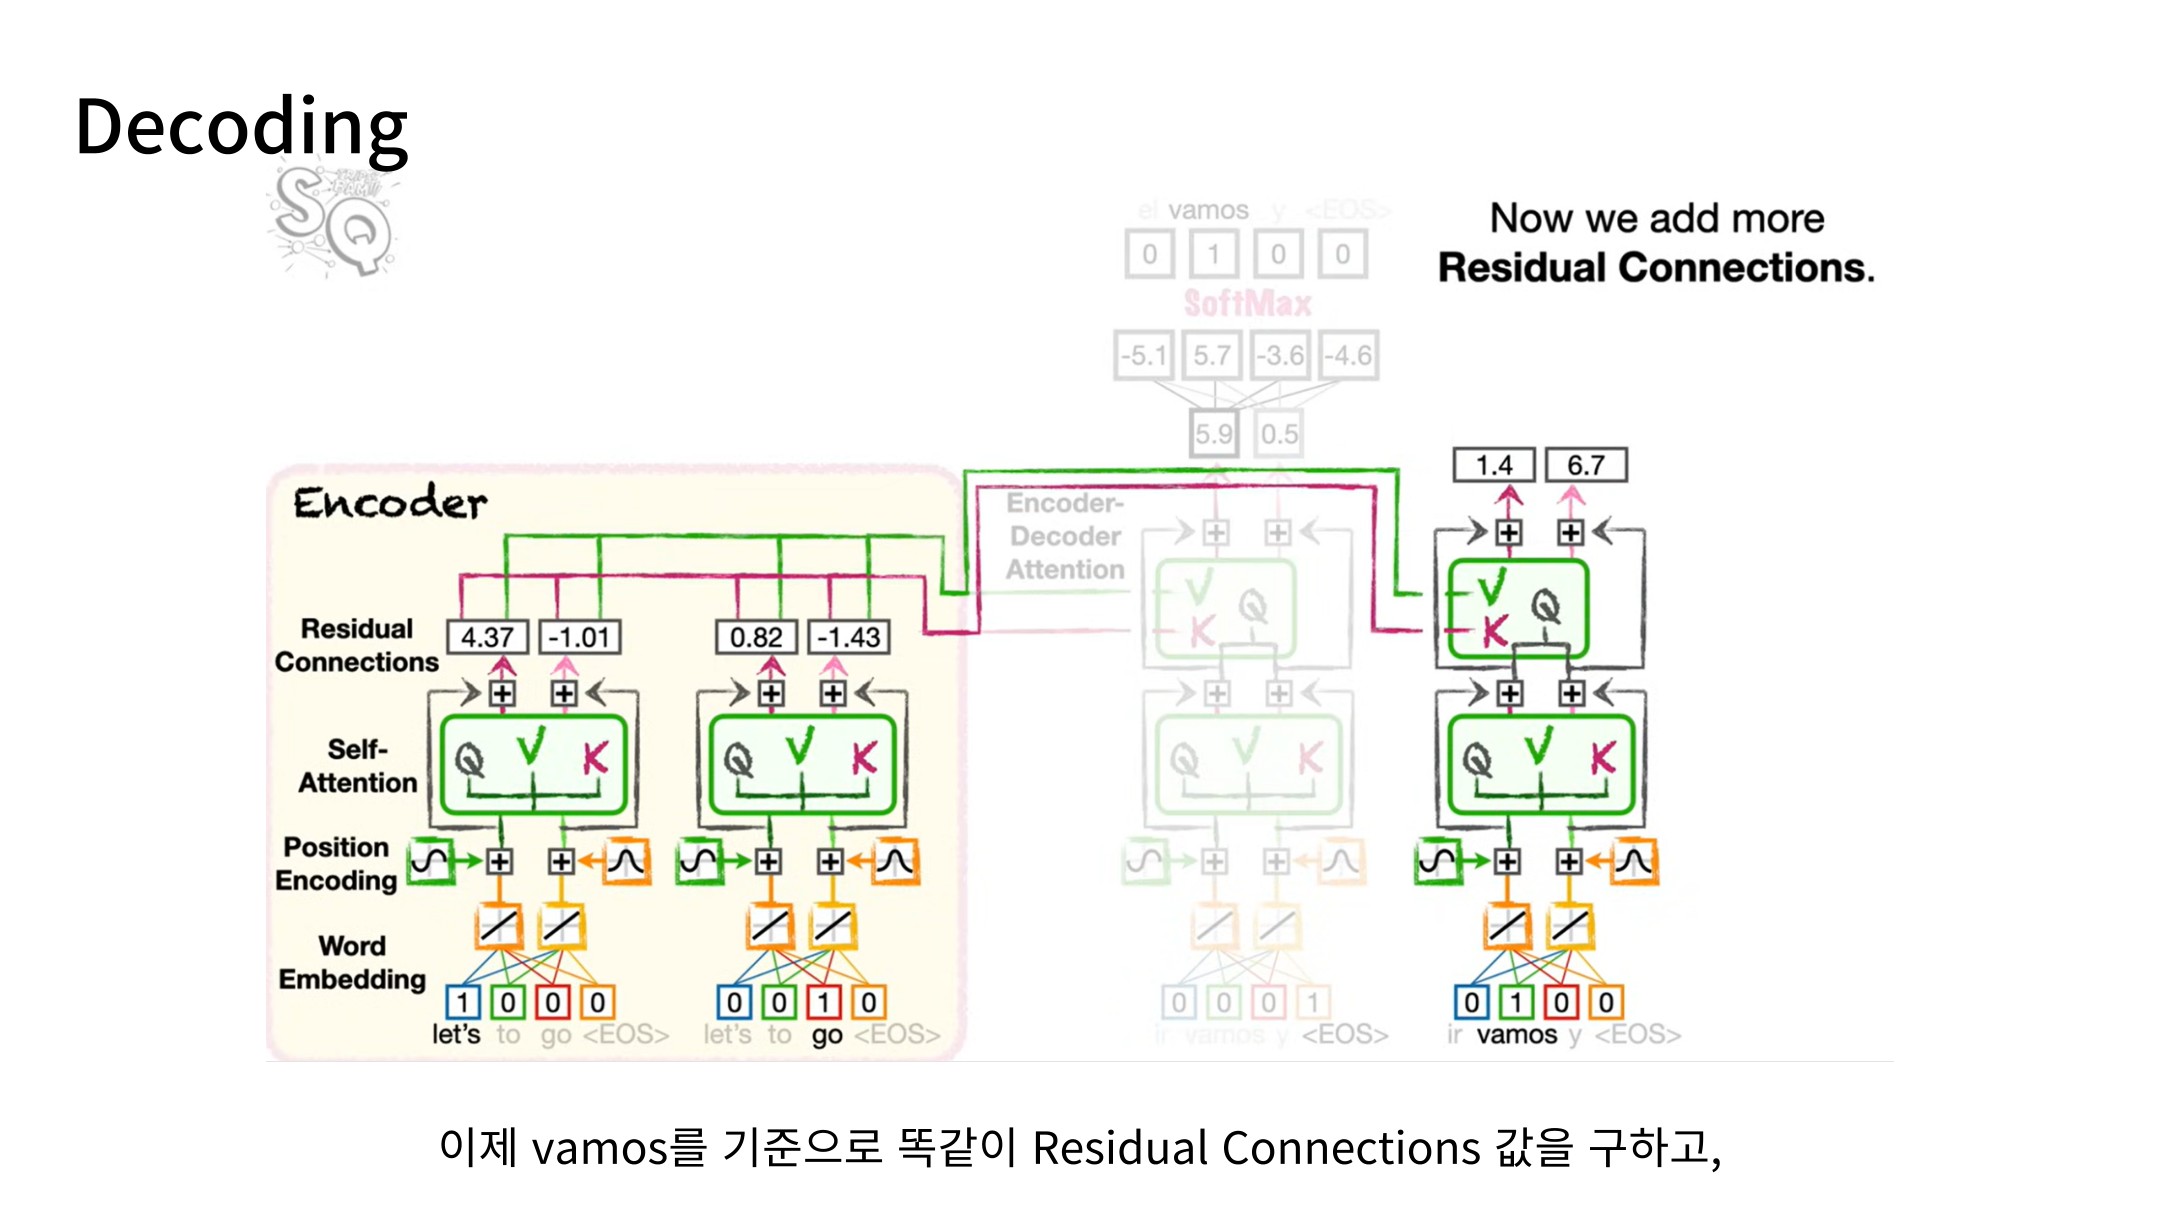
Slide 52: 다음 생성 단계
이전에 생성한 토큰을 다음 단계의 문맥에 포함합니다. 학습 시 정답의 이전 토큰을 주는 Teacher Forcing과 실제 추론 시 생성한 토큰을 사용하는 과정은 구분해야 합니다.
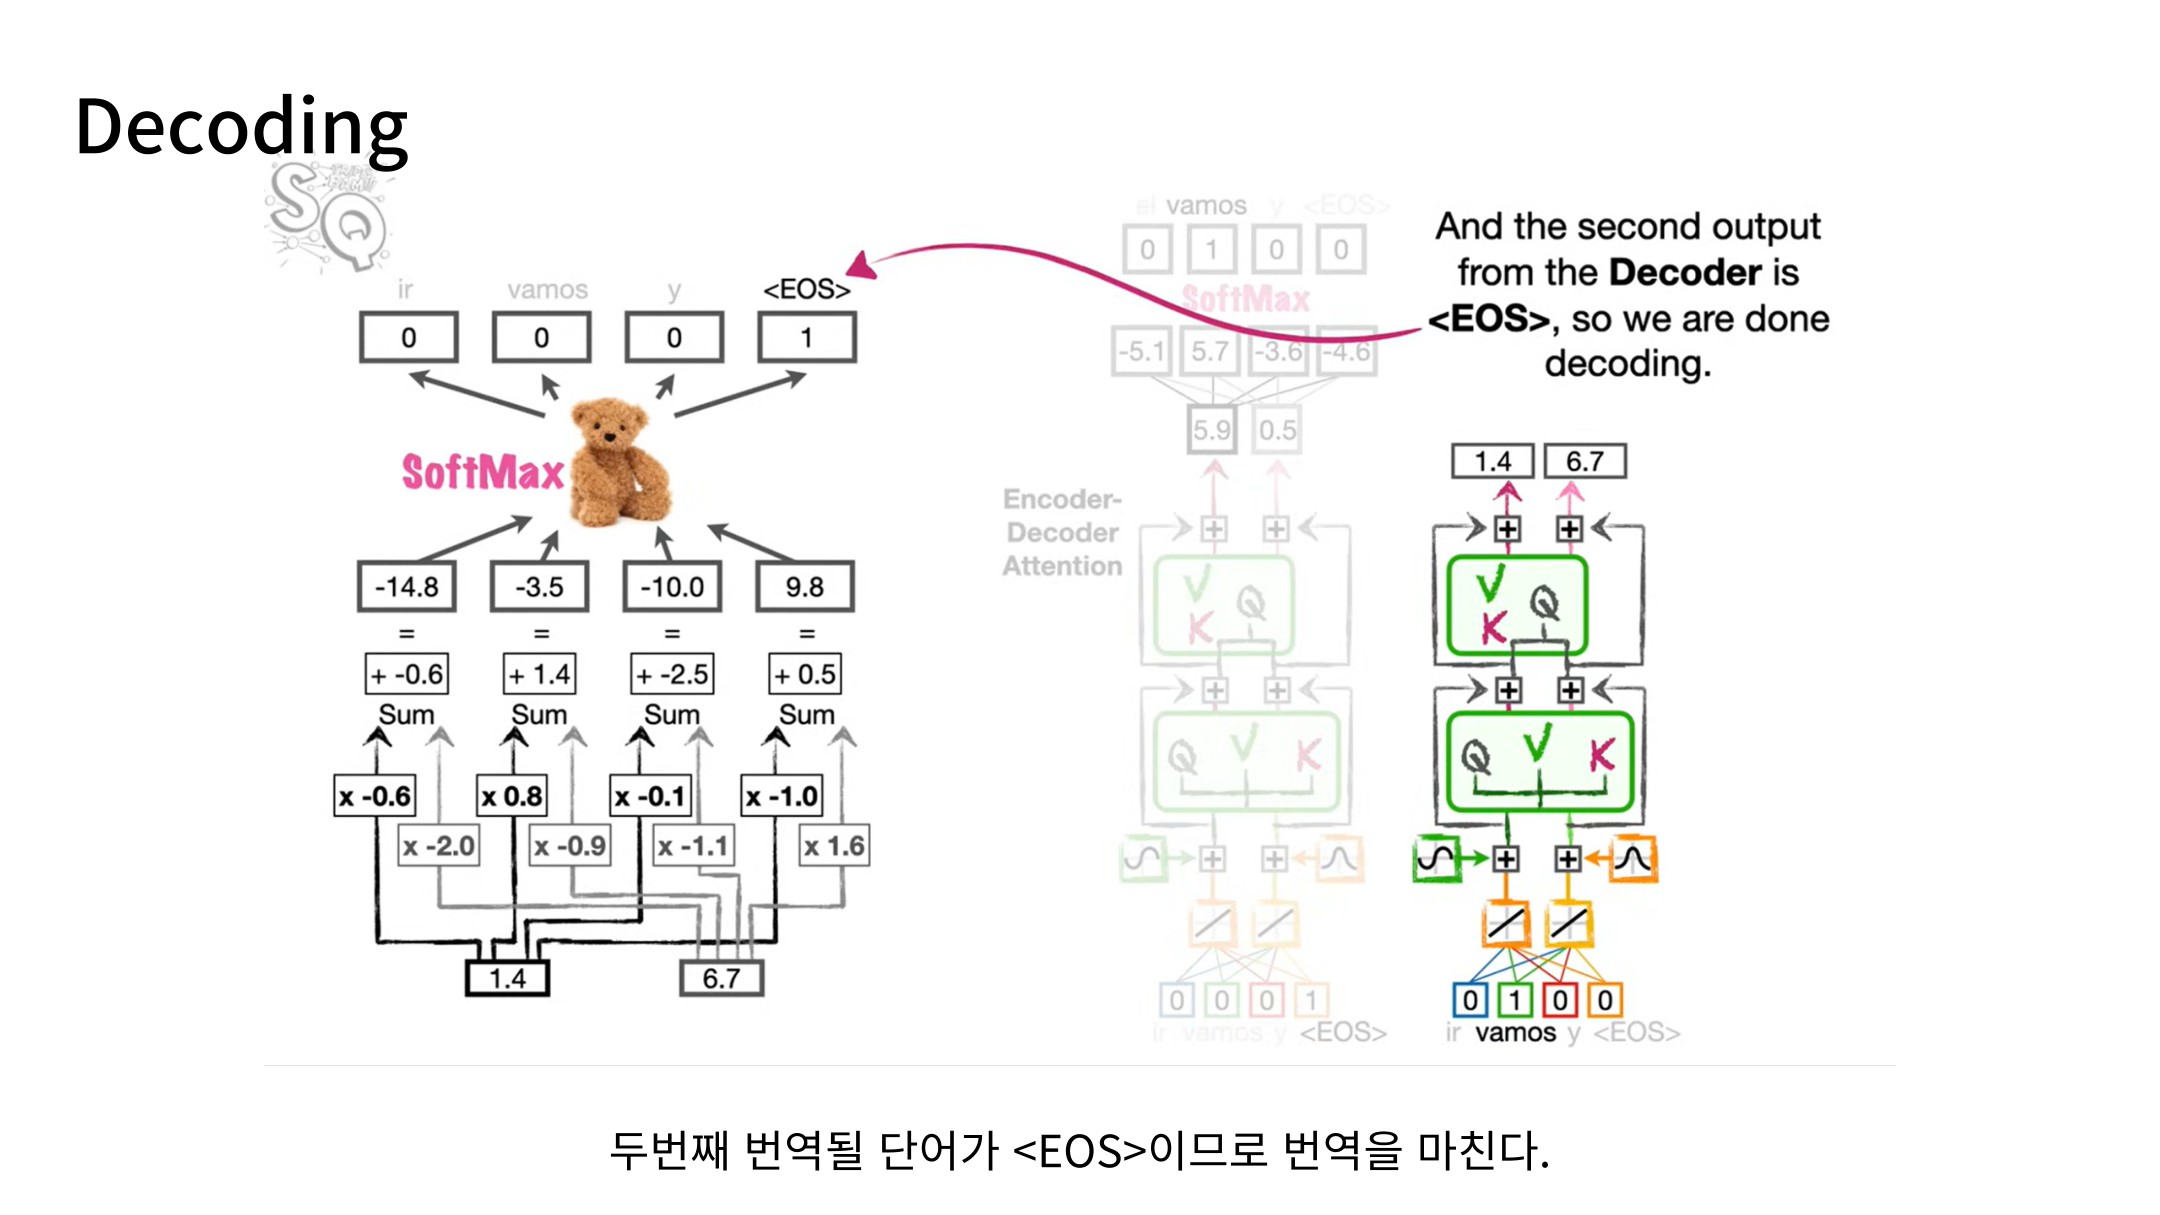
Slide 53: 종료 토큰 예측
다음 토큰이 종료 토큰이면 생성을 멈춥니다. 실제 추론에서는 탐욕적 선택, Beam Search, 샘플링 등 목적에 맞는 생성 전략을 사용할 수 있습니다.
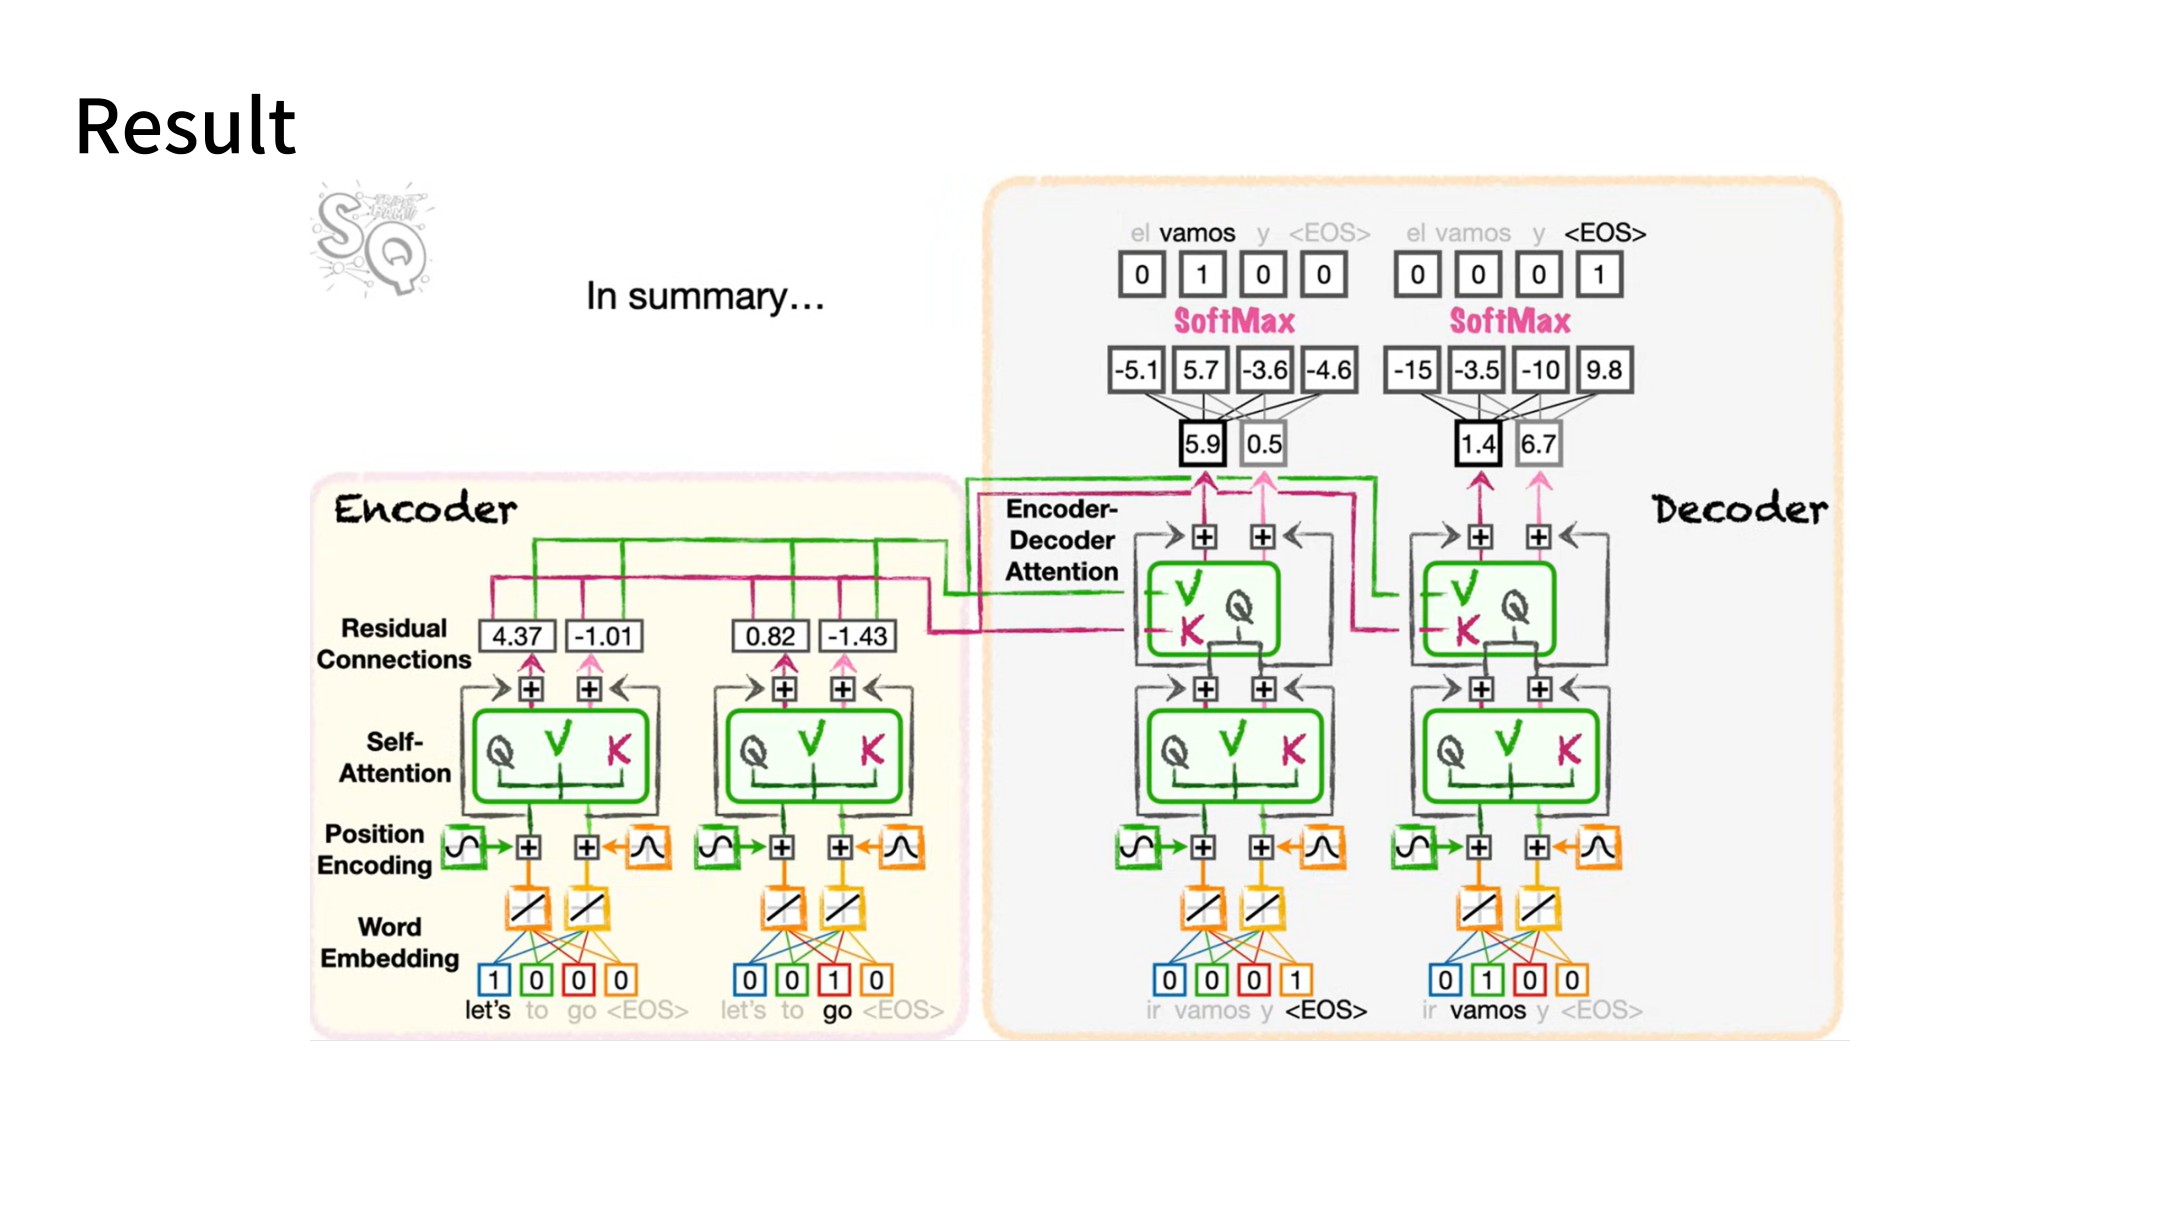
Slide 54: Encoder–Decoder 전체 흐름
입력 표현 생성, 출력 문맥 처리, 입력 참조, 다음 토큰 예측이 하나의 흐름으로 연결됩니다. 학습에서는 마스킹을 통해 여러 출력 위치를 병렬 계산할 수 있지만, 자기회귀 추론은 토큰을 순차 생성합니다.
Slide 55: Encoder-Only Transformer: BERT
마지막 부분에서는 Encoder만 사용하는 BERT를 살펴봅니다. 이 부분의 그림은 발표 자료에 명시된 StatQuest YouTube Channel을 참고합니다.
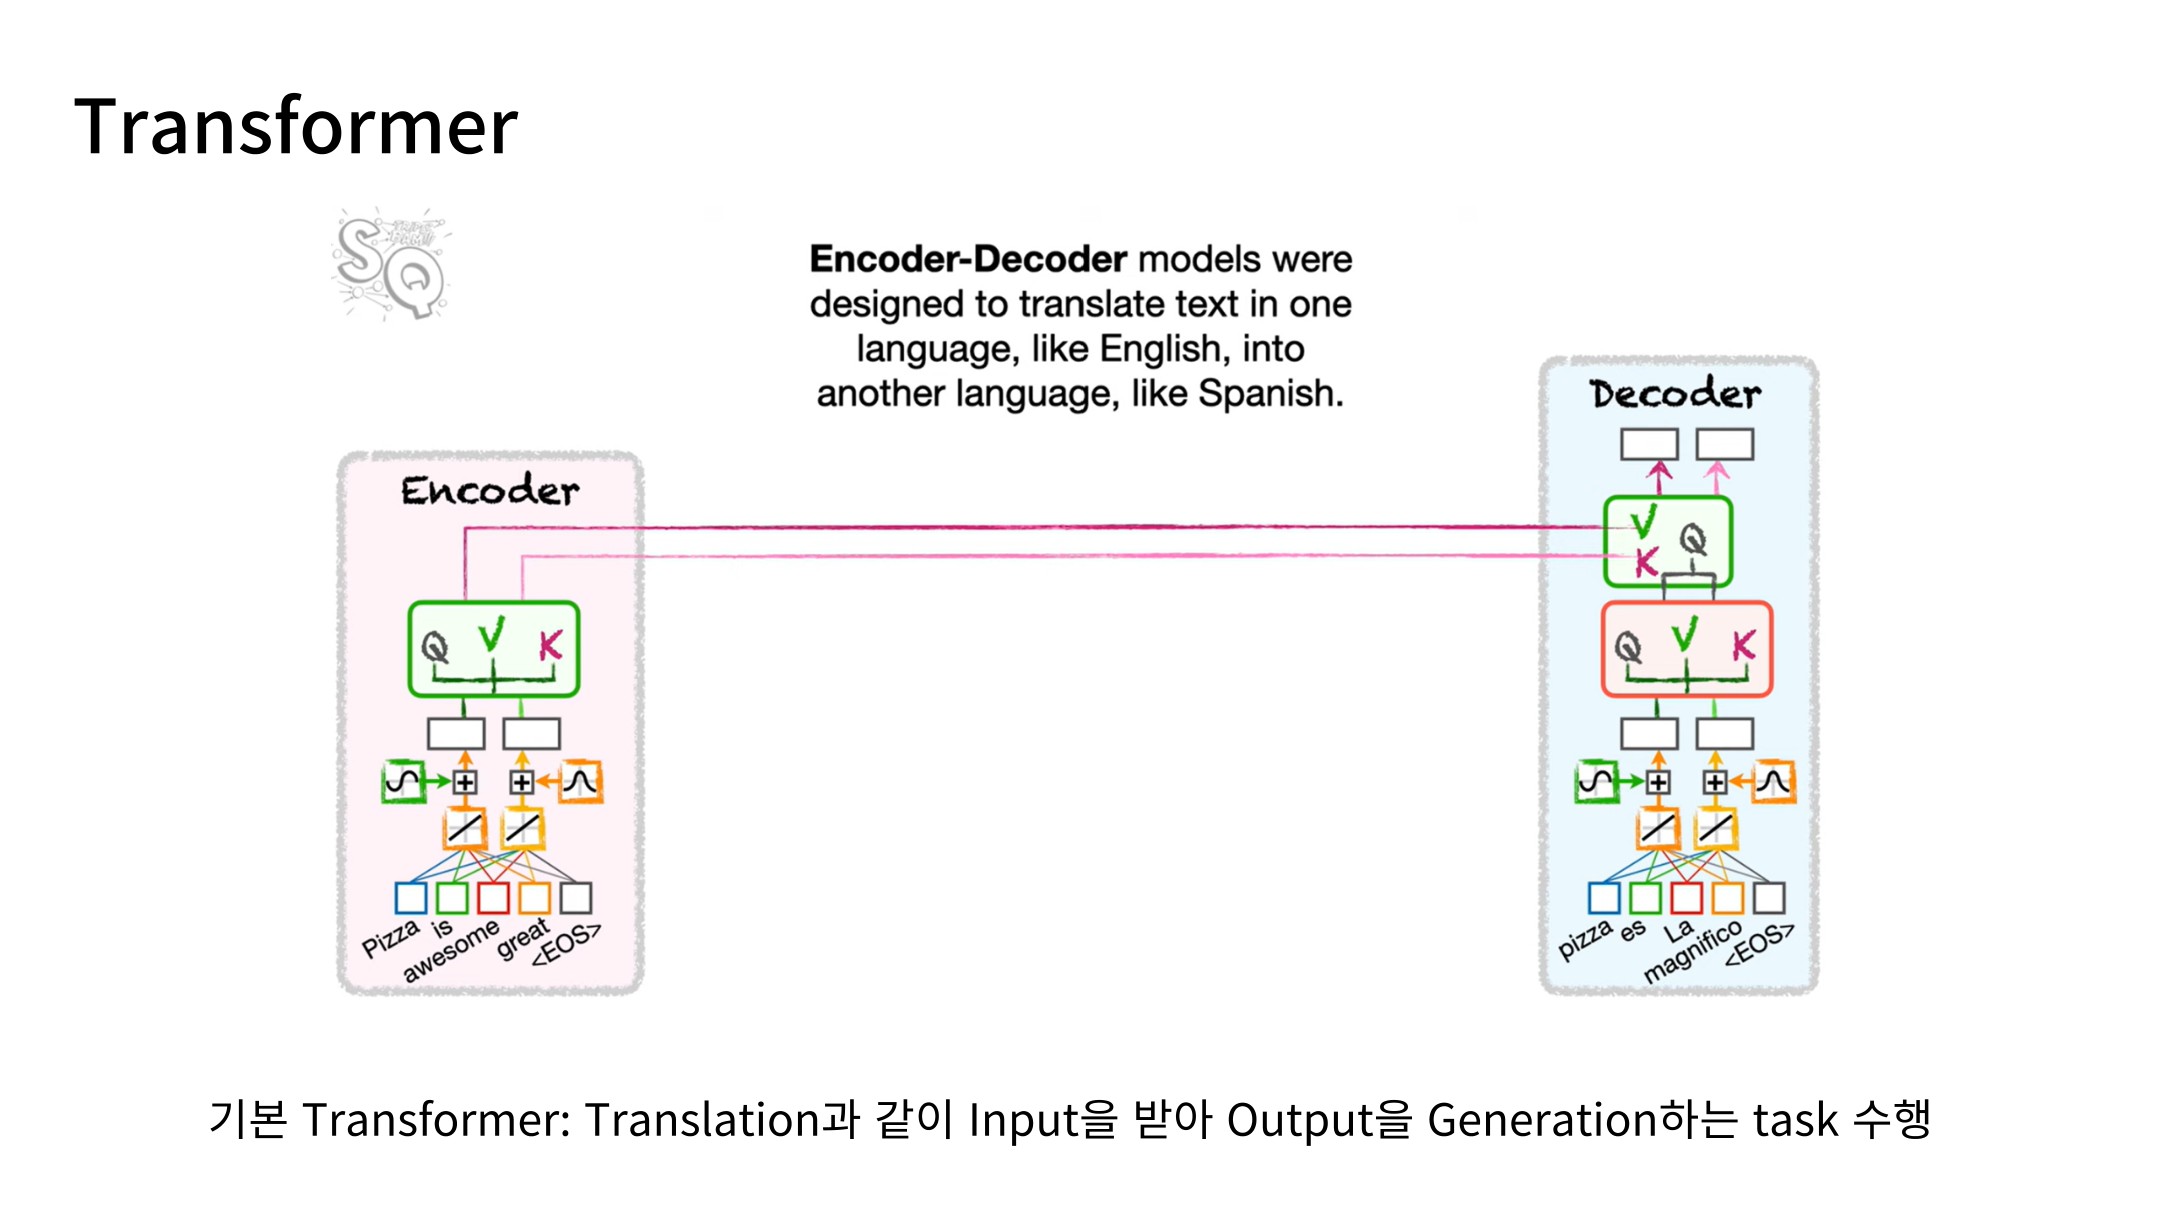
Slide 56: Encoder–Decoder Transformer
원래 Transformer는 번역처럼 입력 시퀀스를 받아 출력 시퀀스를 만드는 과제를 위해 제안되었습니다. Encoder와 Decoder가 서로 다른 역할을 맡습니다.
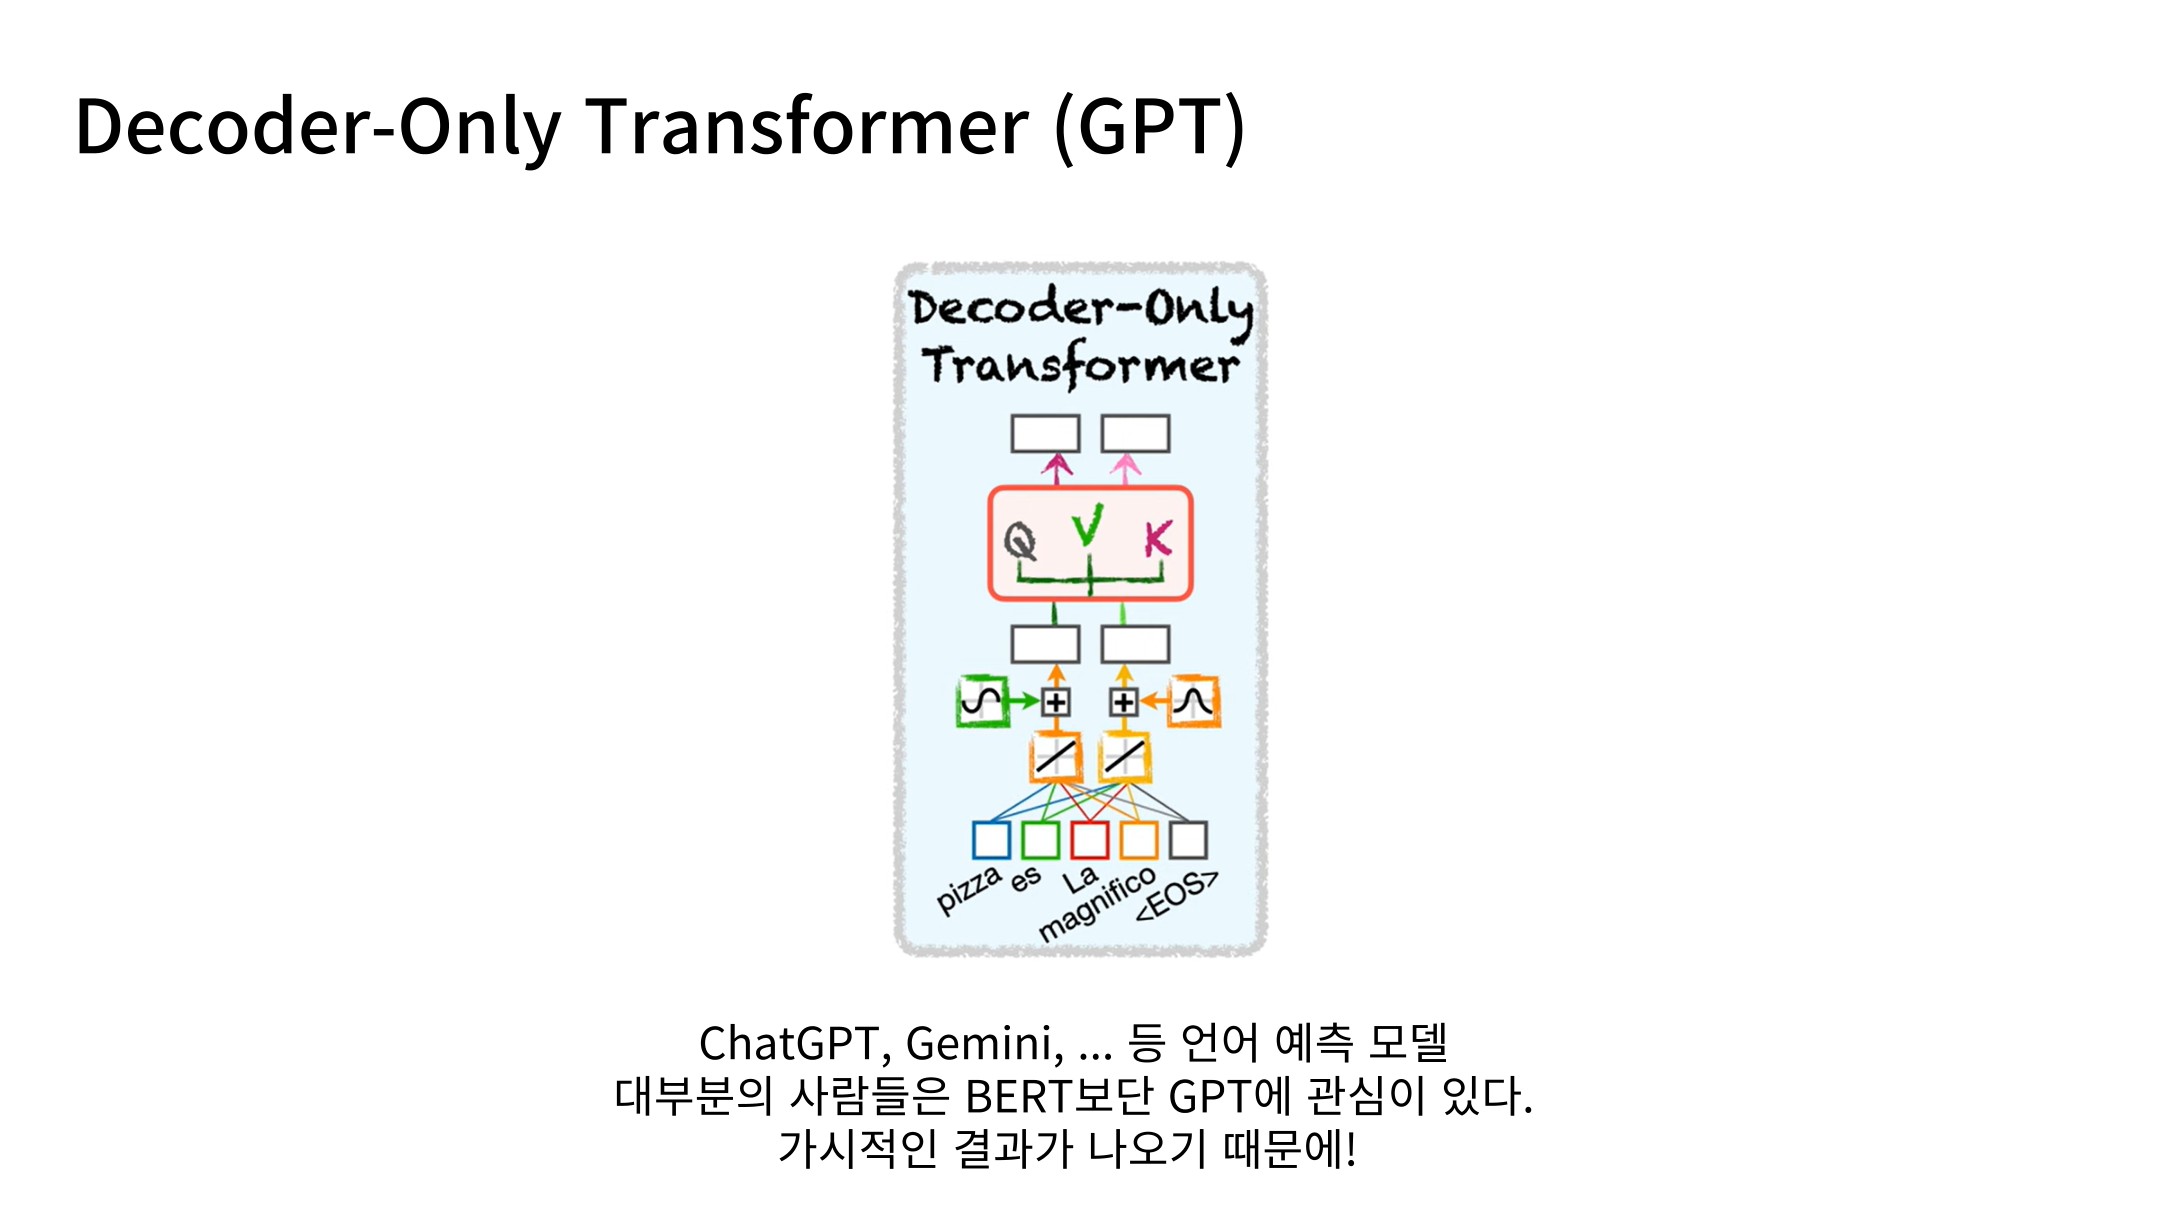
Slide 57: Decoder-Only Transformer: GPT
GPT 계열의 기본 구조는 Causal Self-Attention을 사용하는 Decoder-only Transformer입니다. 원래 Encoder–Decoder의 Decoder에서 Encoder를 참조하는 Cross-Attention 없이 이전 토큰들을 바탕으로 다음 토큰을 예측합니다.
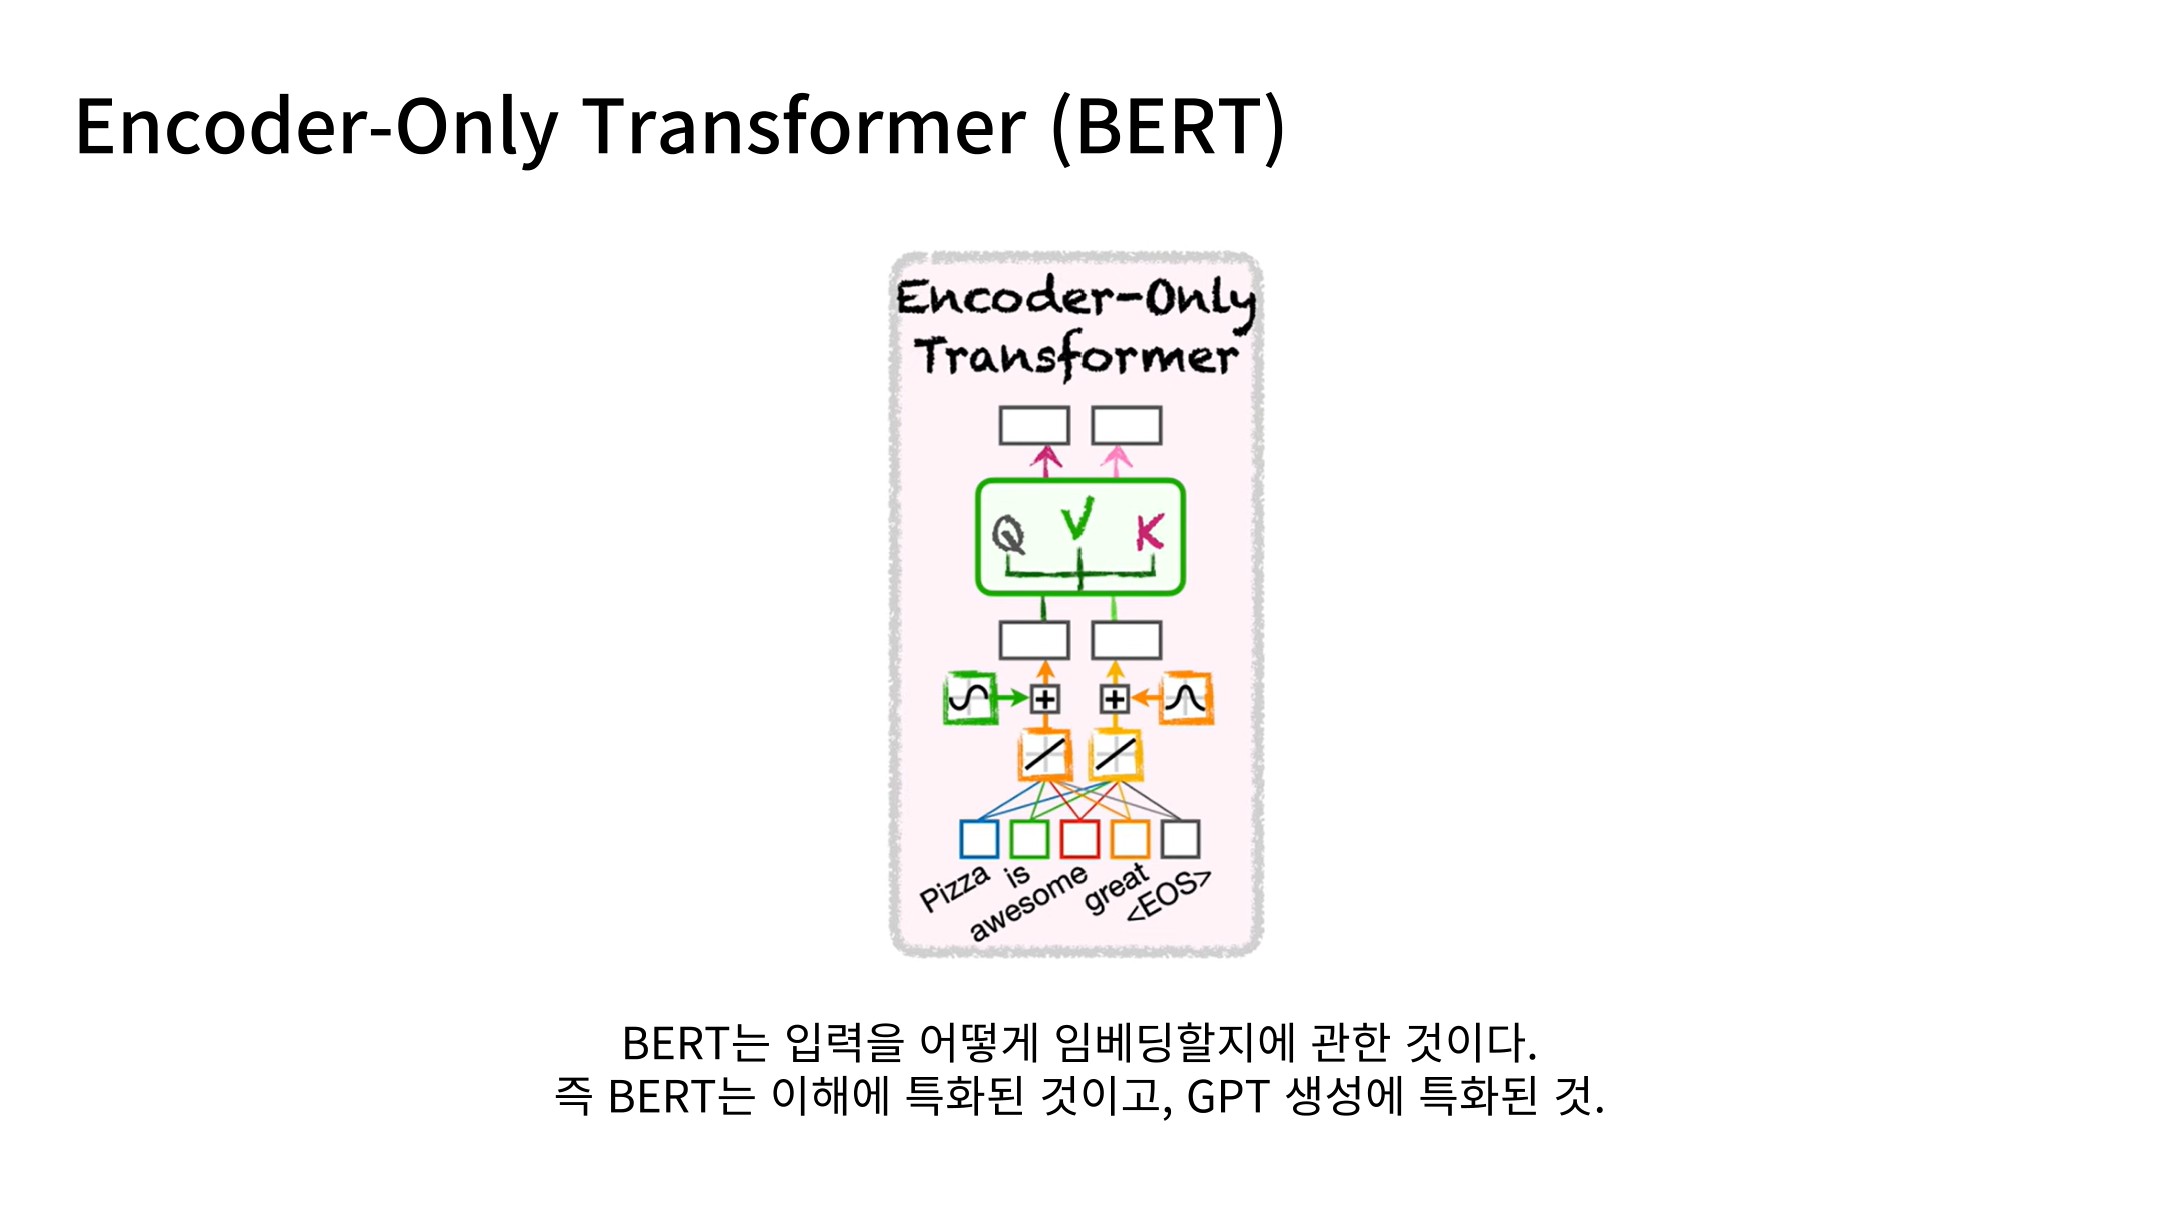
Slide 58: Encoder-Only Transformer
BERT는 양방향 문맥을 참고하는 Encoder 기반 모형입니다. 대표적인 사전학습 목표는 가려진 토큰을 복원하는 Masked Language Modeling이며, 토큰마다 문맥을 반영한 표현을 만듭니다.
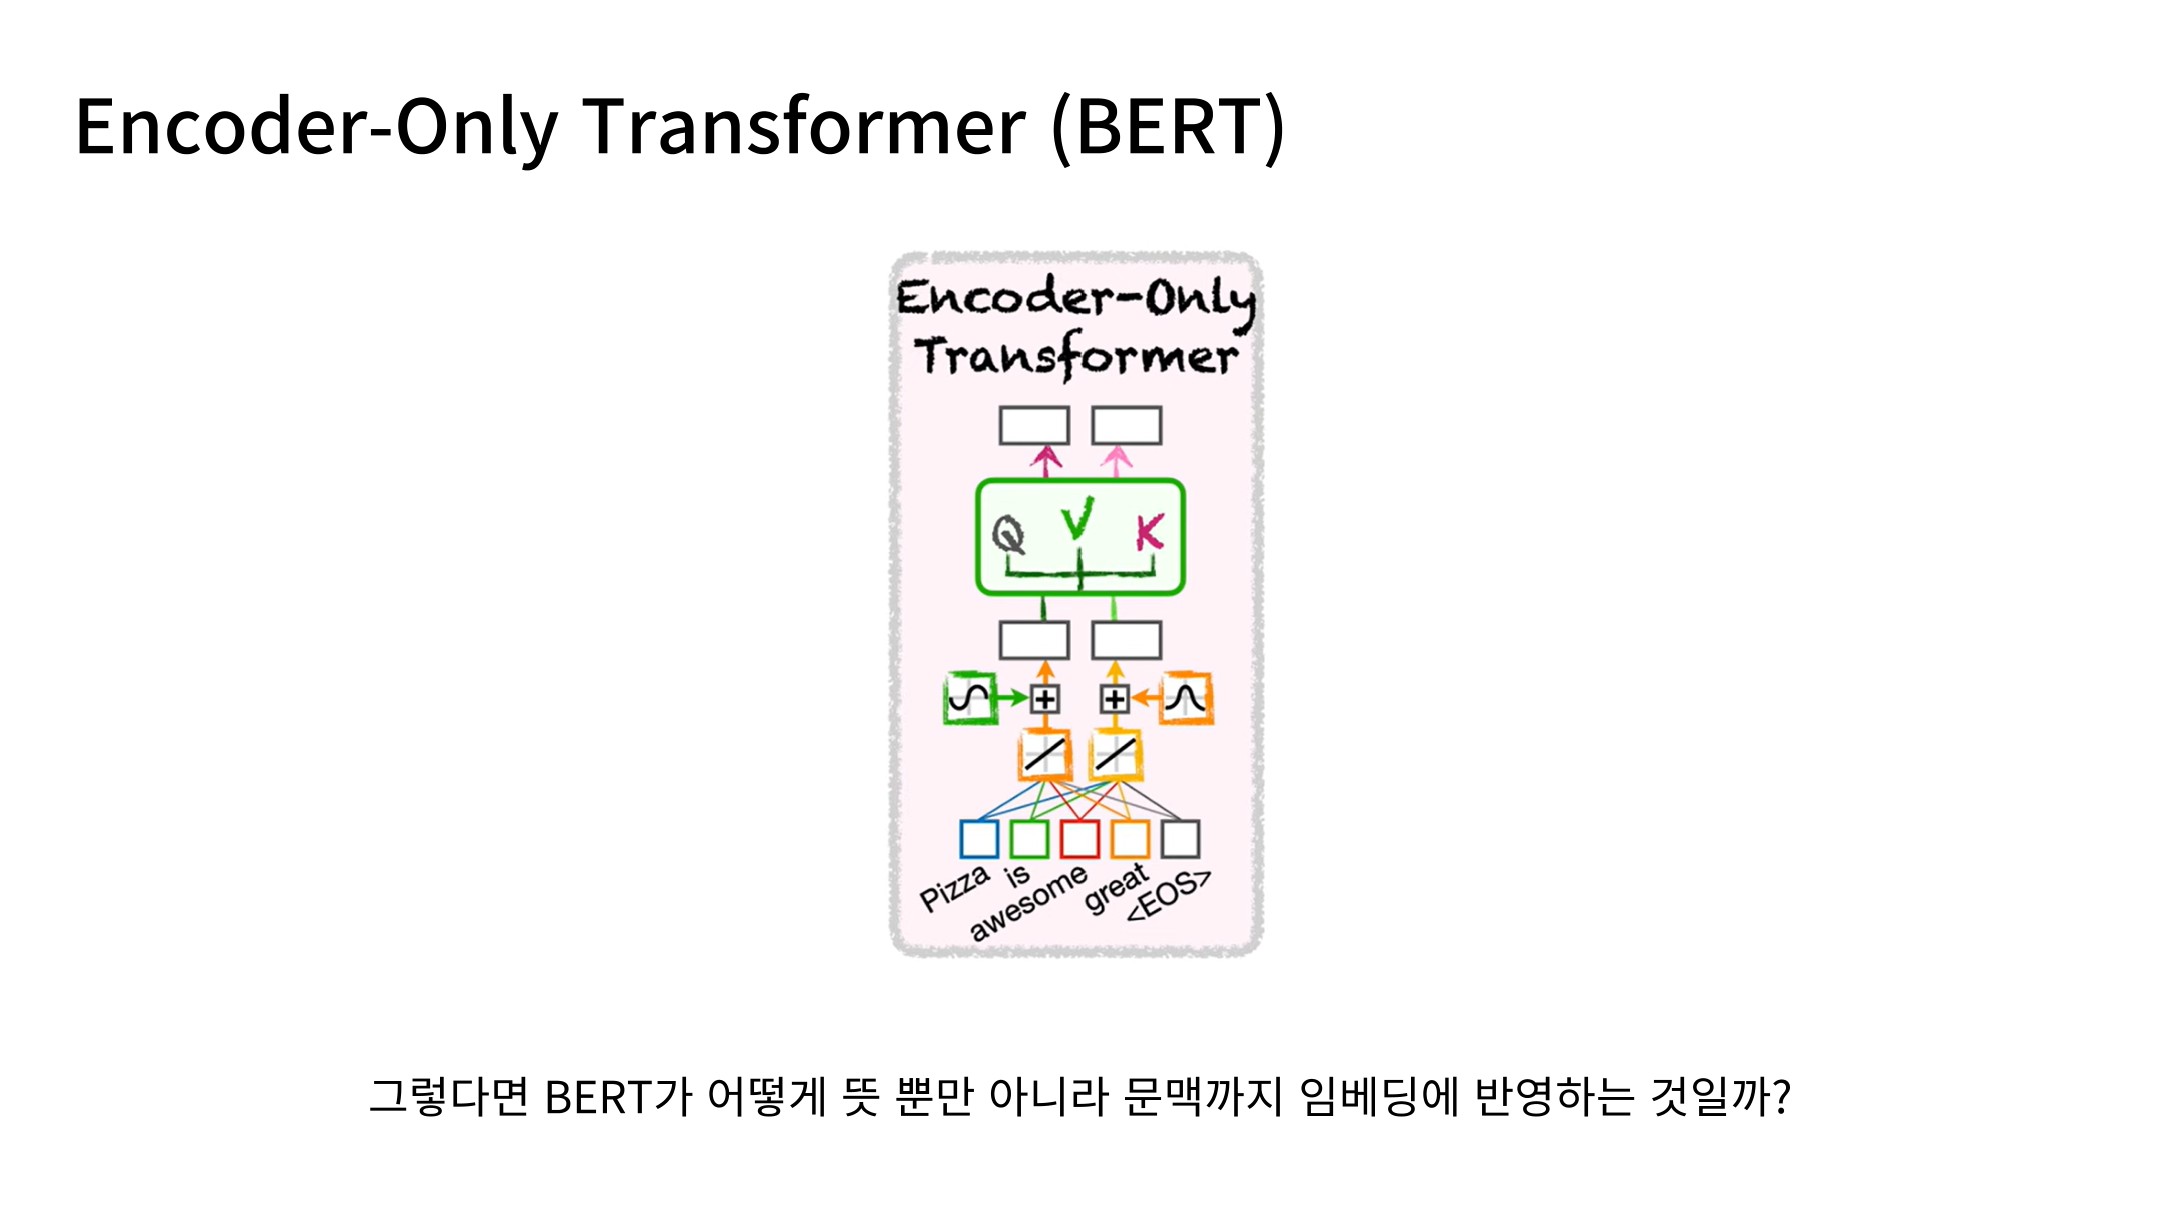
Slide 59: 문맥 표현이 필요한 이유
단순한 단어별 Embedding만으로는 같은 단어가 문맥에 따라 달라지는 의미를 충분히 표현하기 어렵습니다. BERT는 주변 단어를 함께 처리하여 이를 보완합니다.
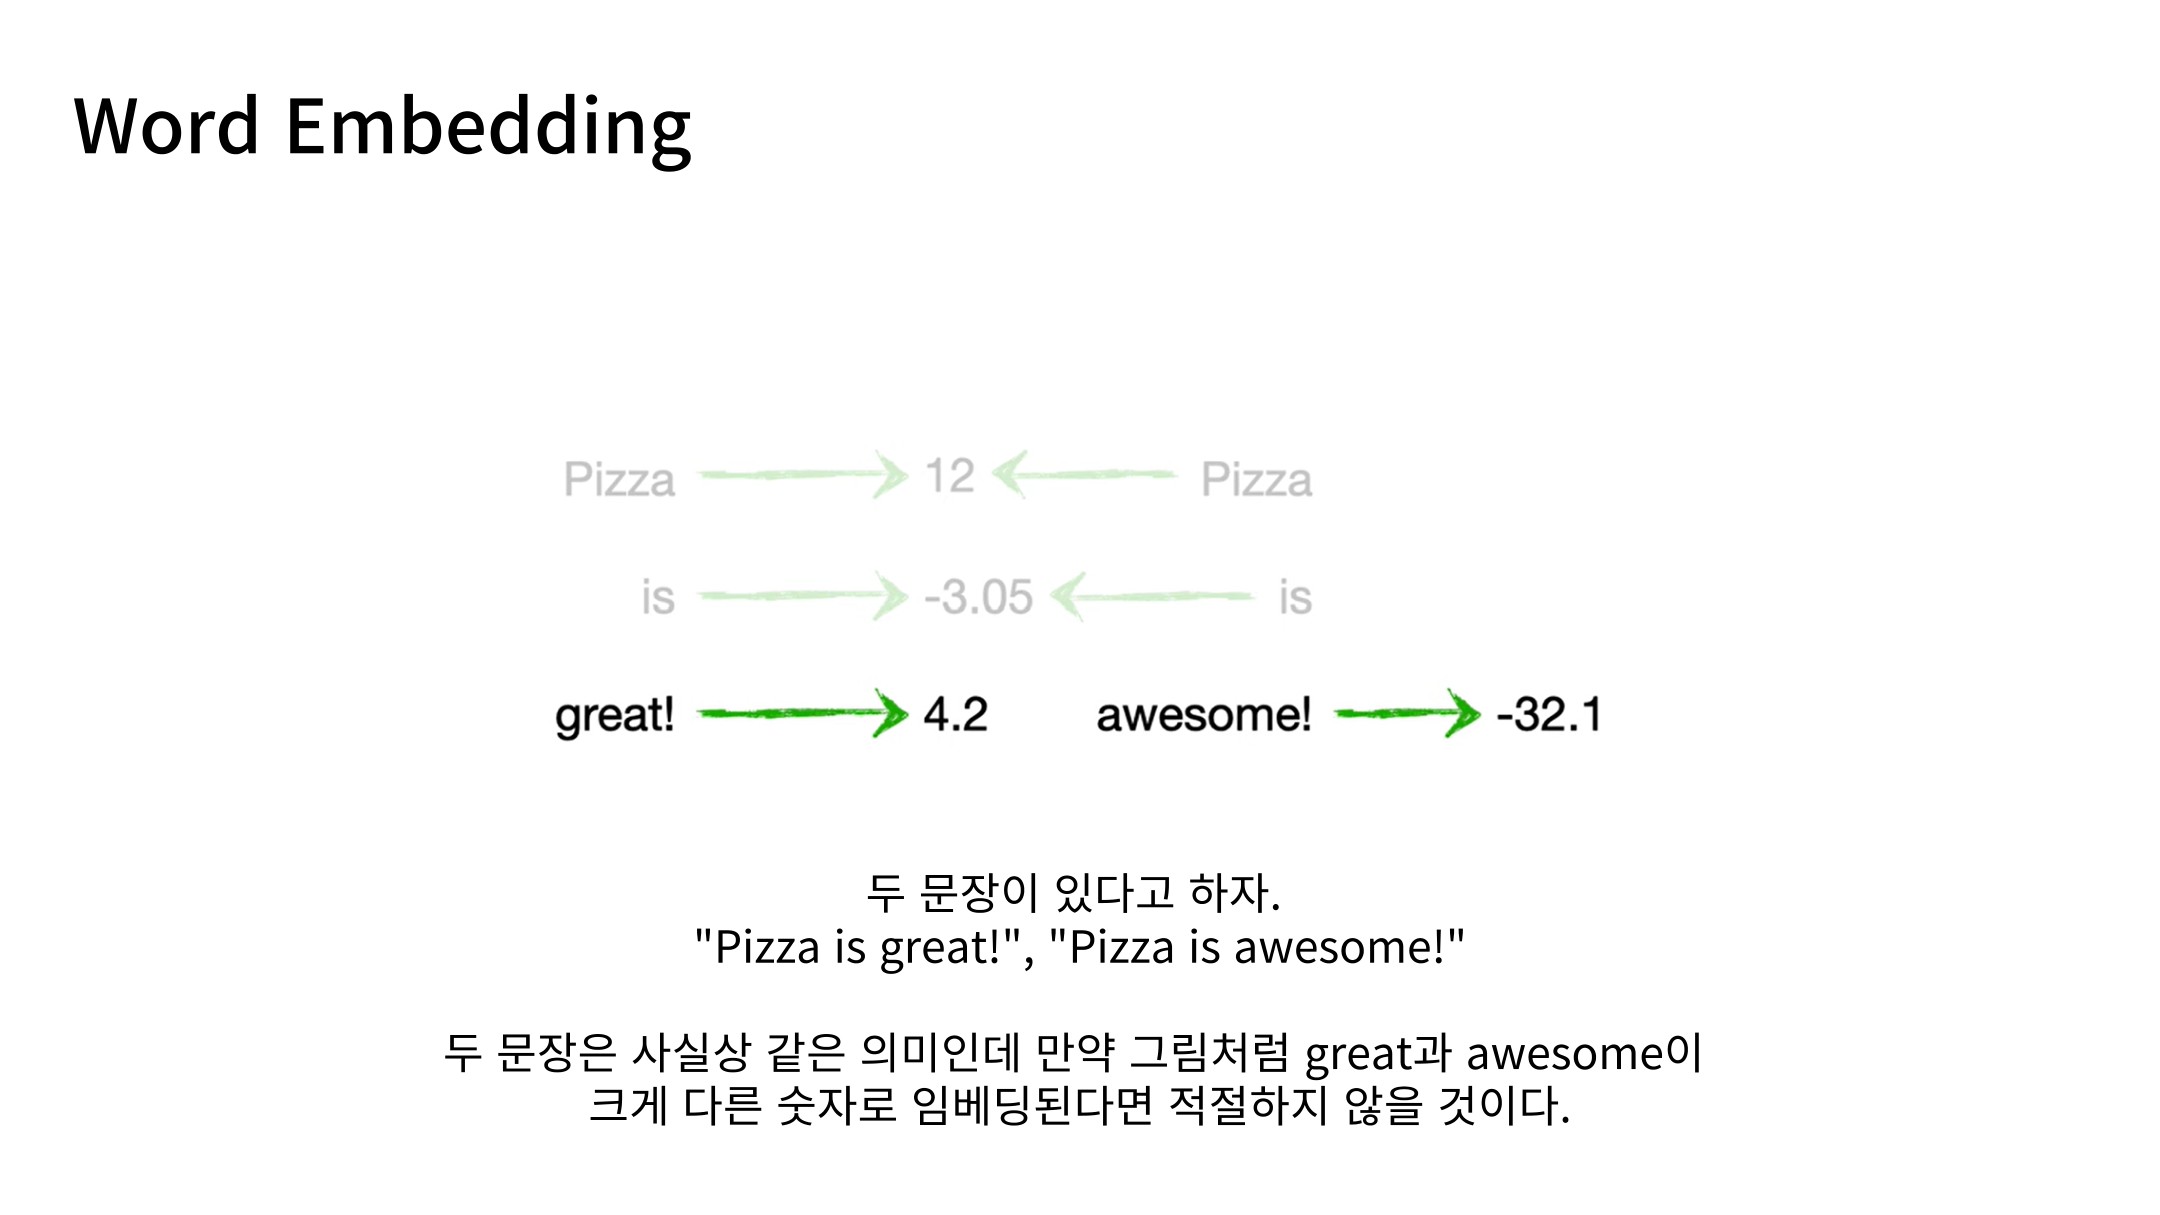
Slide 60: 단어 Embedding의 의미
“great”와 “awesome”처럼 유사한 단어의 관계는 학습을 통해 표현에 반영되어야 합니다. 그림의 숫자는 직관을 위한 예시이며, 실제 의미 관계는 다차원 벡터 공간에서 다룹니다.
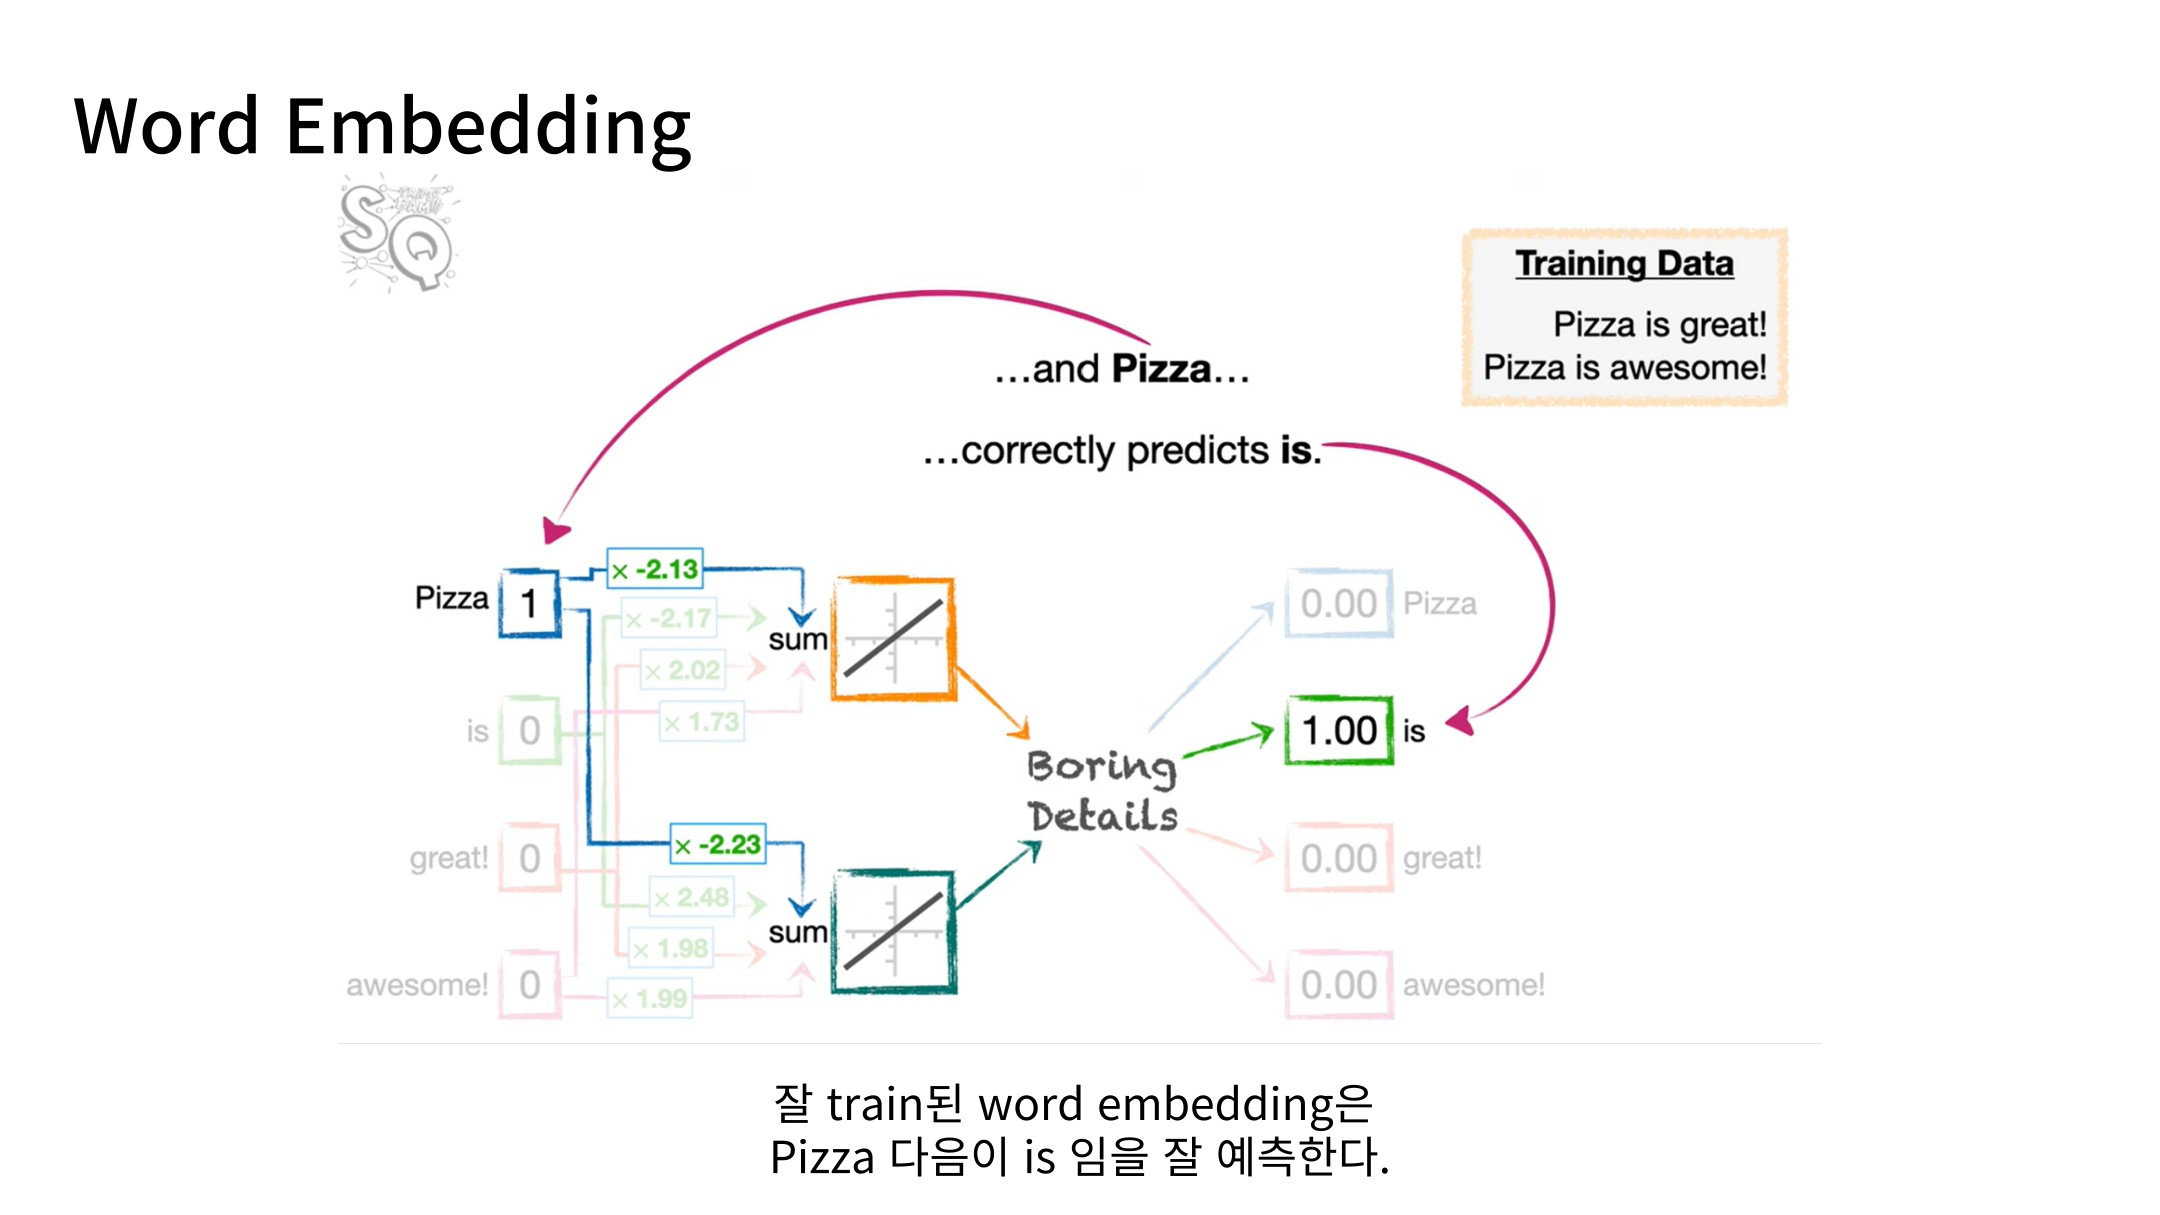
Slide 61: 주변 단어 예측으로 학습하기
주변 단어를 예측하는 목적함수를 이용하면 단어 벡터에도 통계적인 문맥 정보가 반영됩니다. 자주 비슷한 환경에서 등장하는 단어들의 표현을 학습할 수 있습니다.
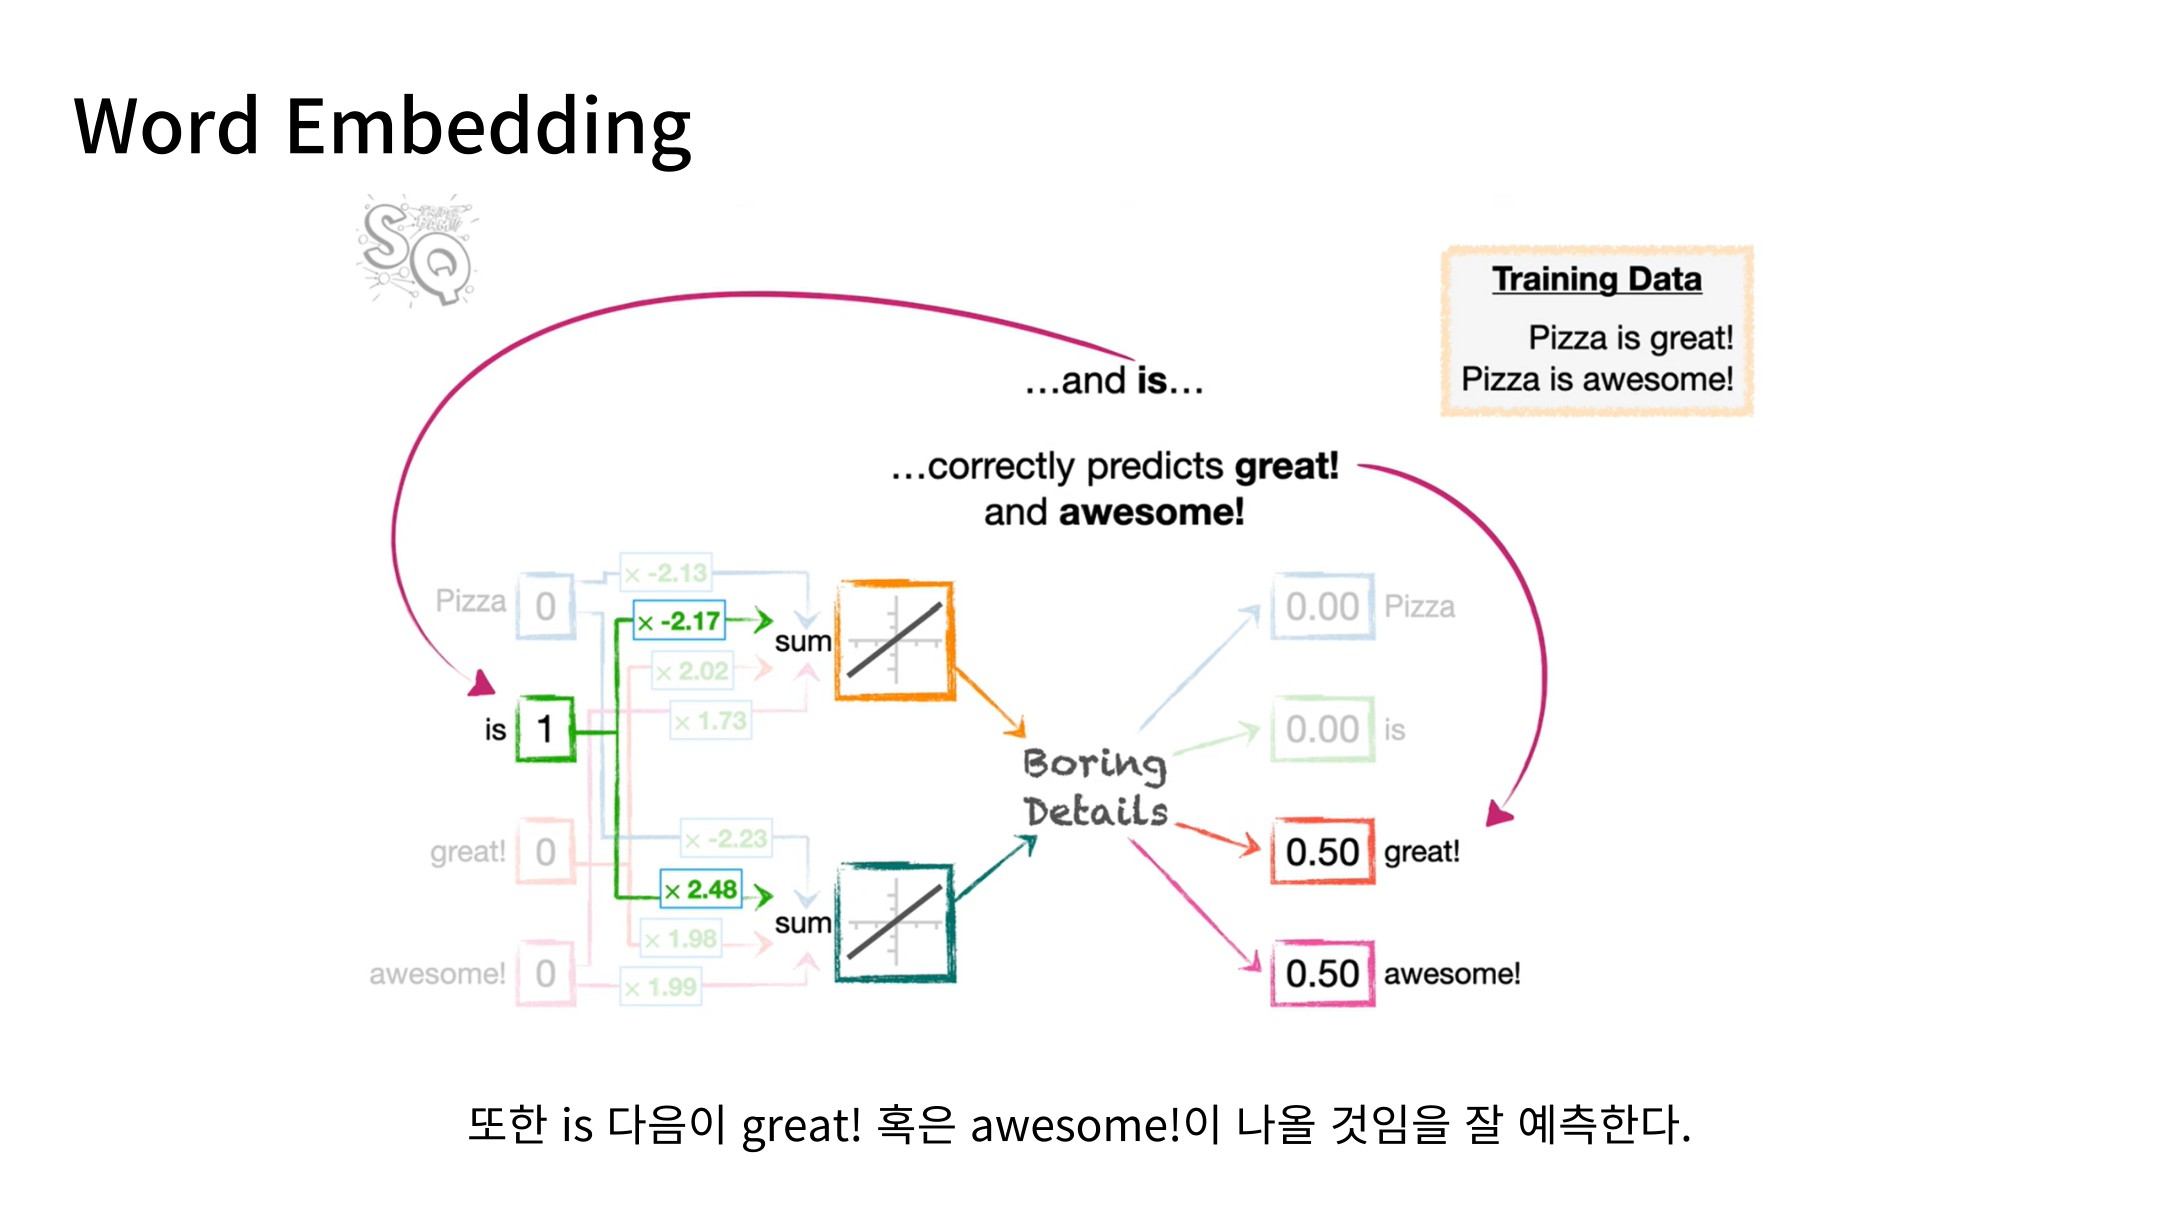
Slide 62: 유사한 문맥의 단어
“Pizza is great”와 “Pizza is awesome”처럼 비슷한 문맥에 등장하는 표현은 유사성을 학습할 단서를 제공합니다. 특정 확률값은 슬라이드의 설명용 예시입니다.
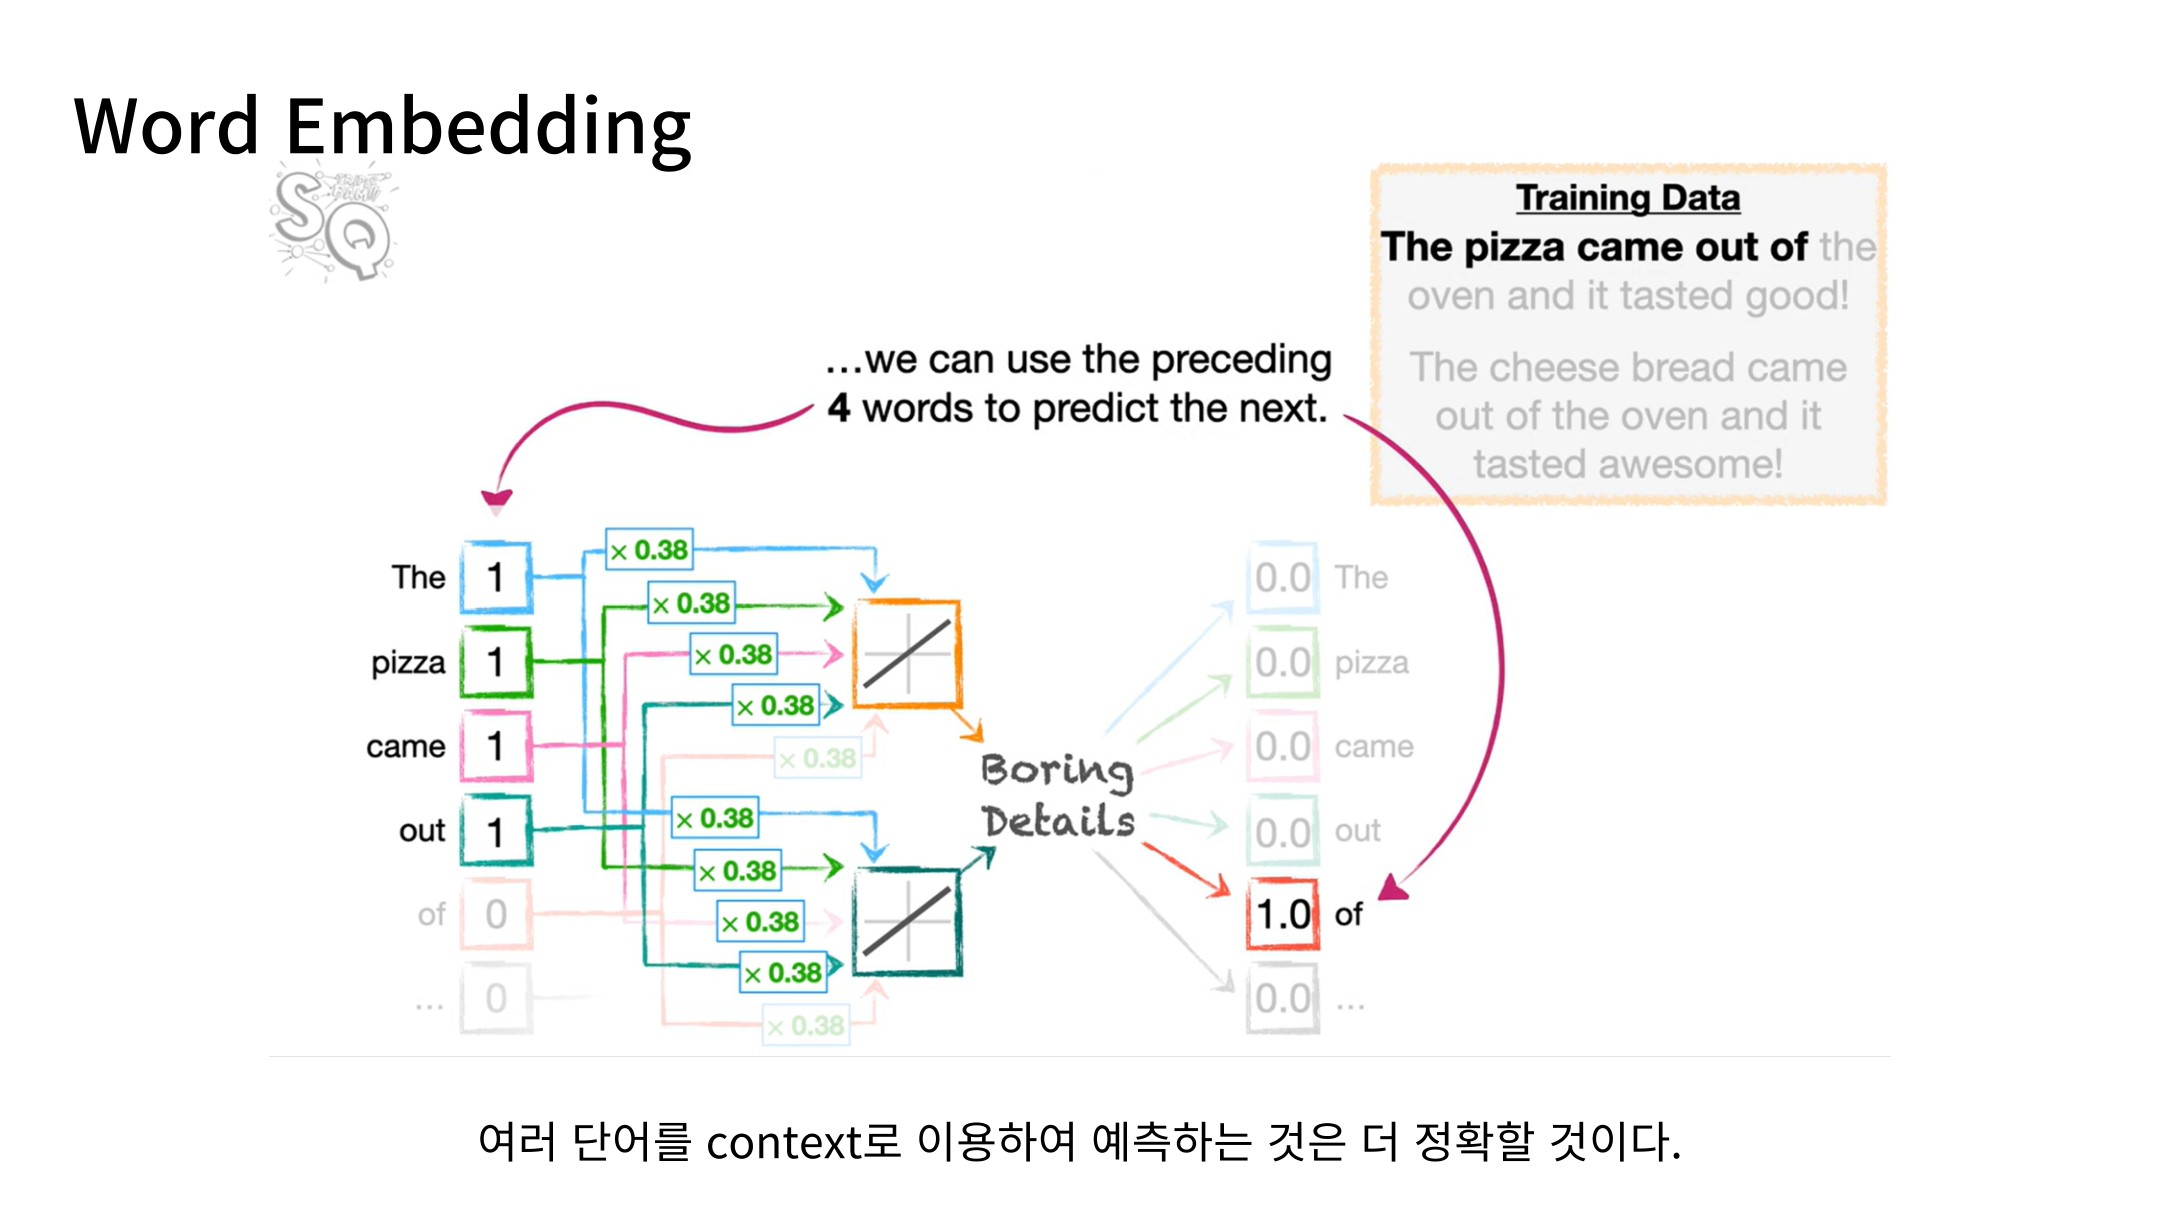
Slide 63: 여러 단어를 문맥으로 사용하기
하나의 단어가 아니라 여러 단어를 함께 사용하면 예측에 활용할 정보가 늘어납니다. 다만 문맥을 어떻게 결합하는지가 중요합니다.
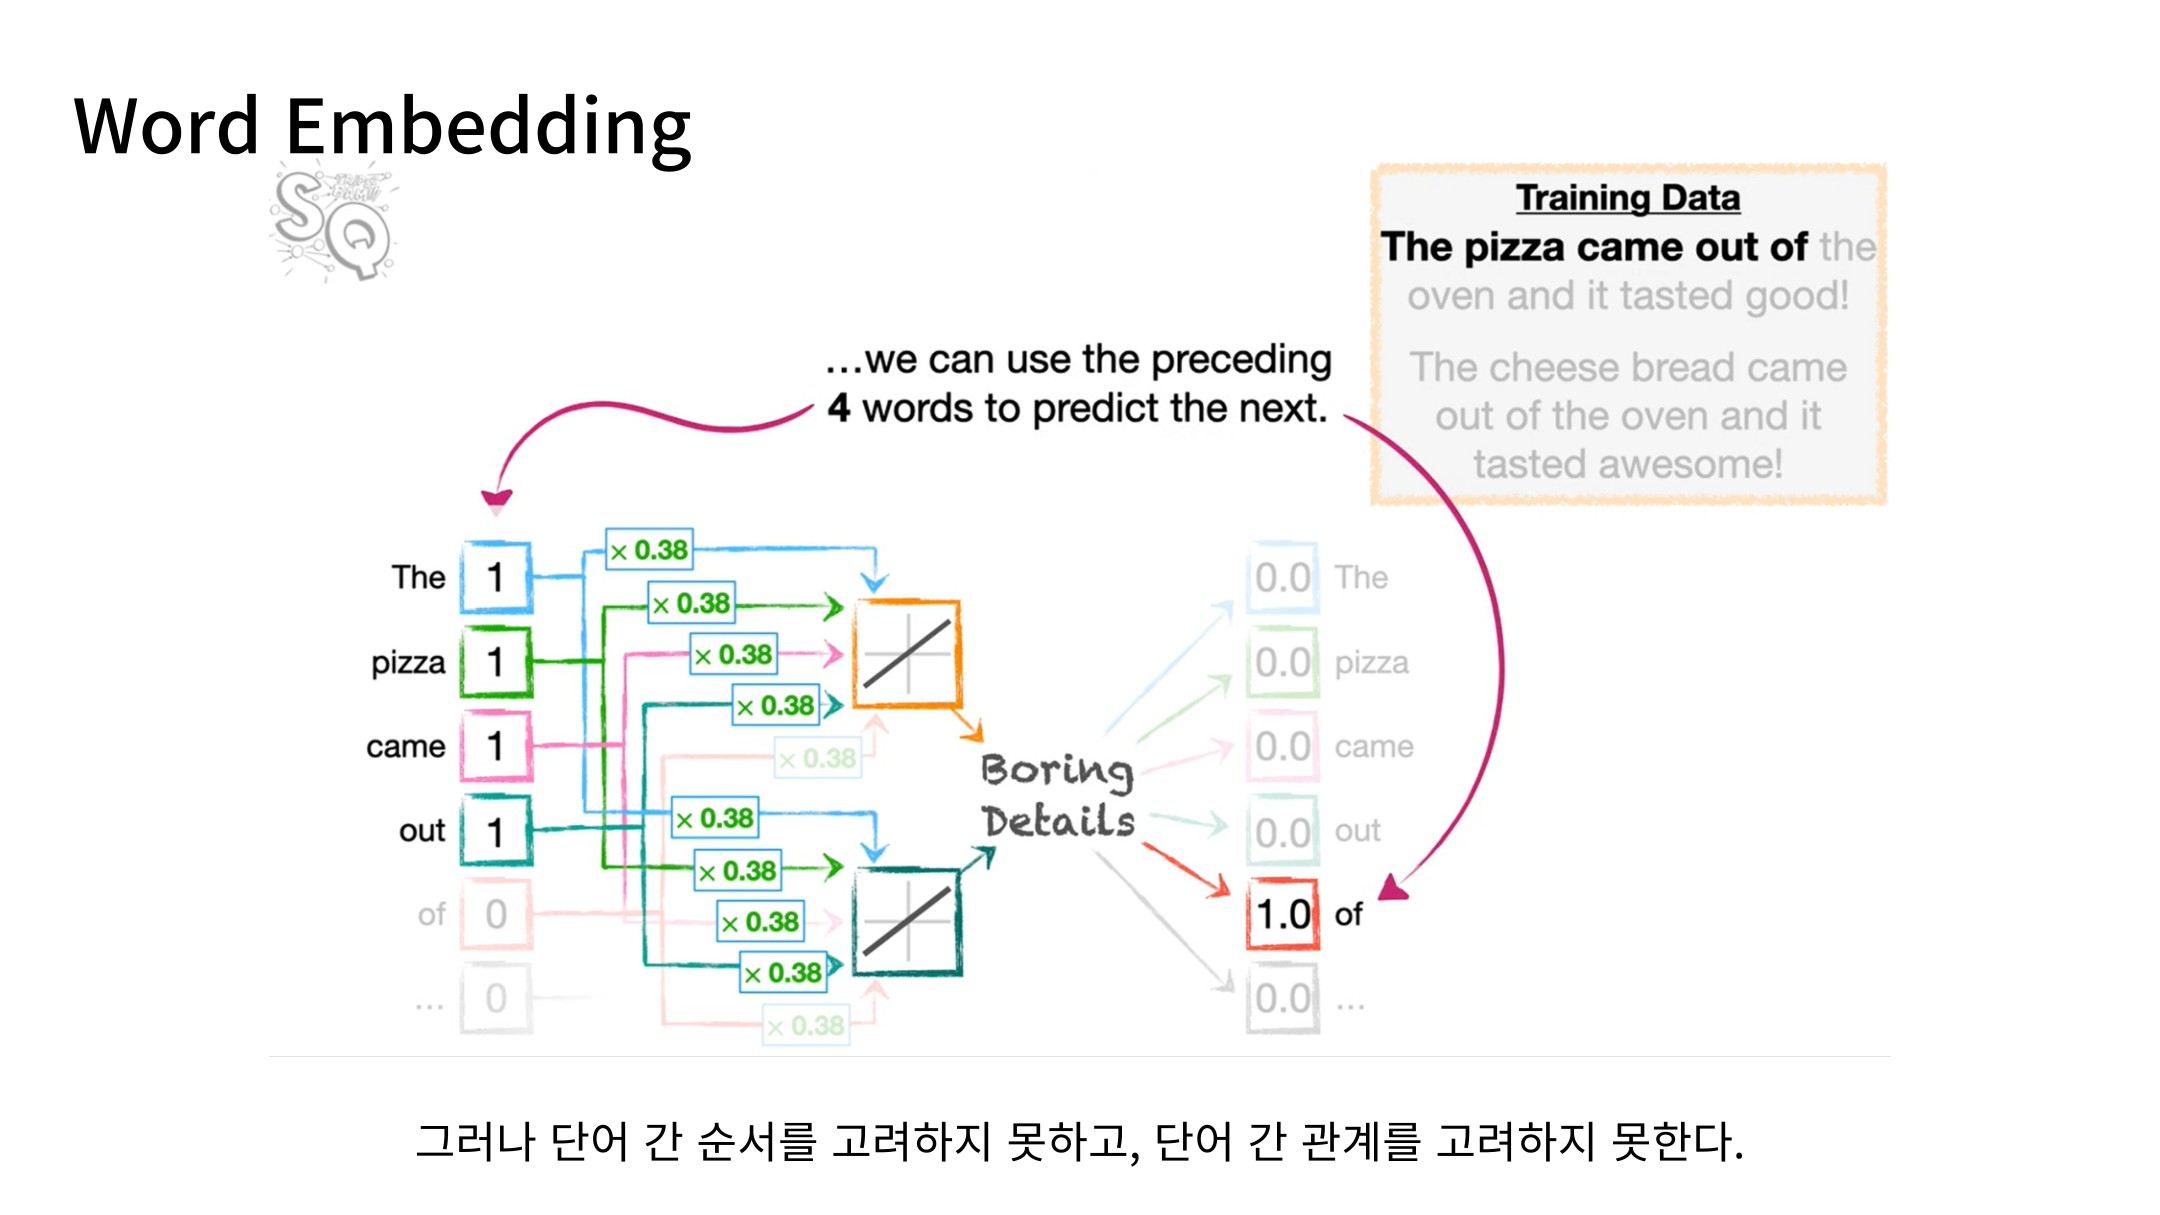
Slide 64: 순서와 관계 정보의 한계
슬라이드의 단순한 문맥 결합 방식은 단어 순서와 세밀한 관계를 충분히 반영하지 못합니다. 이는 모든 기존 Embedding 방법에 대한 일반적 한계가 아니라, 여기서 비교하는 단순화된 모형의 한계입니다.
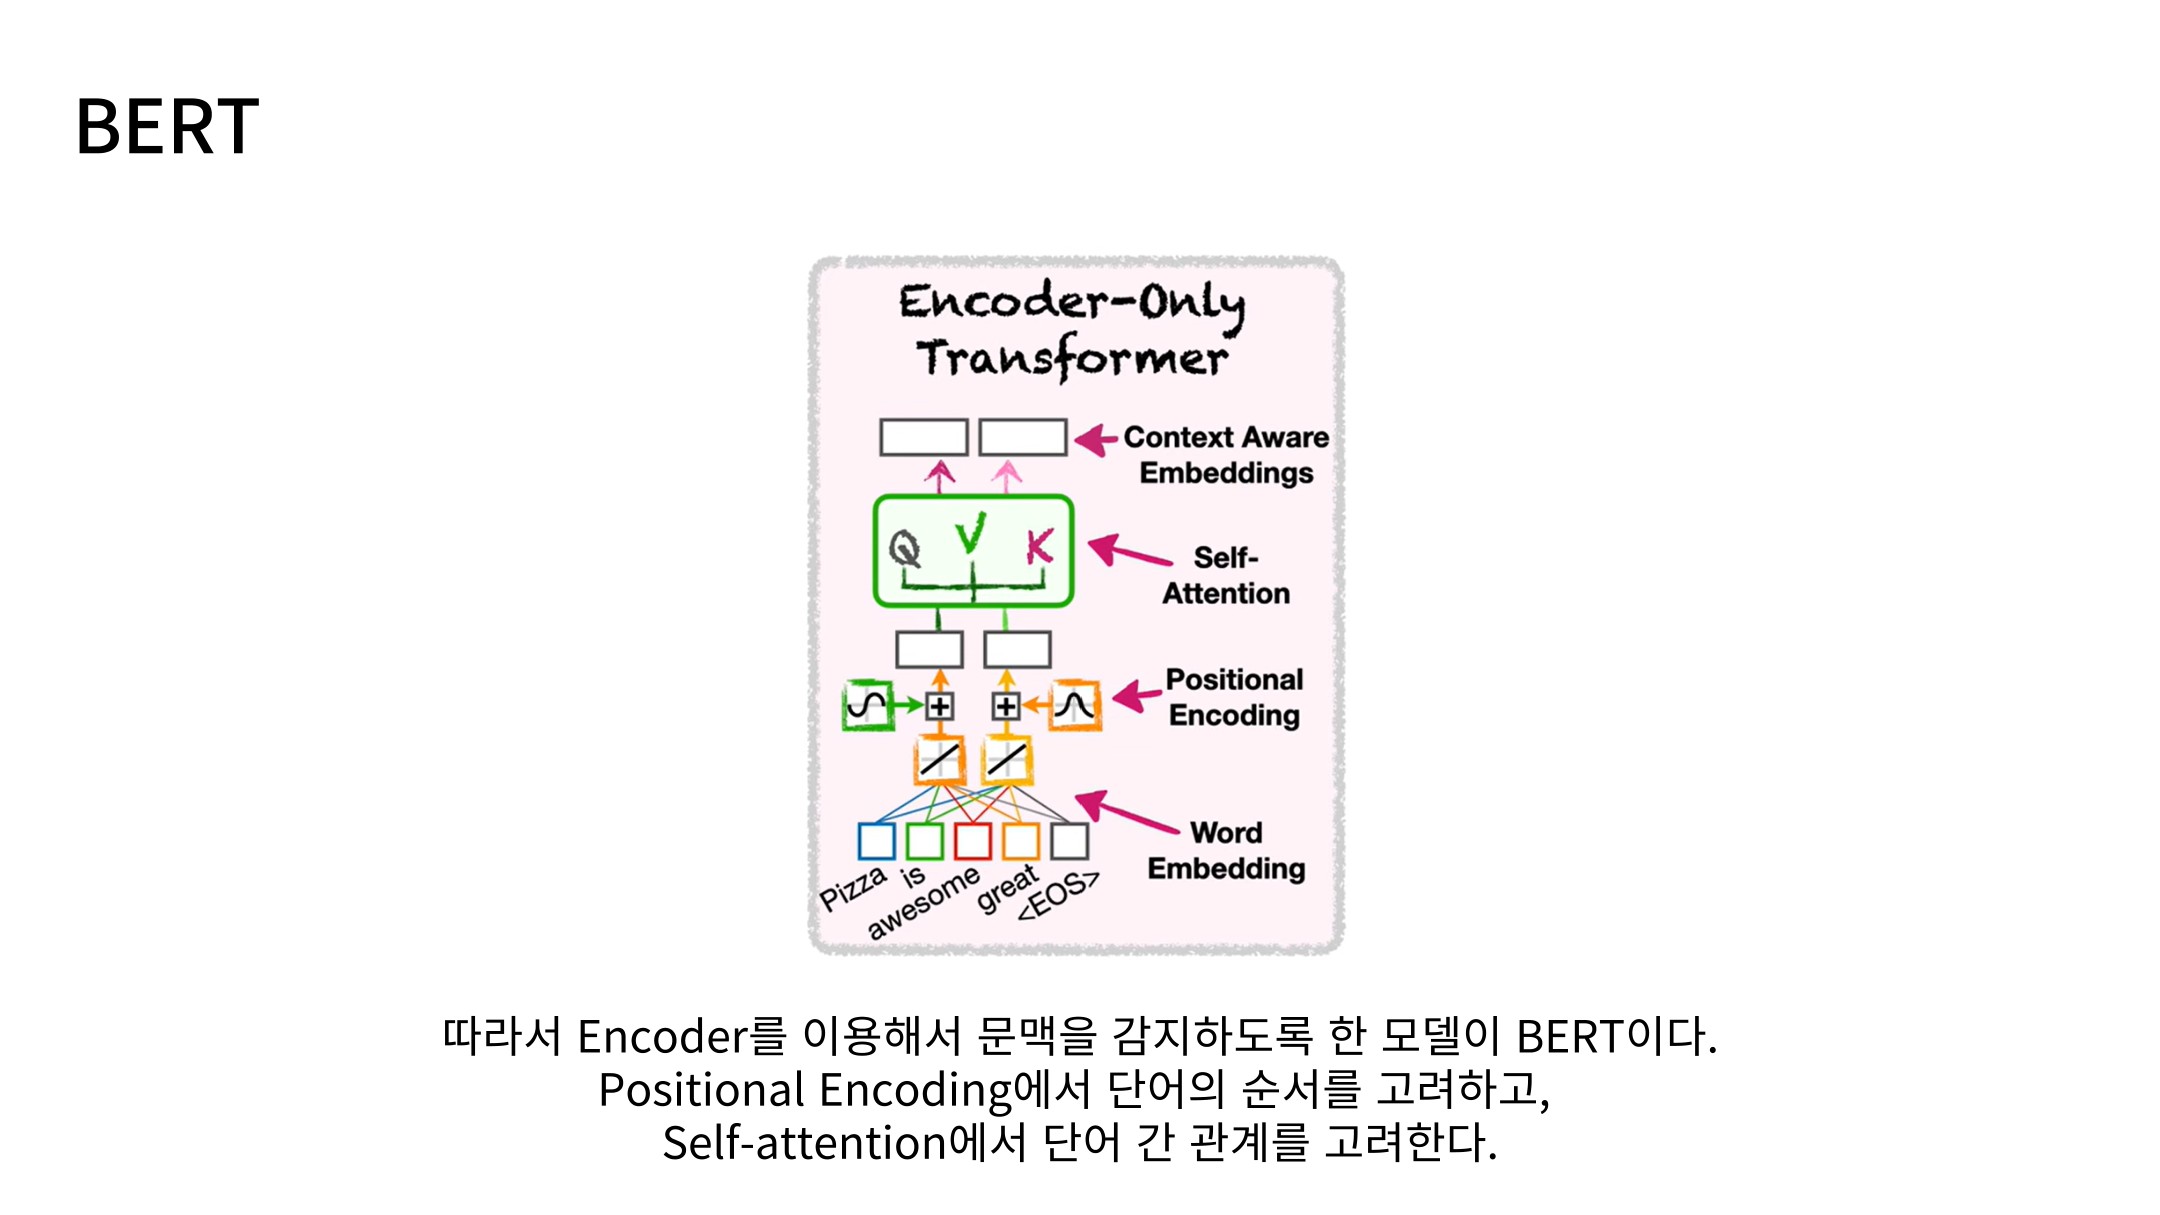
Slide 65: BERT의 문맥 기반 표현
BERT는 위치 정보와 양방향 Self-Attention을 이용해 각 토큰의 문맥 표현을 만듭니다. 단순히 문장 전체를 한 벡터로 압축하는 모형이라기보다, 먼저 토큰별 표현을 출력하는 Encoder입니다.
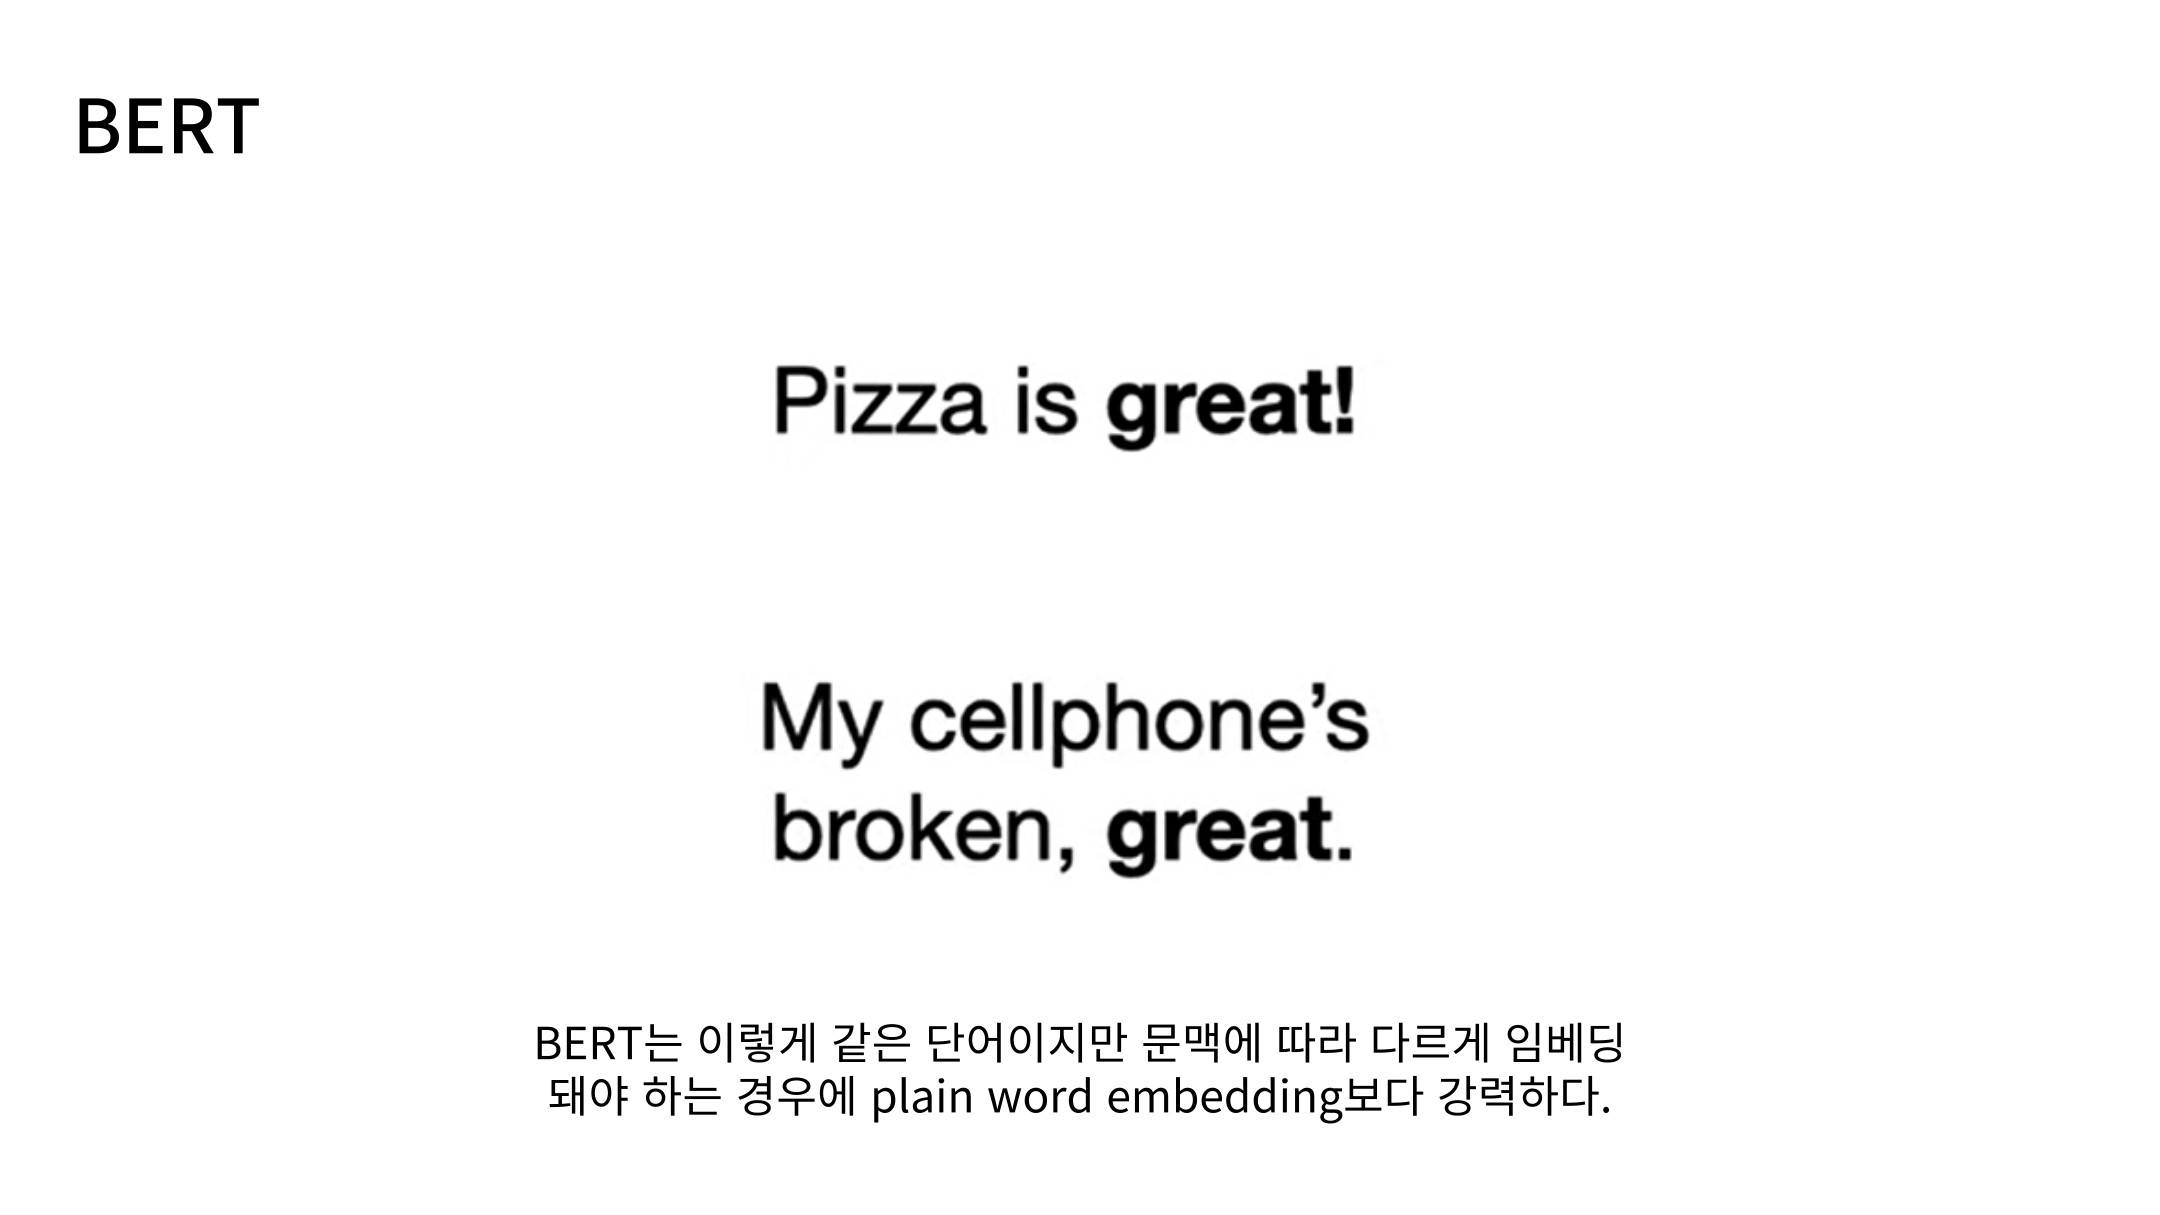
Slide 66: 같은 단어, 다른 의미
“Pizza is great!”와 “My cellphone’s broken, great.”의 “great”는 서로 다른 문맥에 놓여 있습니다. BERT는 주변 문장을 참고해 두 위치에 서로 다른 표현을 부여할 수 있습니다.
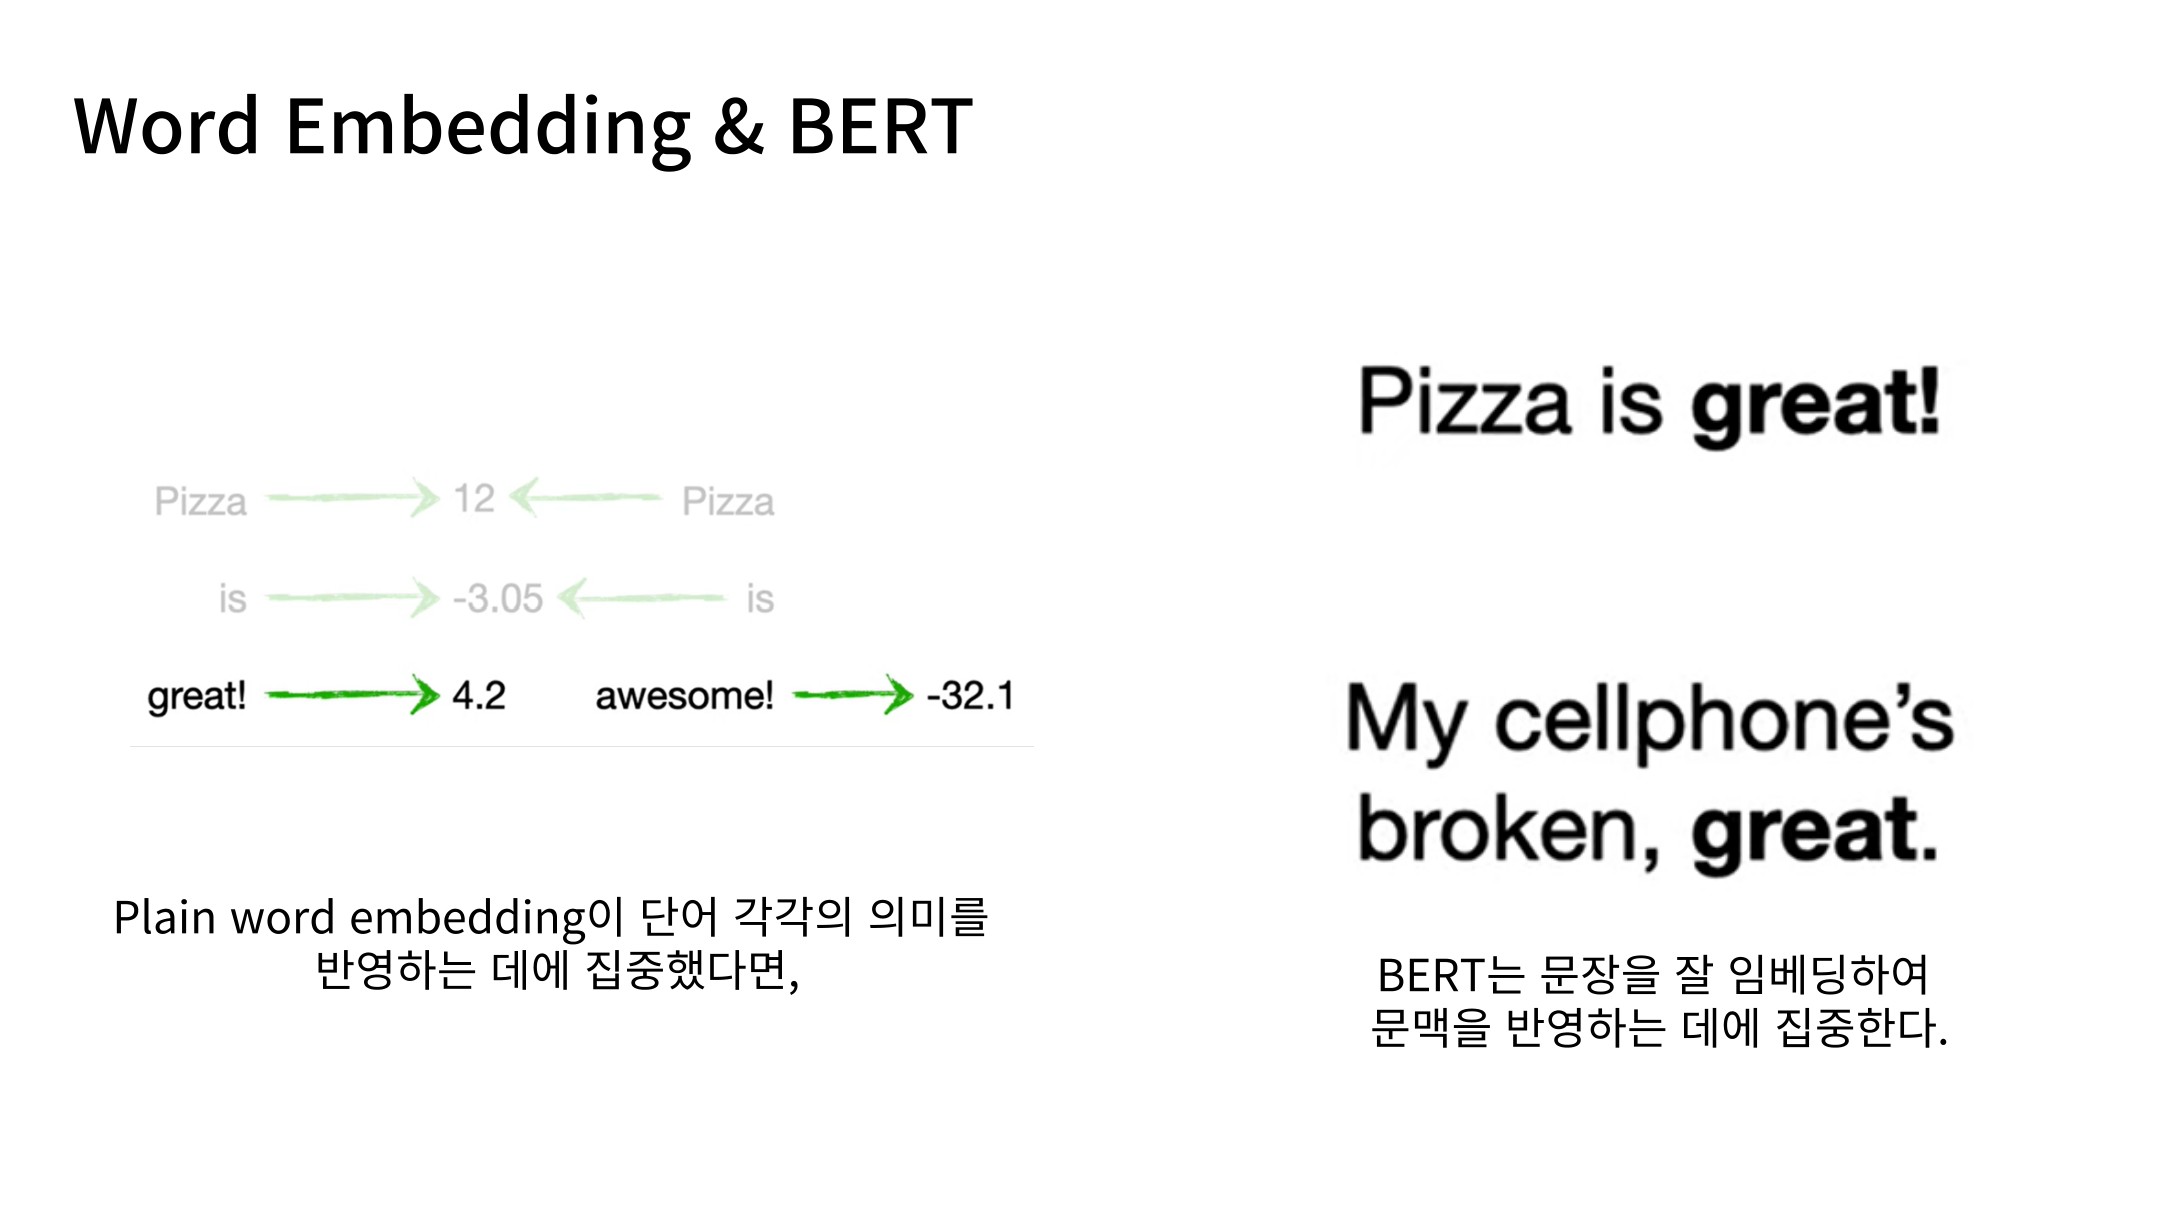
Slide 67: Word Embedding과 BERT 비교
고정된 단어 Embedding은 같은 토큰에 같은 벡터를 부여하지만, BERT의 출력은 문맥에 따라 달라집니다. 문장 표현이 필요할 때는 목적에 맞는 Pooling이나 추가 학습을 적용합니다.
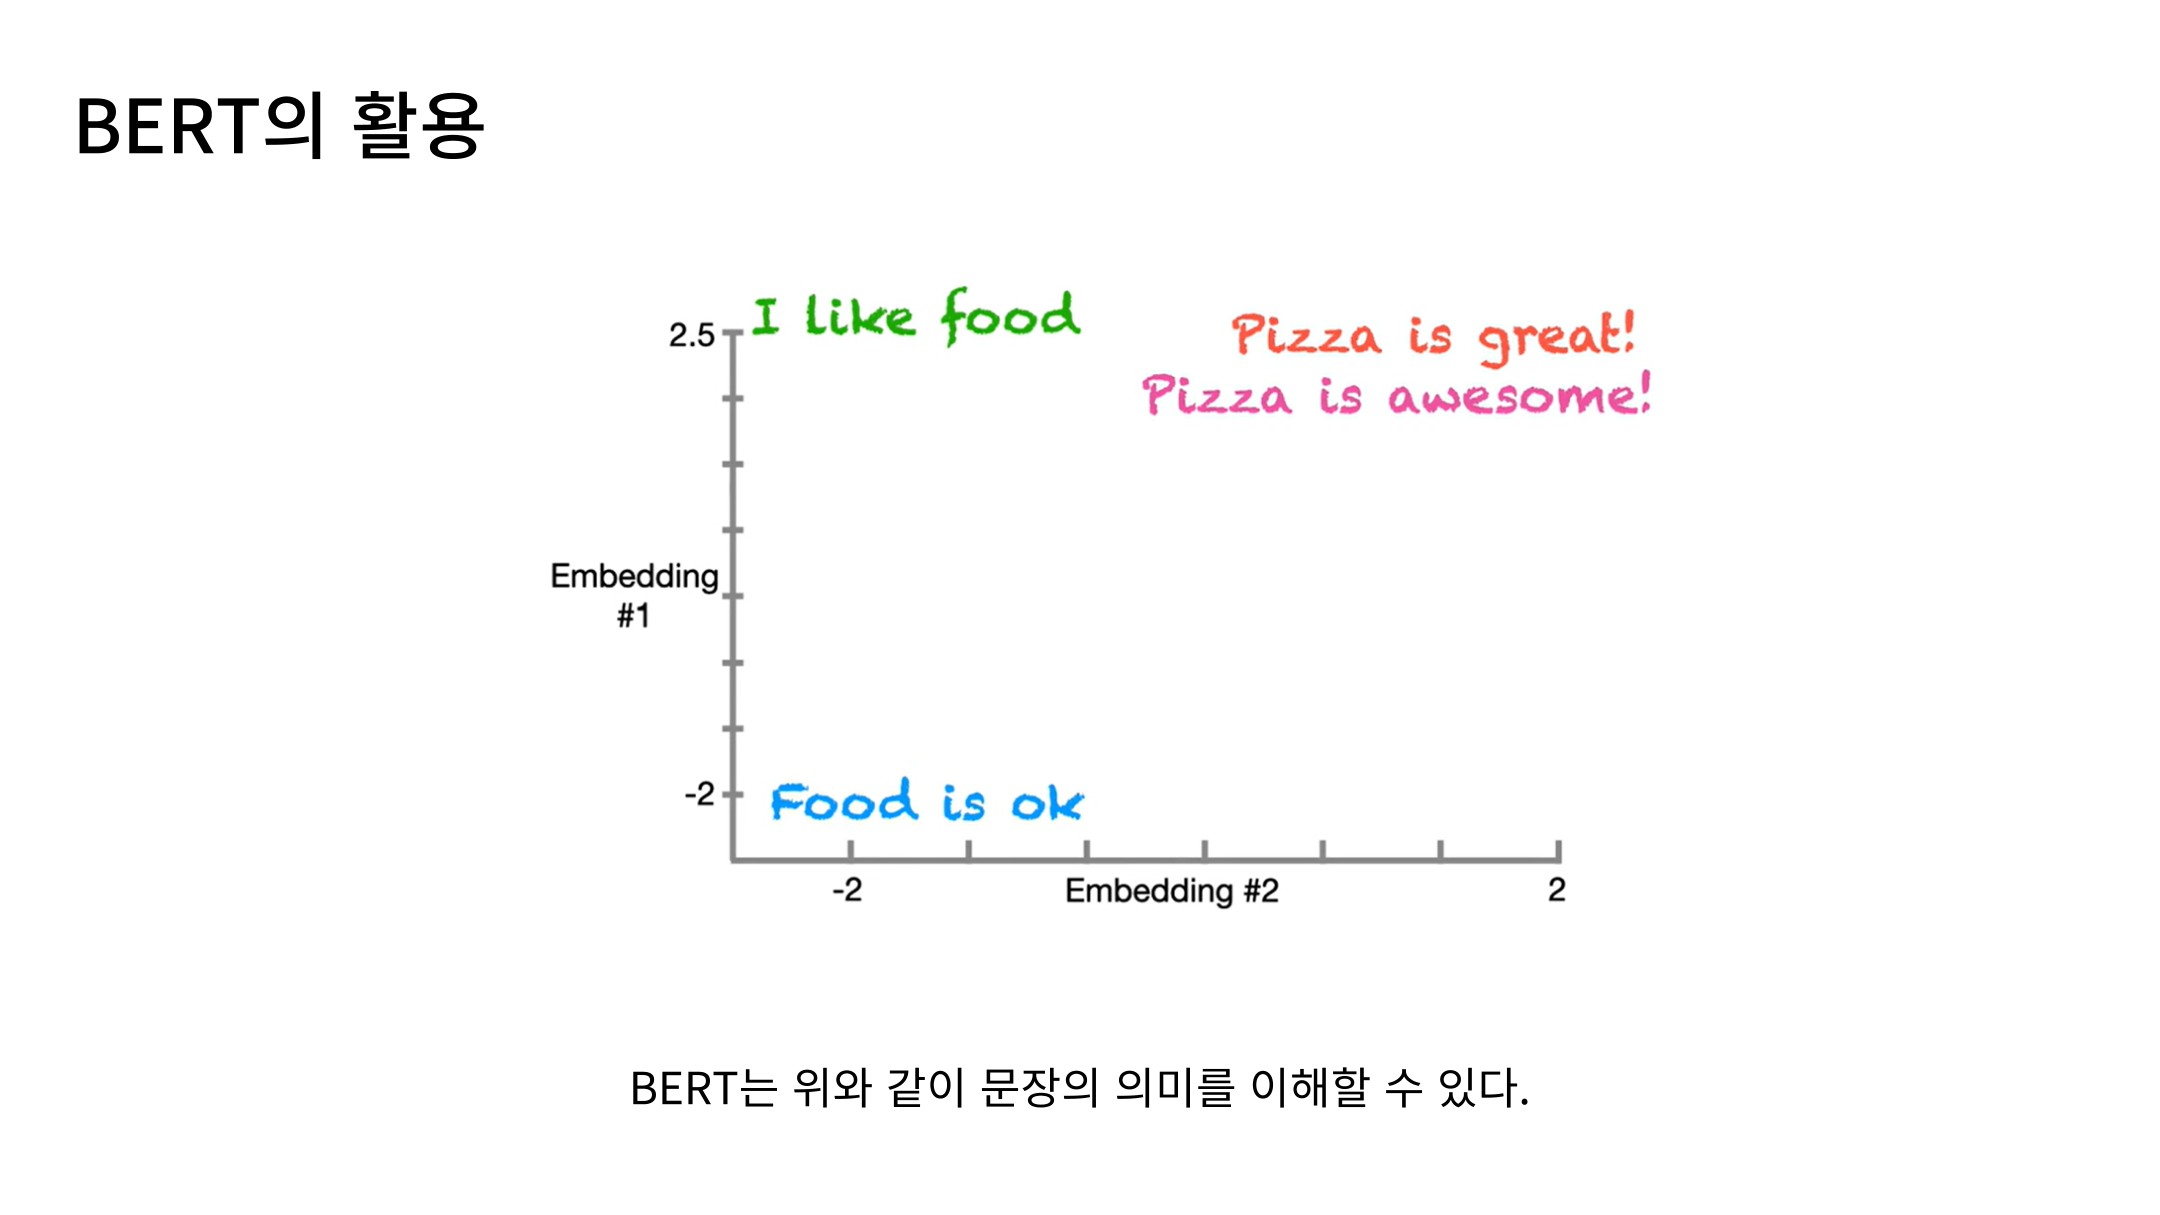
Slide 68: 문장 유사도
유사한 의미의 문장을 가까운 표현으로 배치하면 의미 기반 비교에 활용할 수 있습니다. 다만 일반 BERT의 출력만으로 좋은 문장 유사도가 자동 보장되는 것은 아니며, 문장 임베딩 학습이 도움이 됩니다.
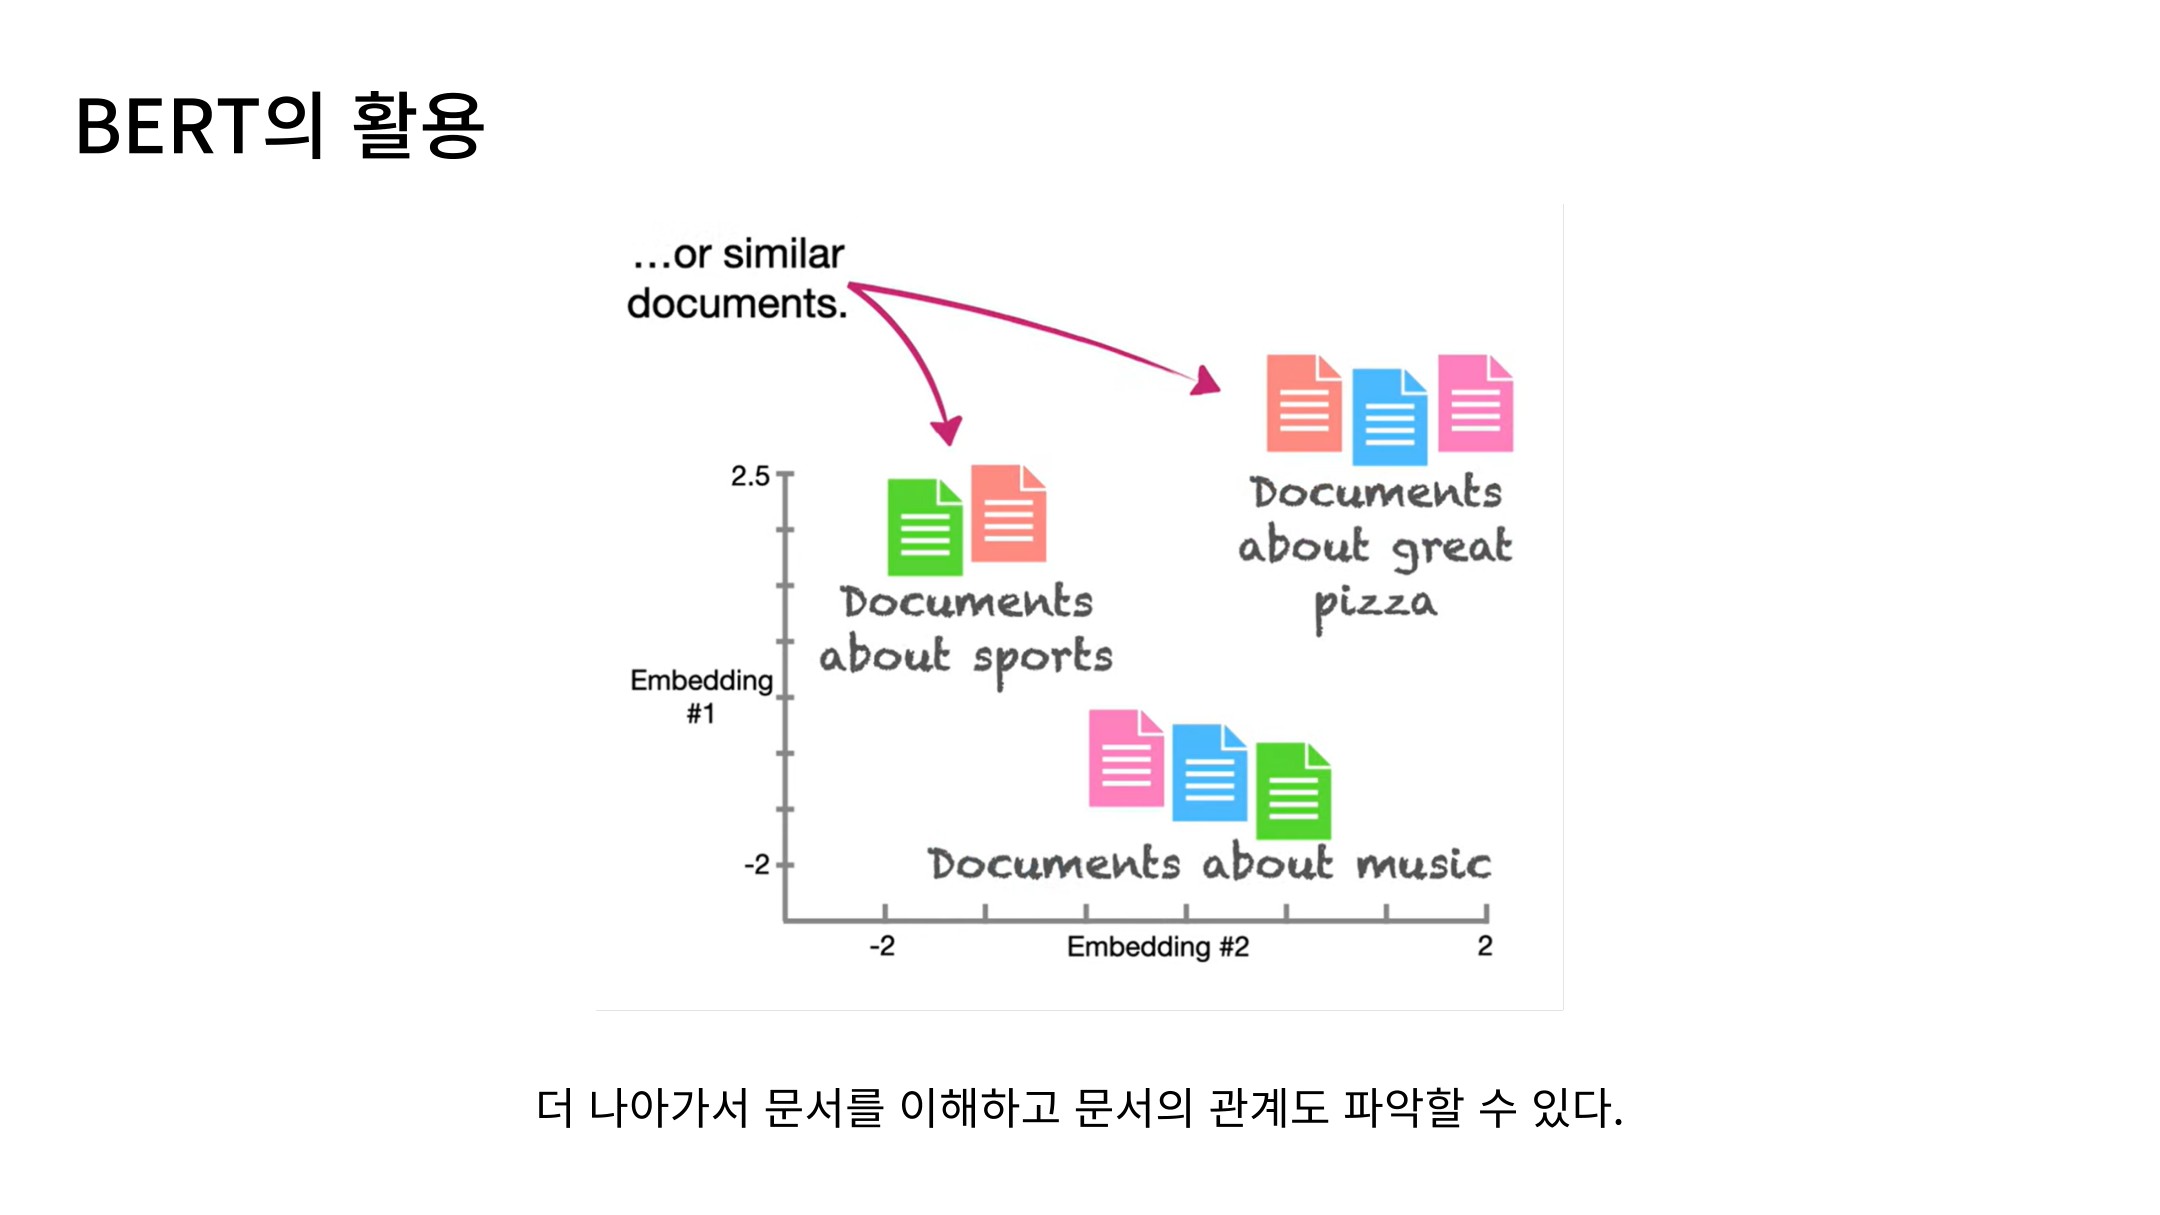
Slide 69: 문서 표현과 검색
문서도 표현 벡터로 변환하여 유사도를 비교하거나 군집화할 수 있습니다. 긴 문서는 길이 제한을 고려해 나누고, 과제에 맞는 표현과 유사도 함수를 선택해야 합니다.
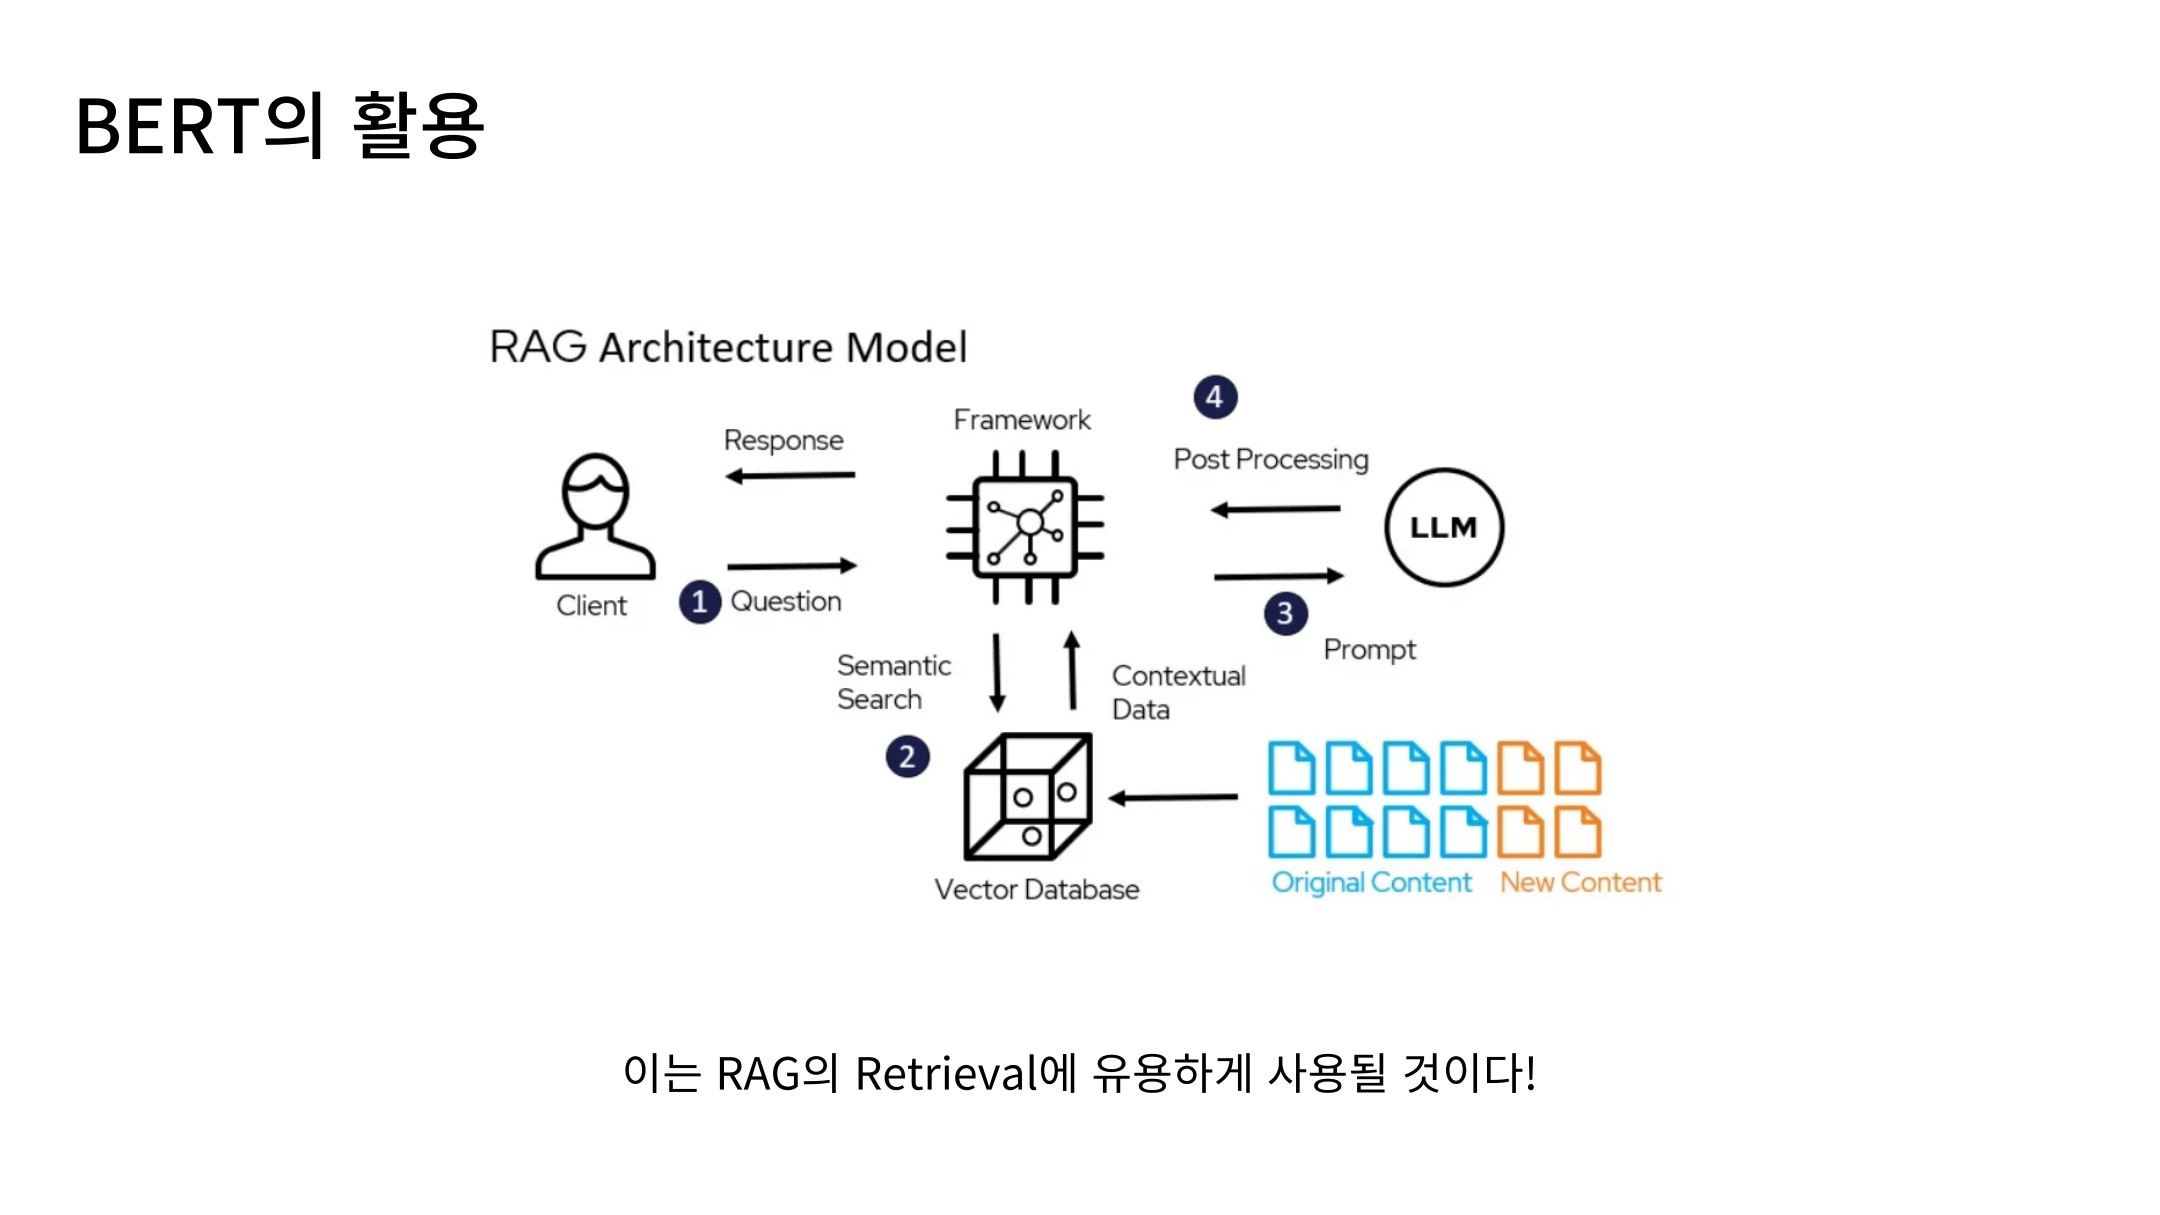
Slide 70: RAG Retrieval
RAG는 질문과 관련된 문서를 검색해 생성 모형의 입력에 제공하는 구조입니다. BERT 계열 Encoder를 기반으로 검색에 맞게 학습한 임베딩 모형을 Retrieval에 사용할 수 있습니다.
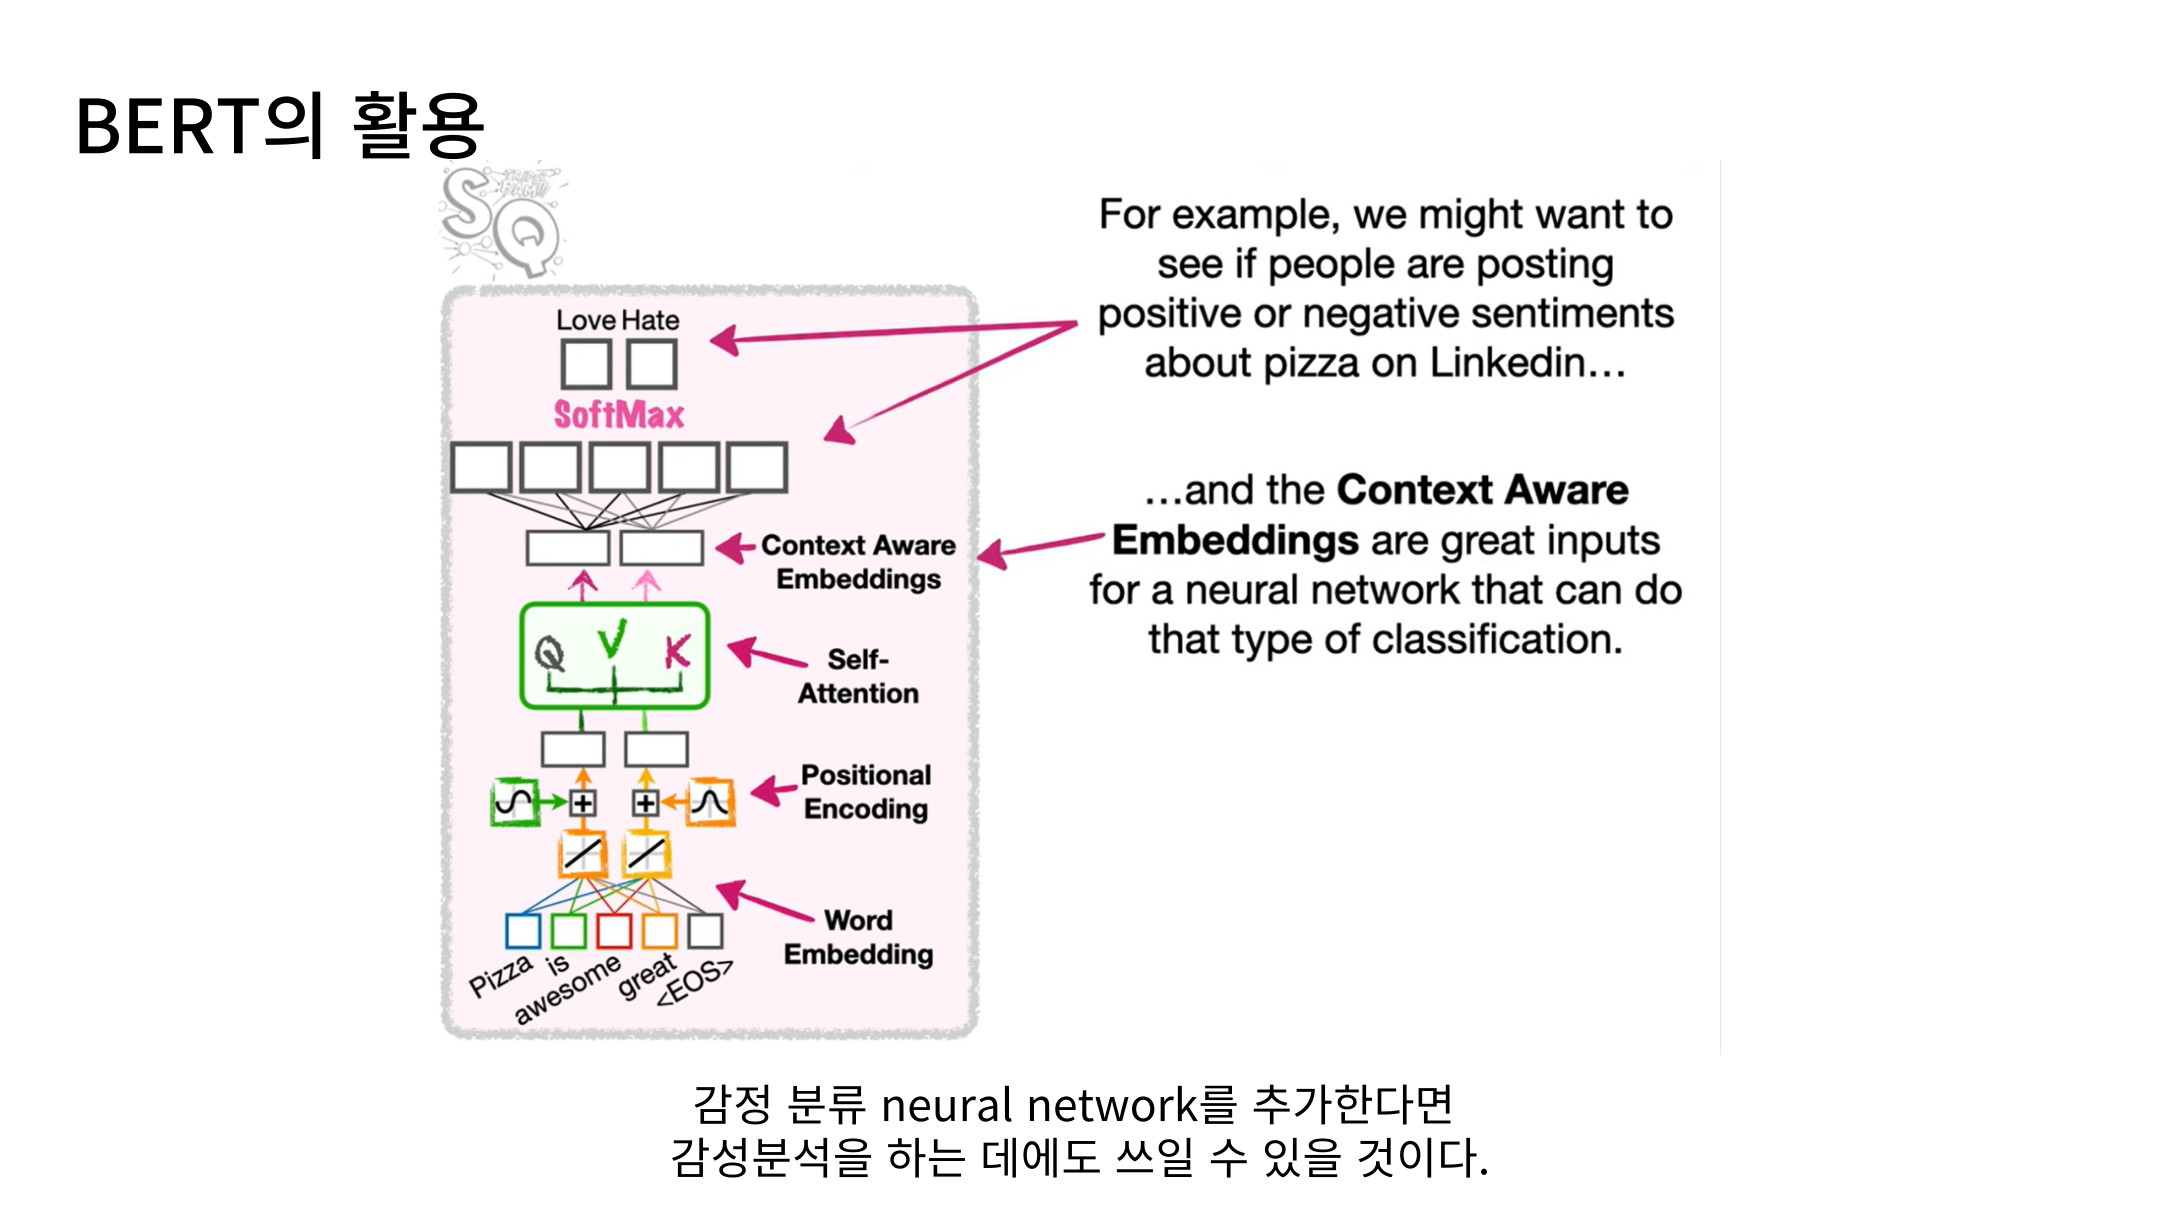
Slide 71: 감정 분류와 마무리
문맥 표현 위에 분류기를 추가하면 긍정·부정 같은 감정 분류를 수행할 수 있습니다. 이 발표의 핵심은 Attention의 가중합 → Transformer의 정보 흐름 → 문맥을 반영한 표현의 활용으로 이어집니다.