1. 서론 (Introduction)
여러분이 춤 동작을 배운다고 상상해 보세요. 기존의 방식(기존 Dynamic 3DGS)은 마치 춤추는 사람의 사진을 한 장씩 따로따로 보고 동작을 유추하는 것과 같습니다. 이 사진과 다음 사진 사이의 연결 고리를 약하게만 파악하죠. 그래서 동작이 너무 빠르거나 조명이 번쩍이면(반사 재질) 3D 모델이 깨지거나 흐릿하게 보입니다.
이 논문에서 제안하는 TimeFormer는 춤 동작 전체가 담긴 비디오를 한 번에 훑어보는 것과 같습니다. 여러 시간대의 장면(Timestamp)을 동시에 참고하여 “아, 이 팔은 이렇게 움직이는 중이구나"라고 전체적인 흐름(Motion Pattern)을 파악합니다. 가장 똑똑한 점은, 연습할 때만 이 ‘비디오 분석 능력’을 사용하고, 실제 무대(Inference)에서는 분석 도구를 떼어버려도 몸이 기억해서 똑같이 잘 춘다는 것입니다. 덕분에 속도는 그대로 유지하면서 퀄리티만 높일 수 있습니다.
2. 기술 설명 (Method)
이 섹션에서는 TimeFormer가 어떻게 시간적 관계를 학습하고 최적화하는지 설명합니다.
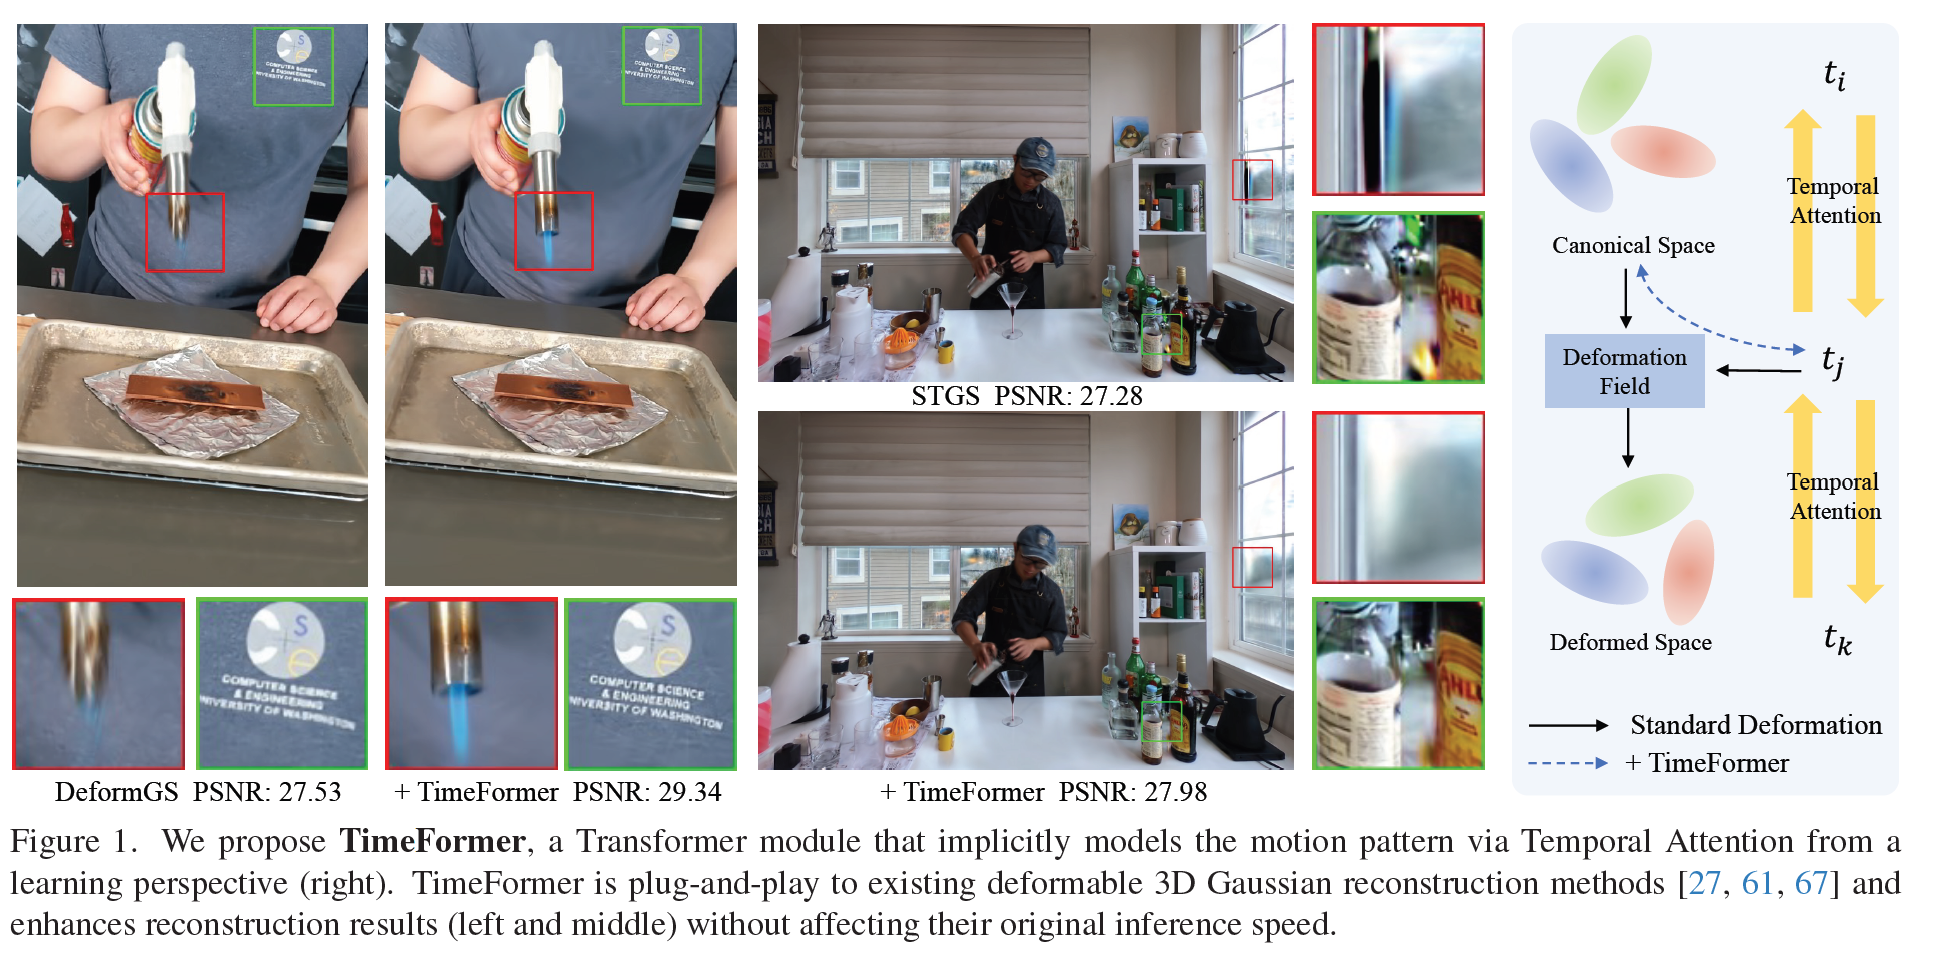
이 그림은 TimeFormer의 핵심 개념을 보여줍니다. 오른쪽 다이어그램처럼 여러 시간대($t_i, t_j, t_k$)의 정보를 Temporal Attention을 통해 서로 참고합니다. 이를 통해 Deformation Field가 전체적인 움직임 패턴을 학습하게 됩니다.
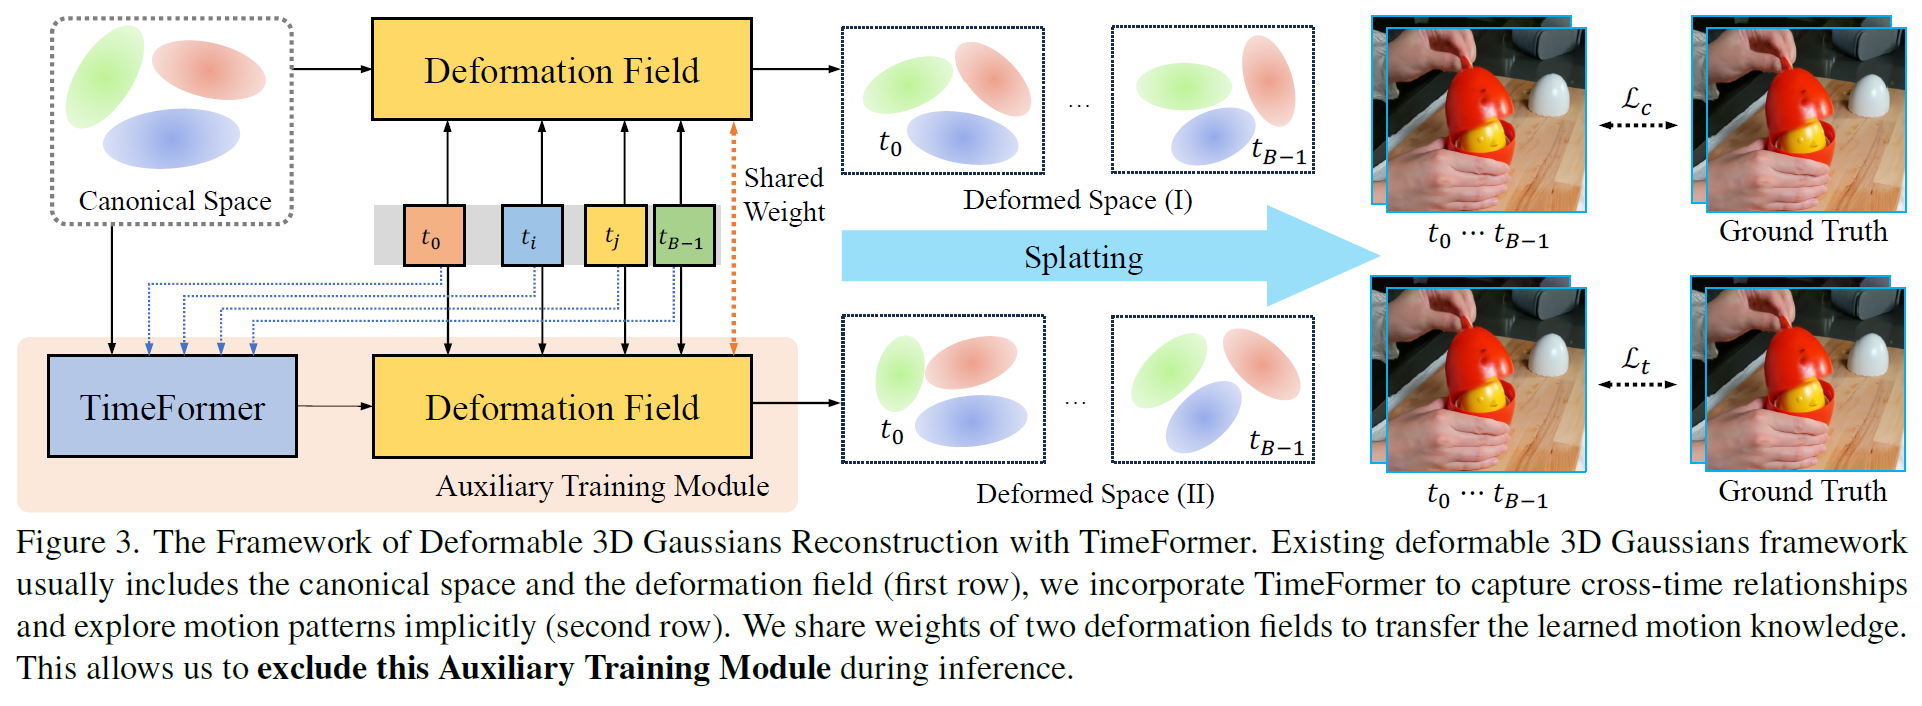
TimeFormer의 전체 프레임워크입니다.
- 위쪽 (Base Stream): 기존의 방식대로 Canonical Space의 3D Gaussian이 Deformation Field를 거쳐 변형됩니다.
- 아래쪽 (TimeFormer Stream): TimeFormer가 시간적 관계를 분석하여 Deformation Field를 돕습니다.
중요한 건 두 개의 Deformation Field가 가중치(Weight)를 공유한다는 점입니다(점선 화살표). 즉, 아래쪽에서 똑똑하게 학습한 내용을 위쪽 모델도 공유받게 되어, 나중에는 아래쪽 모듈을 제거해도 됩니다.
2.1 3D Gaussian Splatting 기초
먼저 3D Gaussian Splatting의 기본 수식입니다.
수식 분석: 3D 공간의 위치 $x$에 대한 Gaussian의 영향력을 나타냅니다. $\mu$는 중심 위치(Mean), $\Sigma$는 공분산 행렬(Covariance Matrix)로 가우시안의 모양(타원체)을 결정합니다. $o$는 불투명도(Opacity)입니다. 이는 통계적 확률 분포 함수를 3D 렌더링의 기본 입자(Primitive)로 차용한 것으로, 미분 가능한 렌더링 파이프라인을 구축하는 핵심입니다.
수식 분석: $\alpha$-blending 식입니다. $c_i$는 색상, $\alpha_i$는 밀도입니다. 시선 방향을 따라 정렬된 Gaussian들의 기여도를 누적하여 픽셀 색상 $C$를 결정합니다. NeRF의 Volume Rendering 적분식을 이산적(Discrete)인 Gaussian들의 합으로 근사하여 고속 렌더링을 가능하게 합니다.
2.2 Deformation Field와 TimeFormer
동적인 장면을 표현하기 위해 Canonical Space(기준 공간)의 가우시안을 시간 $t$에 따라 변형시킵니다.
수식 분석: Deformation Field $\mathcal{D}$는 기준 위치 $\mu$와 시간 $t$를 입력받아 위치, 회전, 크기의 변화량($\Delta$)을 출력합니다. 이는 시공간 $R^4$에서 $R^3$로의 매핑 함수로 볼 수 있습니다.
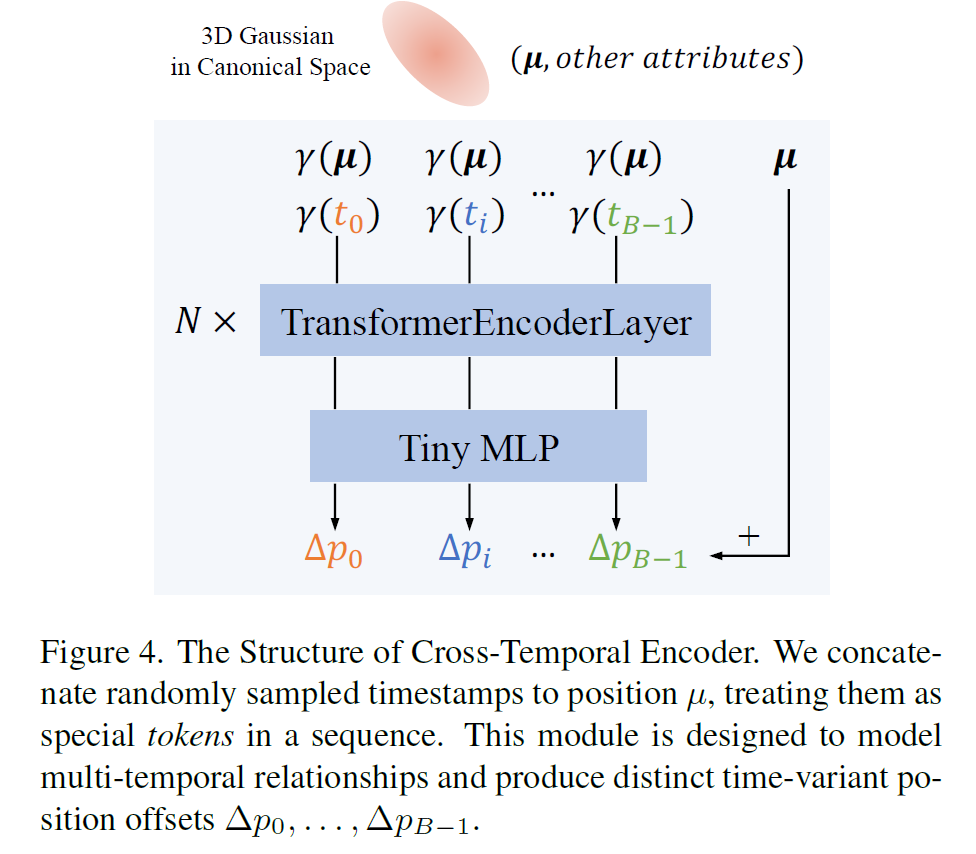
Cross-Temporal Encoder의 구조입니다. Canonical Gaussian 위치 $\mu$에 여러 시간대($t_0, …, t_{B-1}$)를 결합하여 Transformer에 입력하고, 각 시간대에 맞는 위치 오프셋($\Delta p$)을 출력합니다.
TimeFormer를 위해 위치 인코딩(Positional Encoding)을 사용합니다.
수식 분석: 저주파 신호인 좌표값 $p$를 고주파 영역으로 매핑하여 신경망이 고주파수 세부 정보(High-frequency details)를 더 잘 학습하도록 돕습니다. Fourier Feature Mapping의 일종입니다.
TimeFormer의 출력은 다음과 같이 잔차(Residual) 형태로 더해집니다.
2.3 Gradient Flow Analysis (핵심 이론)
이 논문의 이론적 기여는 Gradient 분석에 있습니다. 기존 방식의 Gradient는 다음과 같습니다.
하지만 TimeFormer를 적용하면 Chain Rule에 의해 항이 추가됩니다.
수식 분석: 여기서 $\mathcal{P}(\mu, \mathcal{T}_s)$는 TimeFormer 모듈입니다. 추가된 항 $\frac{\partial \mathcal{P}}{\partial \mu}$는 현재 시간 $t_i$뿐만 아니라 전체 타임 배치 $\mathcal{T}_s$ (과거 및 미래)의 정보를 포함합니다. 즉, Backpropagation 과정에서 특정 시점의 학습이 다른 모든 시점의 상태를 고려하여 업데이트되도록 유도합니다. 이것이 ‘Global View’를 갖게 하는 수학적 원리입니다.
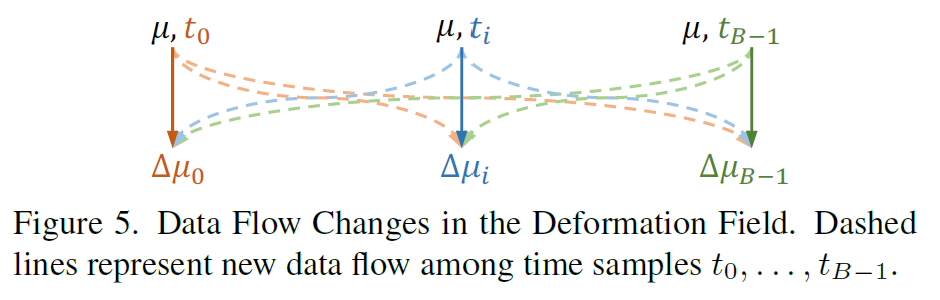
데이터 흐름의 변화를 보여줍니다. 점선은 TimeFormer에 의해 시간 샘플들($t_0…t_{B-1}$) 사이에 새로운 정보 흐름이 생겼음을 의미합니다.
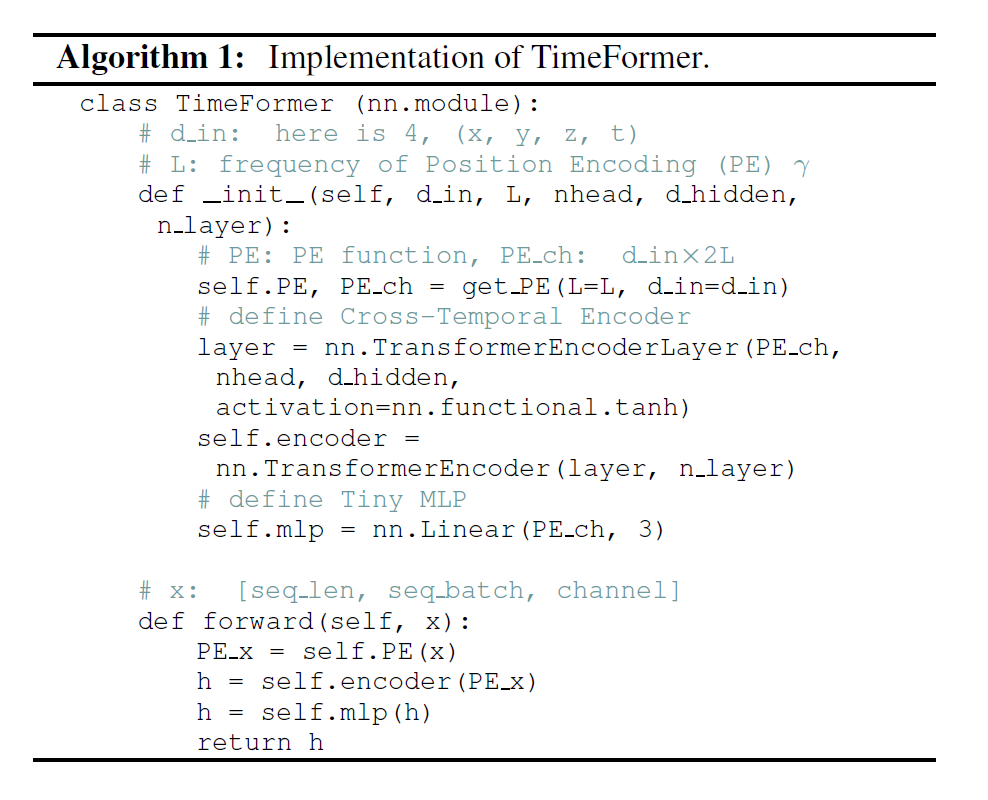
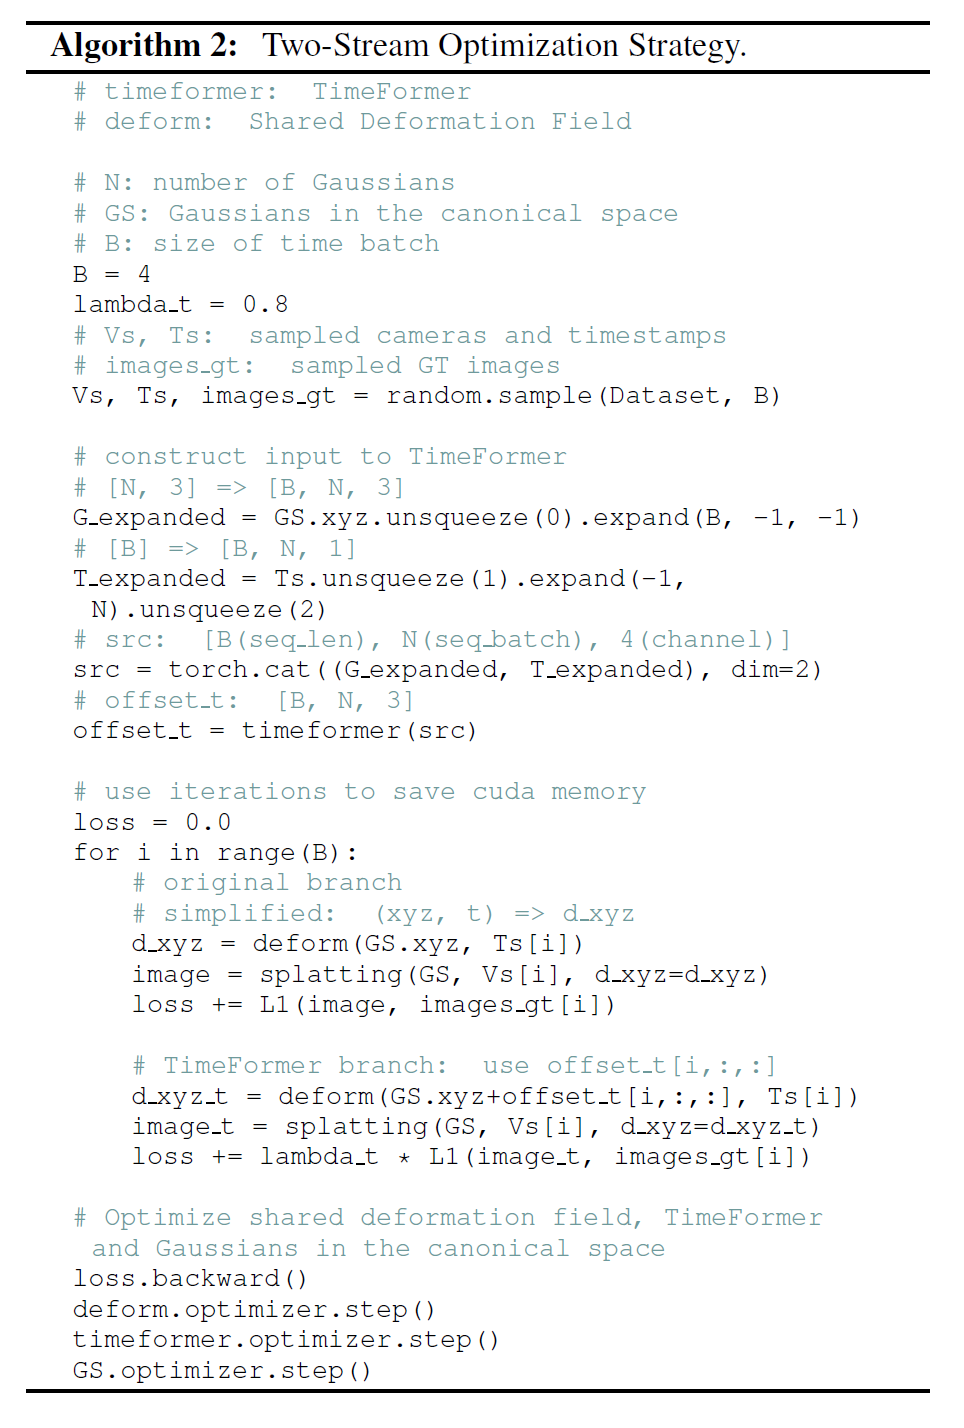
TimeFormer의 구현 코드와 Two-Stream 최적화 전략에 대한 의사 코드(Pseudo-code)입니다. 학습 시에는 두 스트림을 모두 계산하고, 추론 시에는 TimeFormer를 끕니다.
2.4 Loss Function
수식 분석: 전체 손실 함수는 Original Branch의 손실 $\mathcal{L}_c$와 TimeFormer Branch의 손실 $\mathcal{L}_t$의 가중 합입니다. $\lambda_t$를 약간 작게 설정하여 TimeFormer 쪽에 과적합(Overfitting)되는 것을 방지합니다.
3. 실험 (Experiment)
TimeFormer의 성능을 검증하기 위해 다양한 데이터셋에서 실험을 진행했습니다.
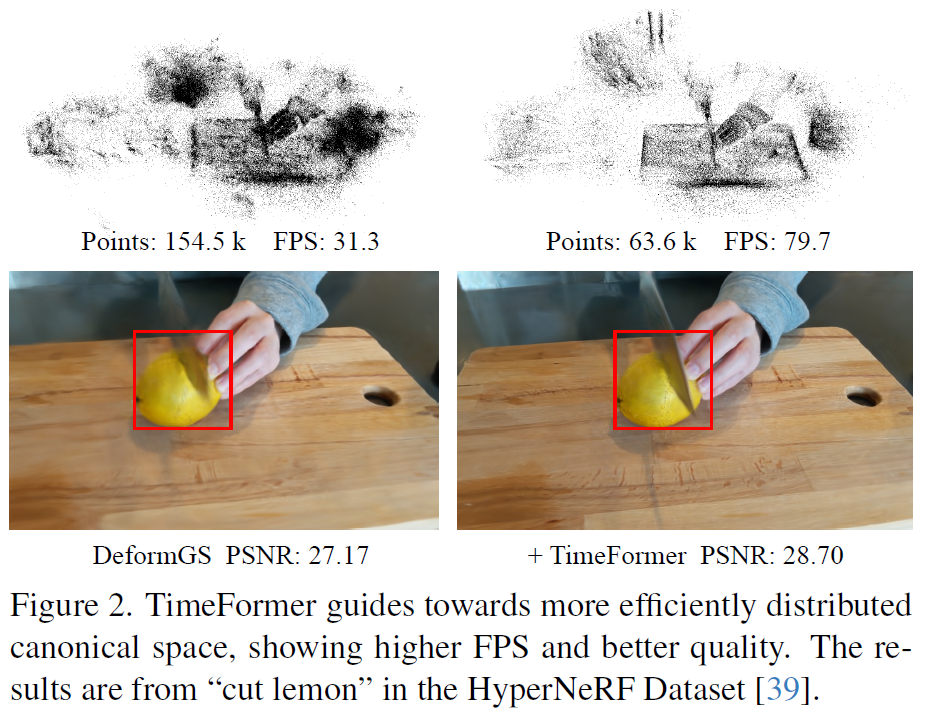
TimeFormer가 적용된 모델(오른쪽)이 더 적은 수의 점(Points)을 사용하면서도 더 높은 FPS(초당 프레임 수)와 품질(PSNR)을 보여줍니다. Canonical Space가 더 효율적으로 구성되었음을 의미합니다.
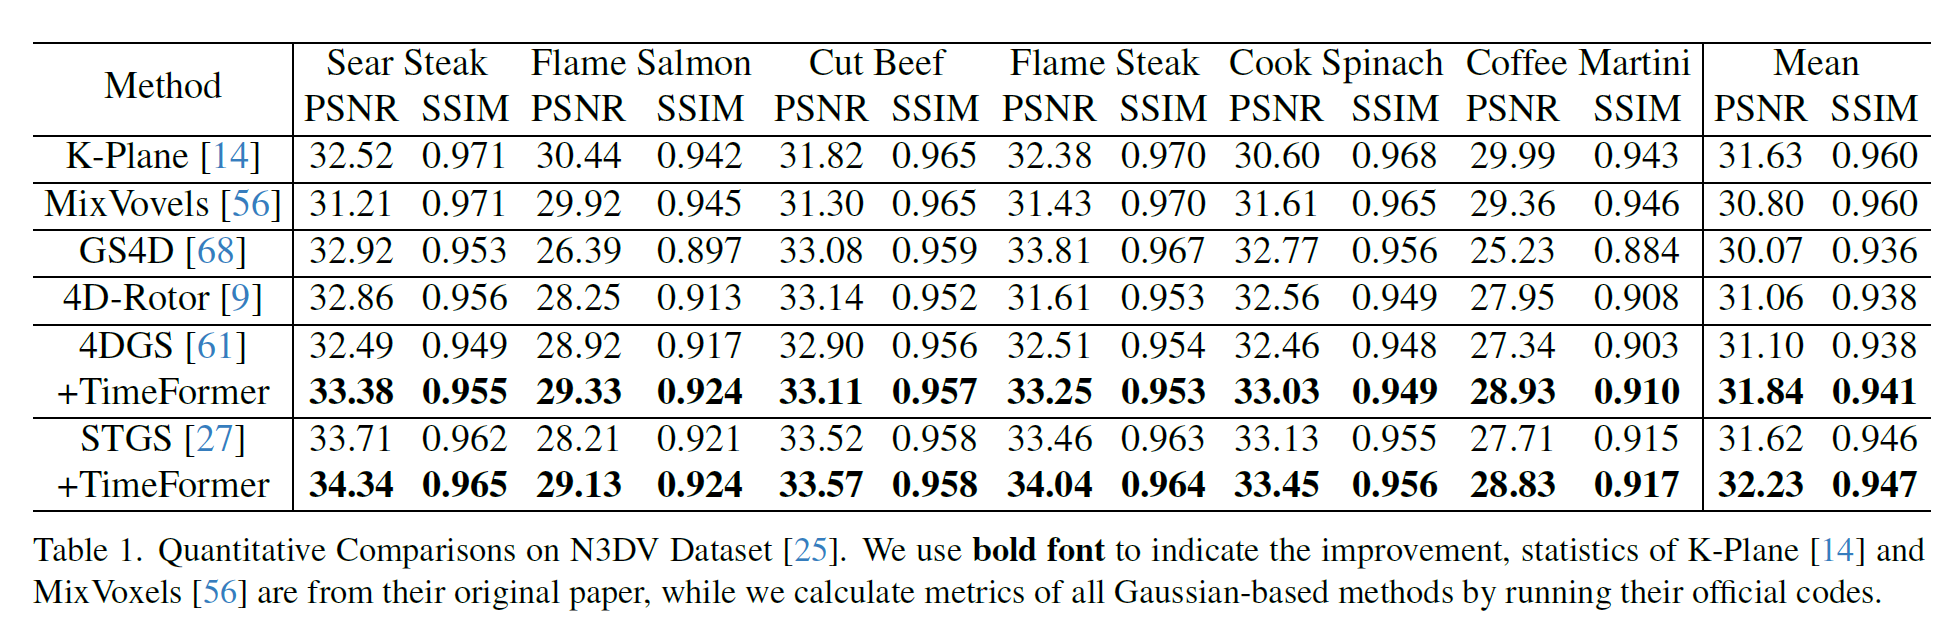
N3DV 데이터셋(다시점 비디오)에서의 정량적 비교입니다. TimeFormer를 추가했을 때 4DGS와 STGS 모델 모두에서 PSNR(화질) 수치가 향상되었습니다.
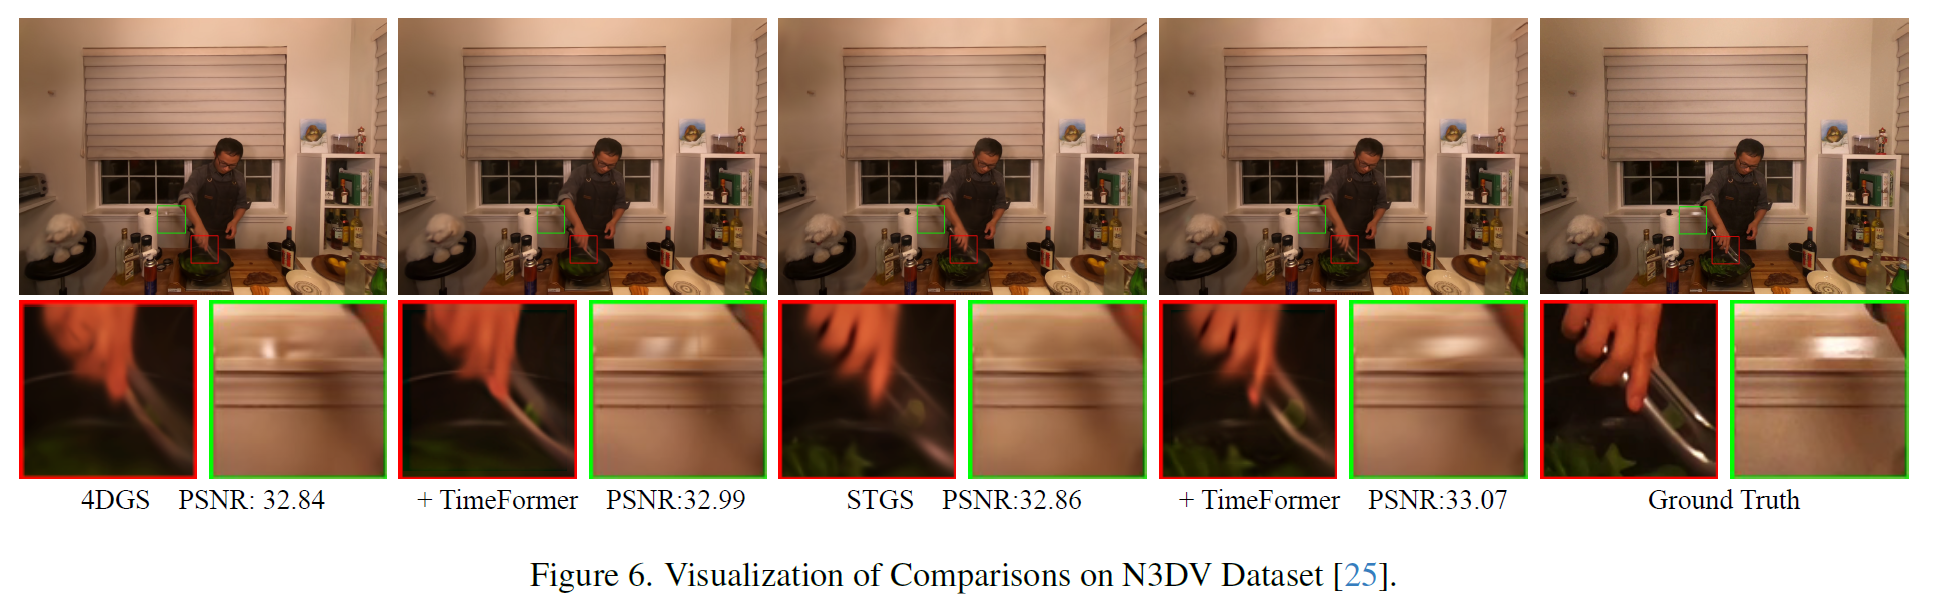
N3DV 데이터셋의 시각적 비교입니다. 요리 장면에서 흐릿한 부분 없이 선명한 기하학적 구조를 복원했습니다.
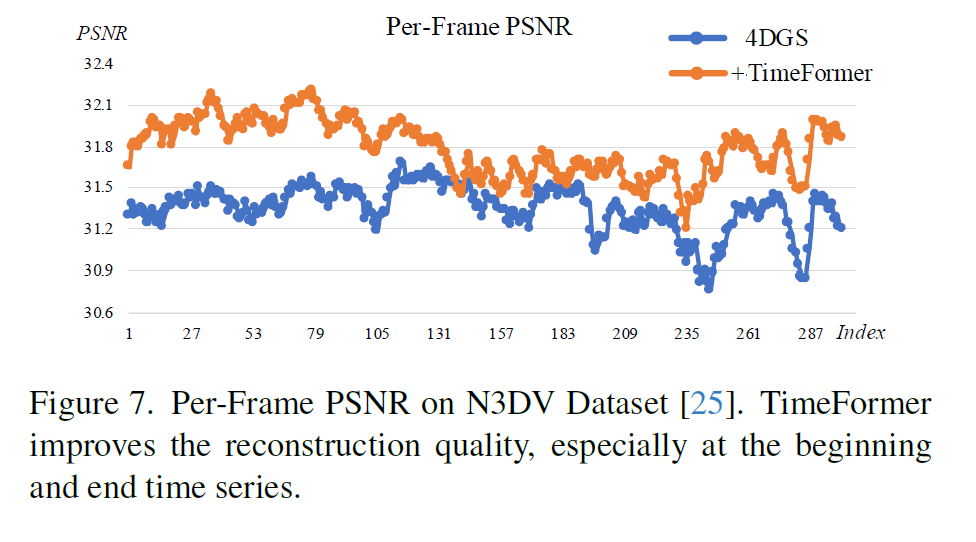
프레임별 PSNR 변화 그래프입니다. TimeFormer(주황색)가 전체적으로 파란색(기본 모델)보다 위에 있으며, 특히 영상의 시작과 끝부분에서도 안정적인 품질을 유지합니다.
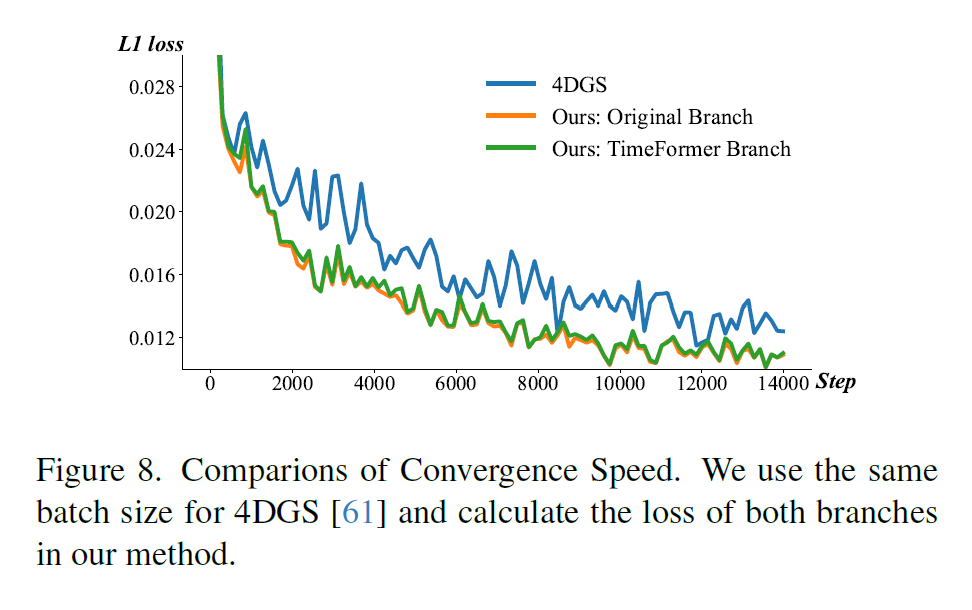
학습 곡선(Convergence Speed)입니다. TimeFormer를 사용하면 Loss가 더 빠르게 감소하여 학습 속도가 빨라집니다. 두 Branch의 Loss가 비슷하게 떨어지는 것은 지식 전이(Knowledge Transfer)가 잘 되고 있음을 보여줍니다.
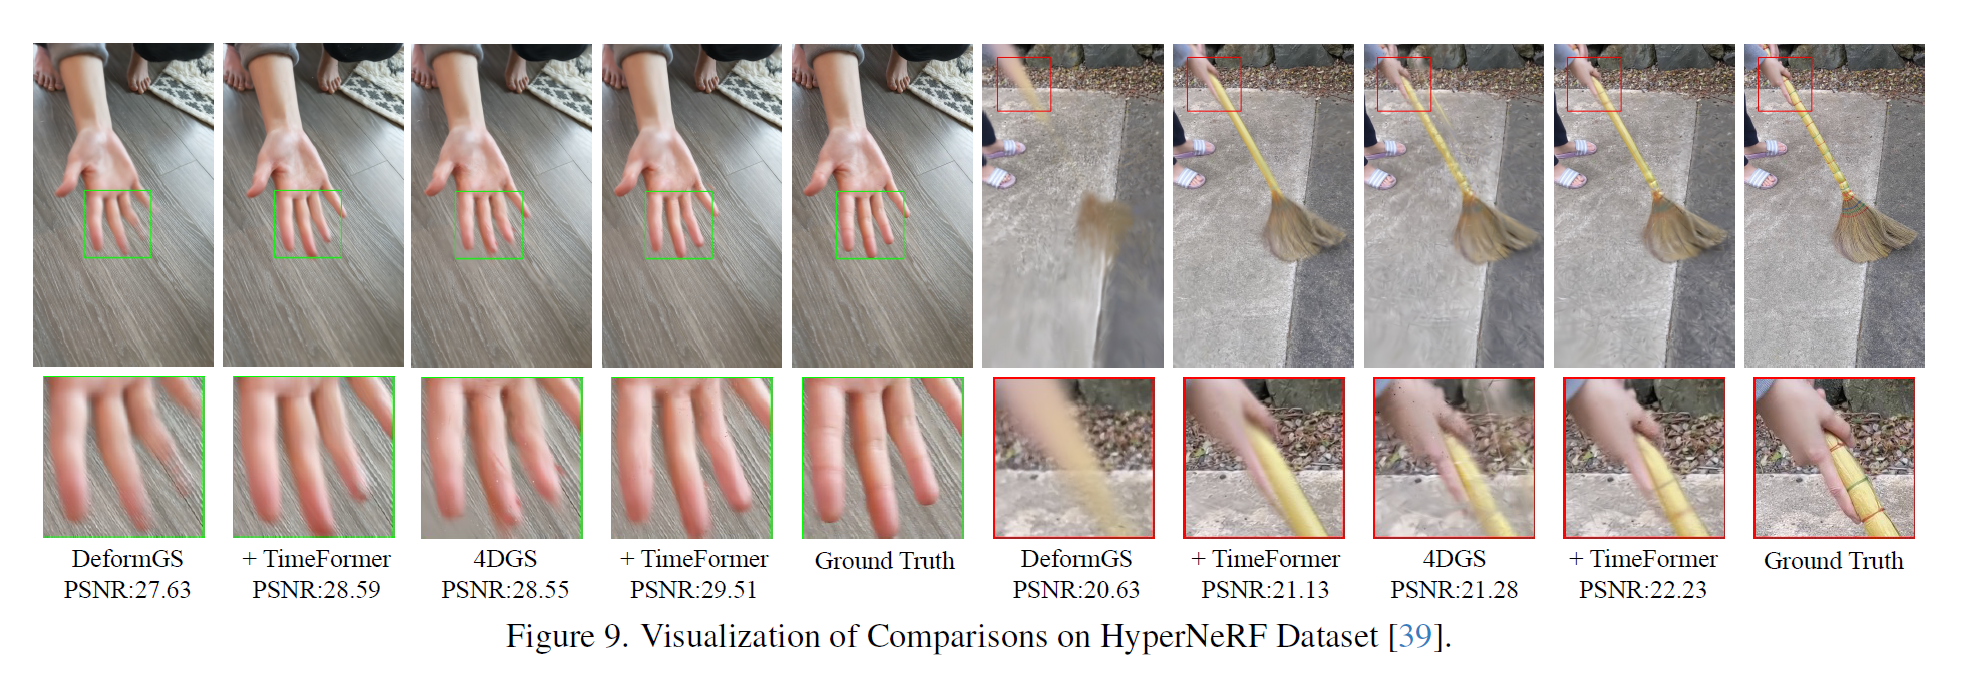
HyperNeRF 데이터셋(단안 비디오) 비교입니다. 손가락 사이나 빗자루 같은 복잡한 구조를 더 명확하게 표현합니다.
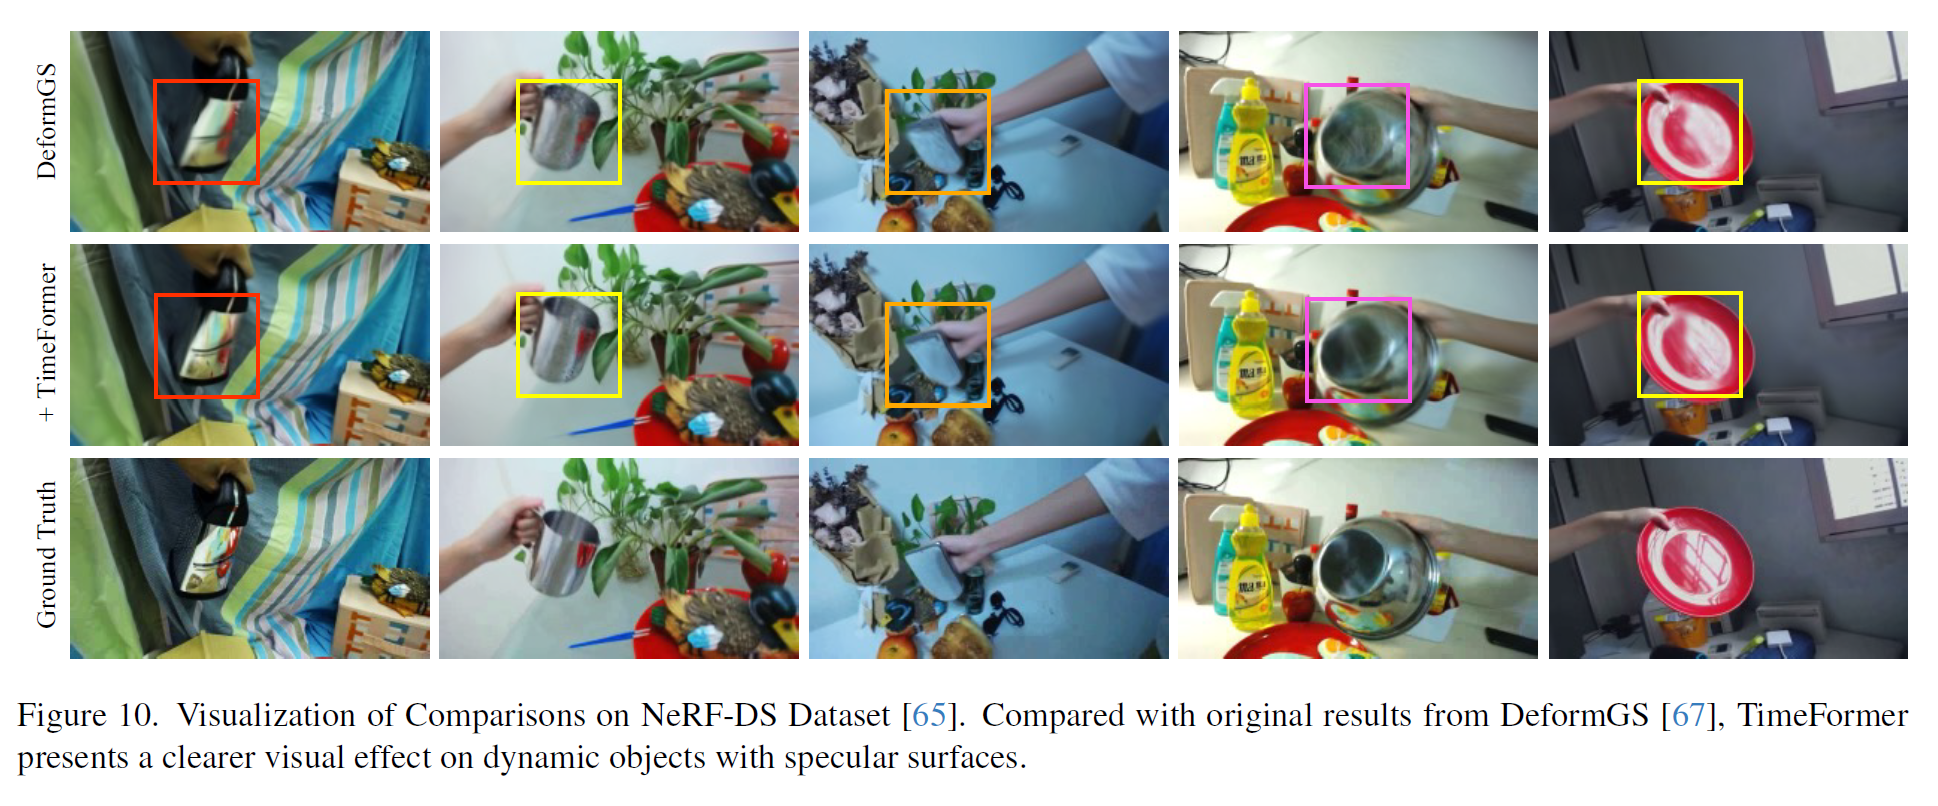
NeRF-DS 데이터셋(반사체 포함) 비교입니다. 반짝이는 컵이나 유리병의 표면 반사를 훨씬 깨끗하게 렌더링합니다.
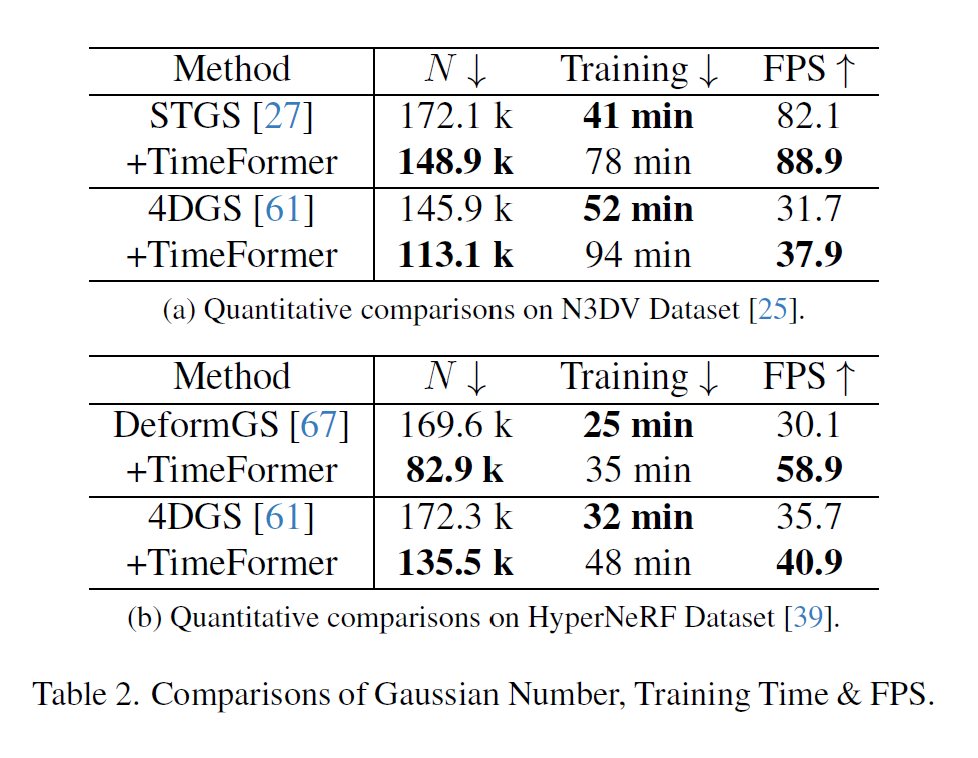
학습 시간과 FPS, 가우시안 개수 비교입니다. TimeFormer를 쓰면 학습 시간은 조금 늘어나지만, 추론 FPS는 오히려 높아지고 가우시안 개수는 줄어듭니다(효율성 증가).
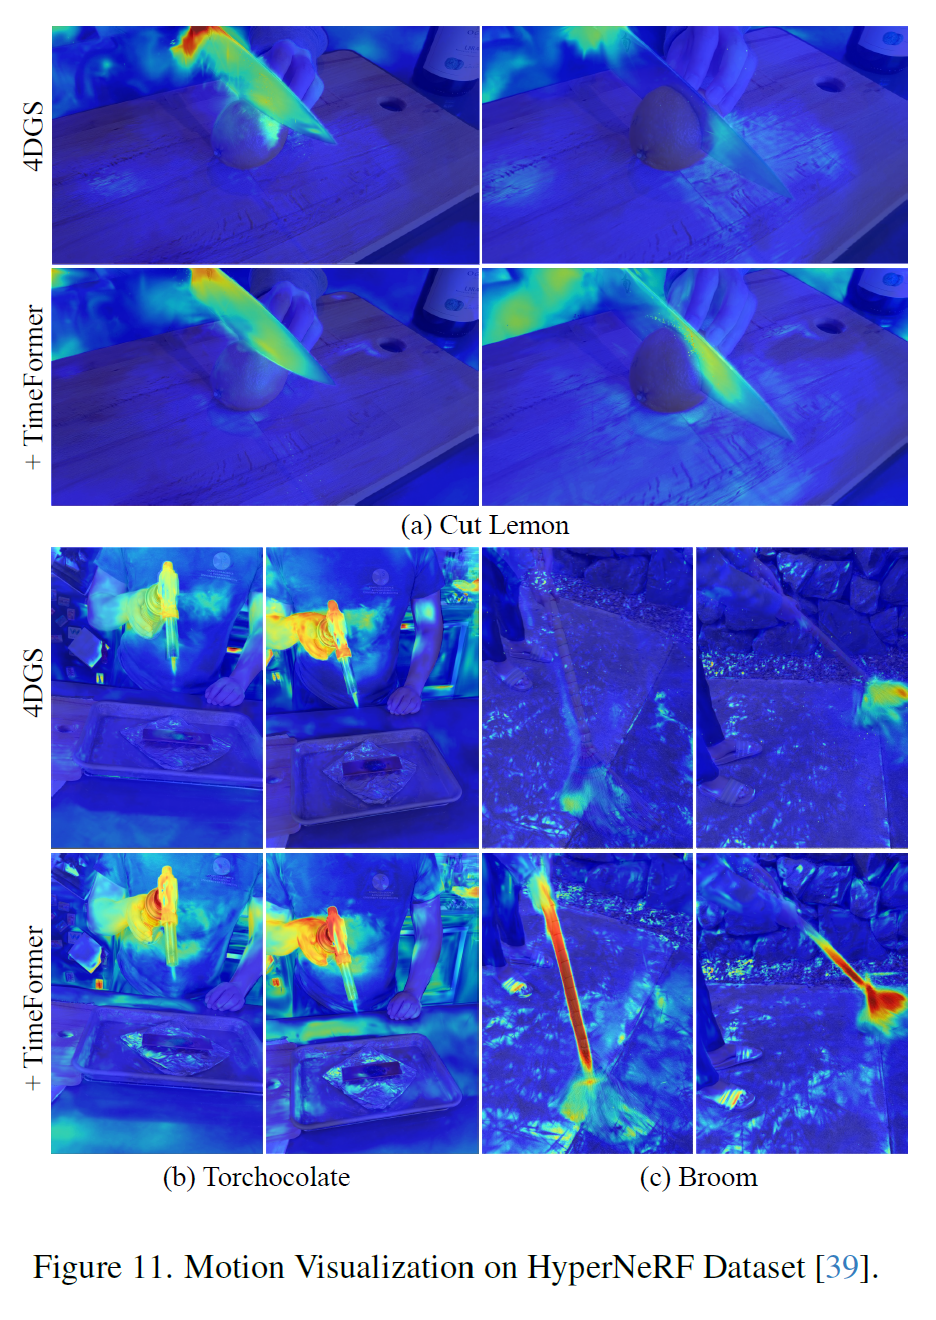
이 그림은 매우 흥미롭습니다. 움직임의 변화(Motion Bias)를 히트맵으로 시각화했습니다. 칼이 레몬을 자르는 순간이나 불꽃이 흔들리는 미세한 움직임을 TimeFormer가 정확히 포착하고 있음을 보여줍니다.
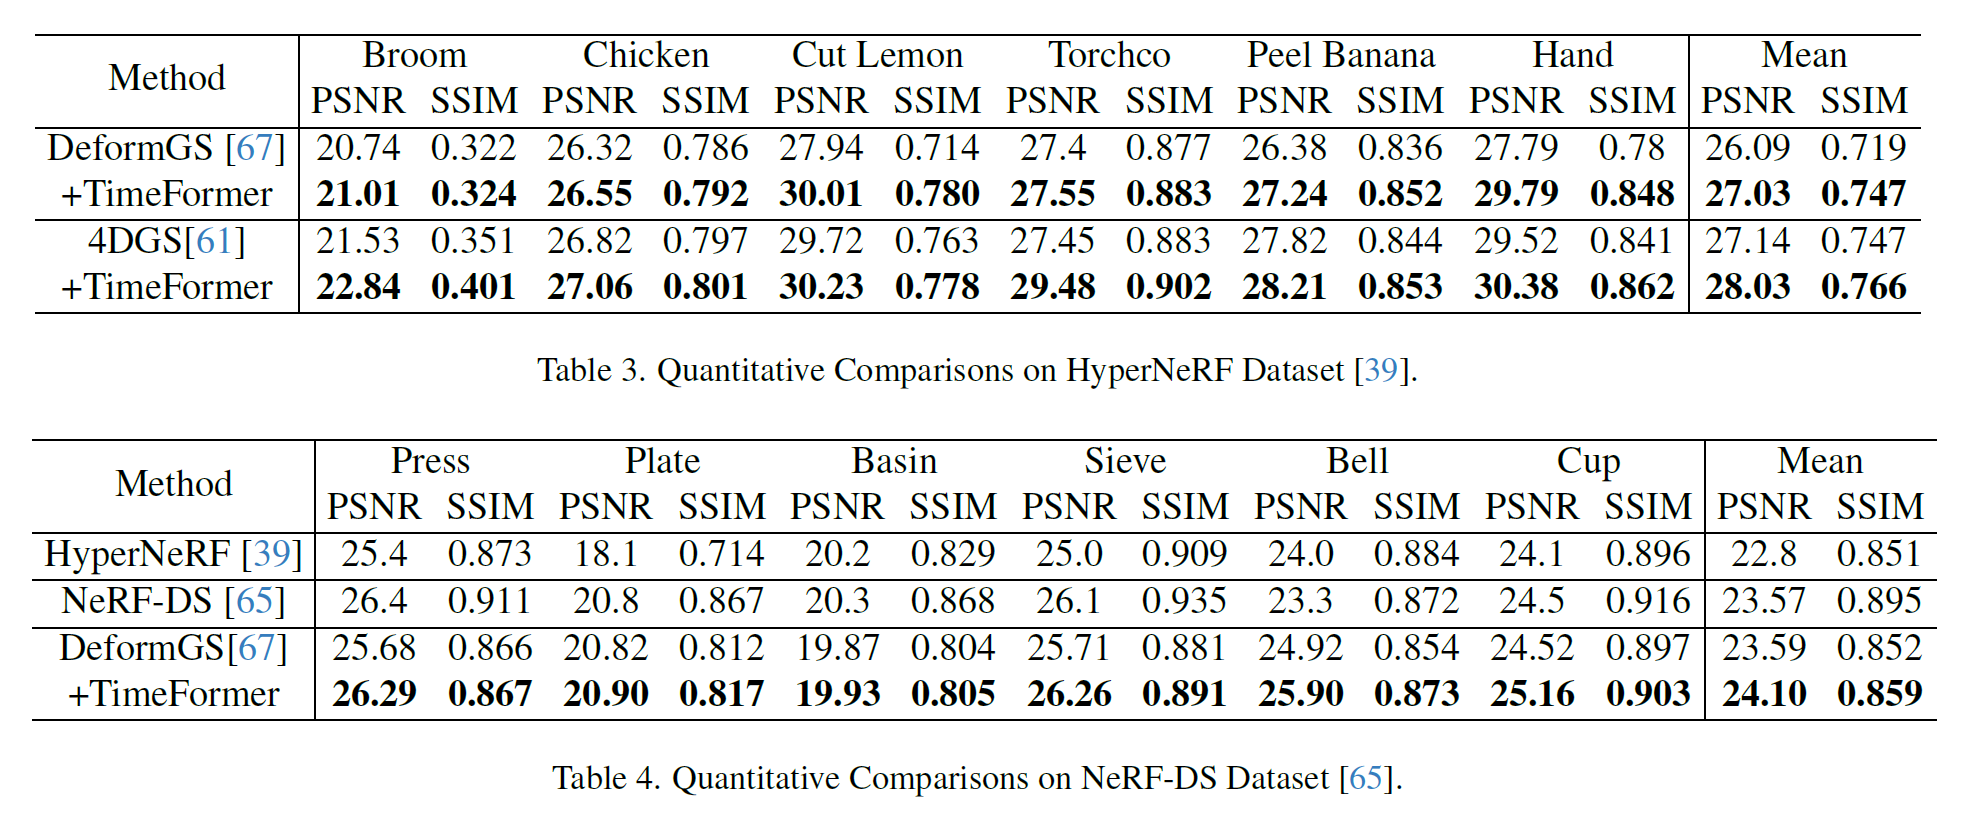
HyperNeRF와 NeRF-DS 데이터셋에 대한 추가적인 정량적 수치 표입니다. 모든 지표(PSNR, SSIM)에서 성능 향상을 확인했습니다.
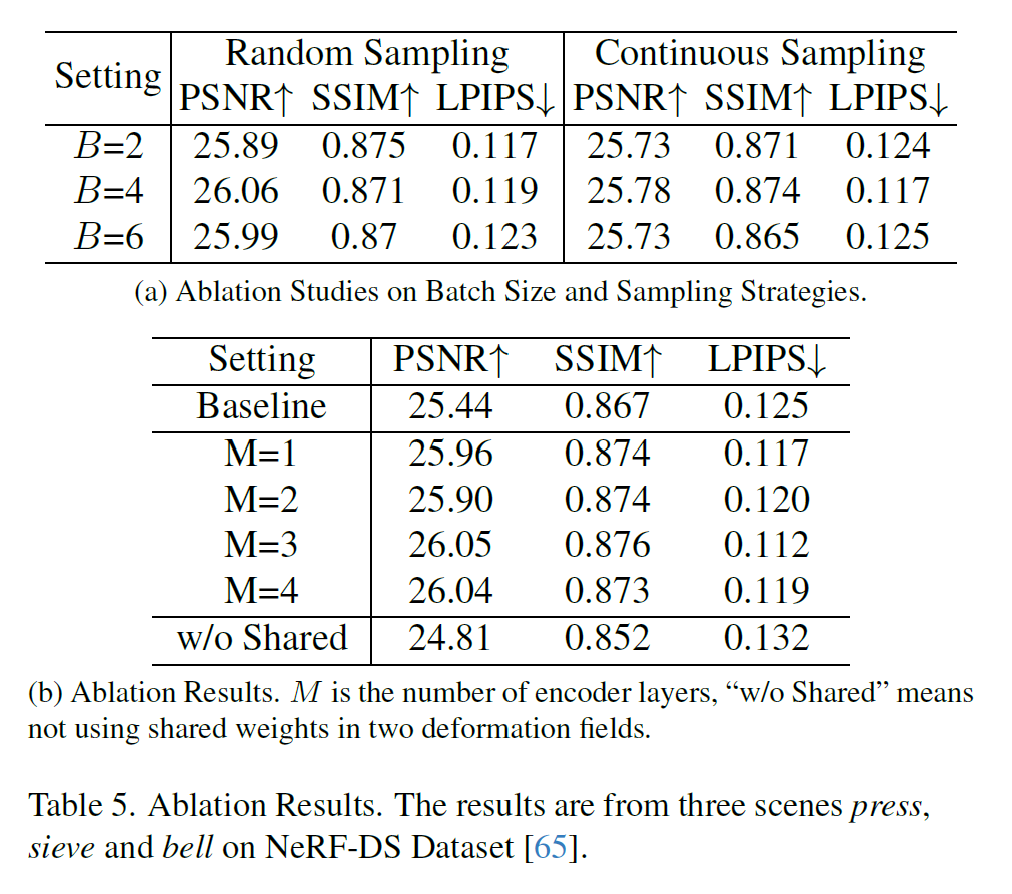
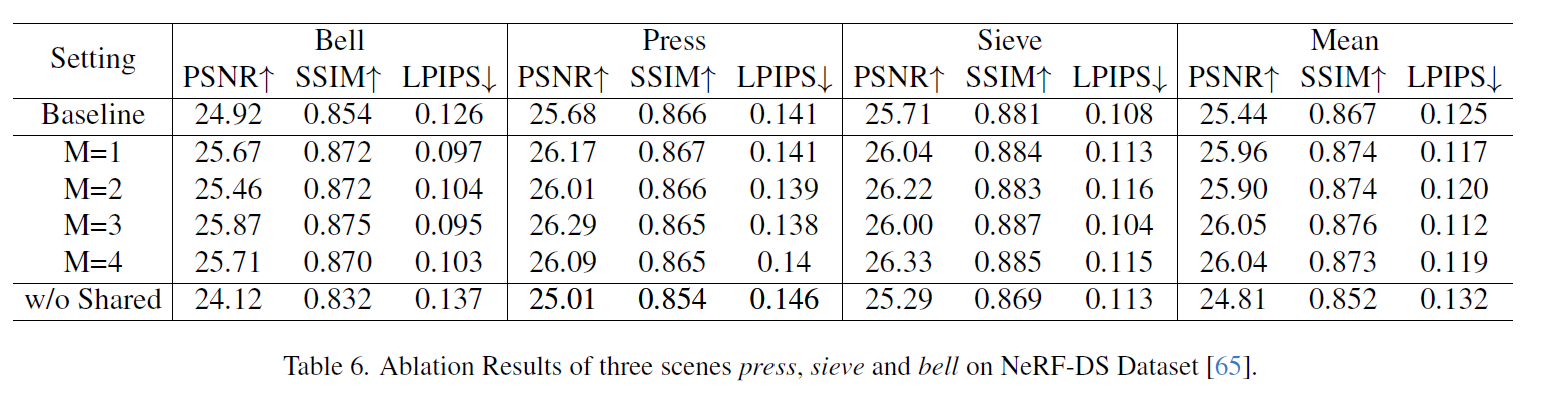
Ablation Study(소거법 연구) 결과입니다. Transformer 레이어 수(M)나 시간 배치 크기(B)에 크게 민감하지 않으며, “Shared Weights(가중치 공유)” 전략이 없으면 성능이 크게 떨어짐을 보여줍니다.
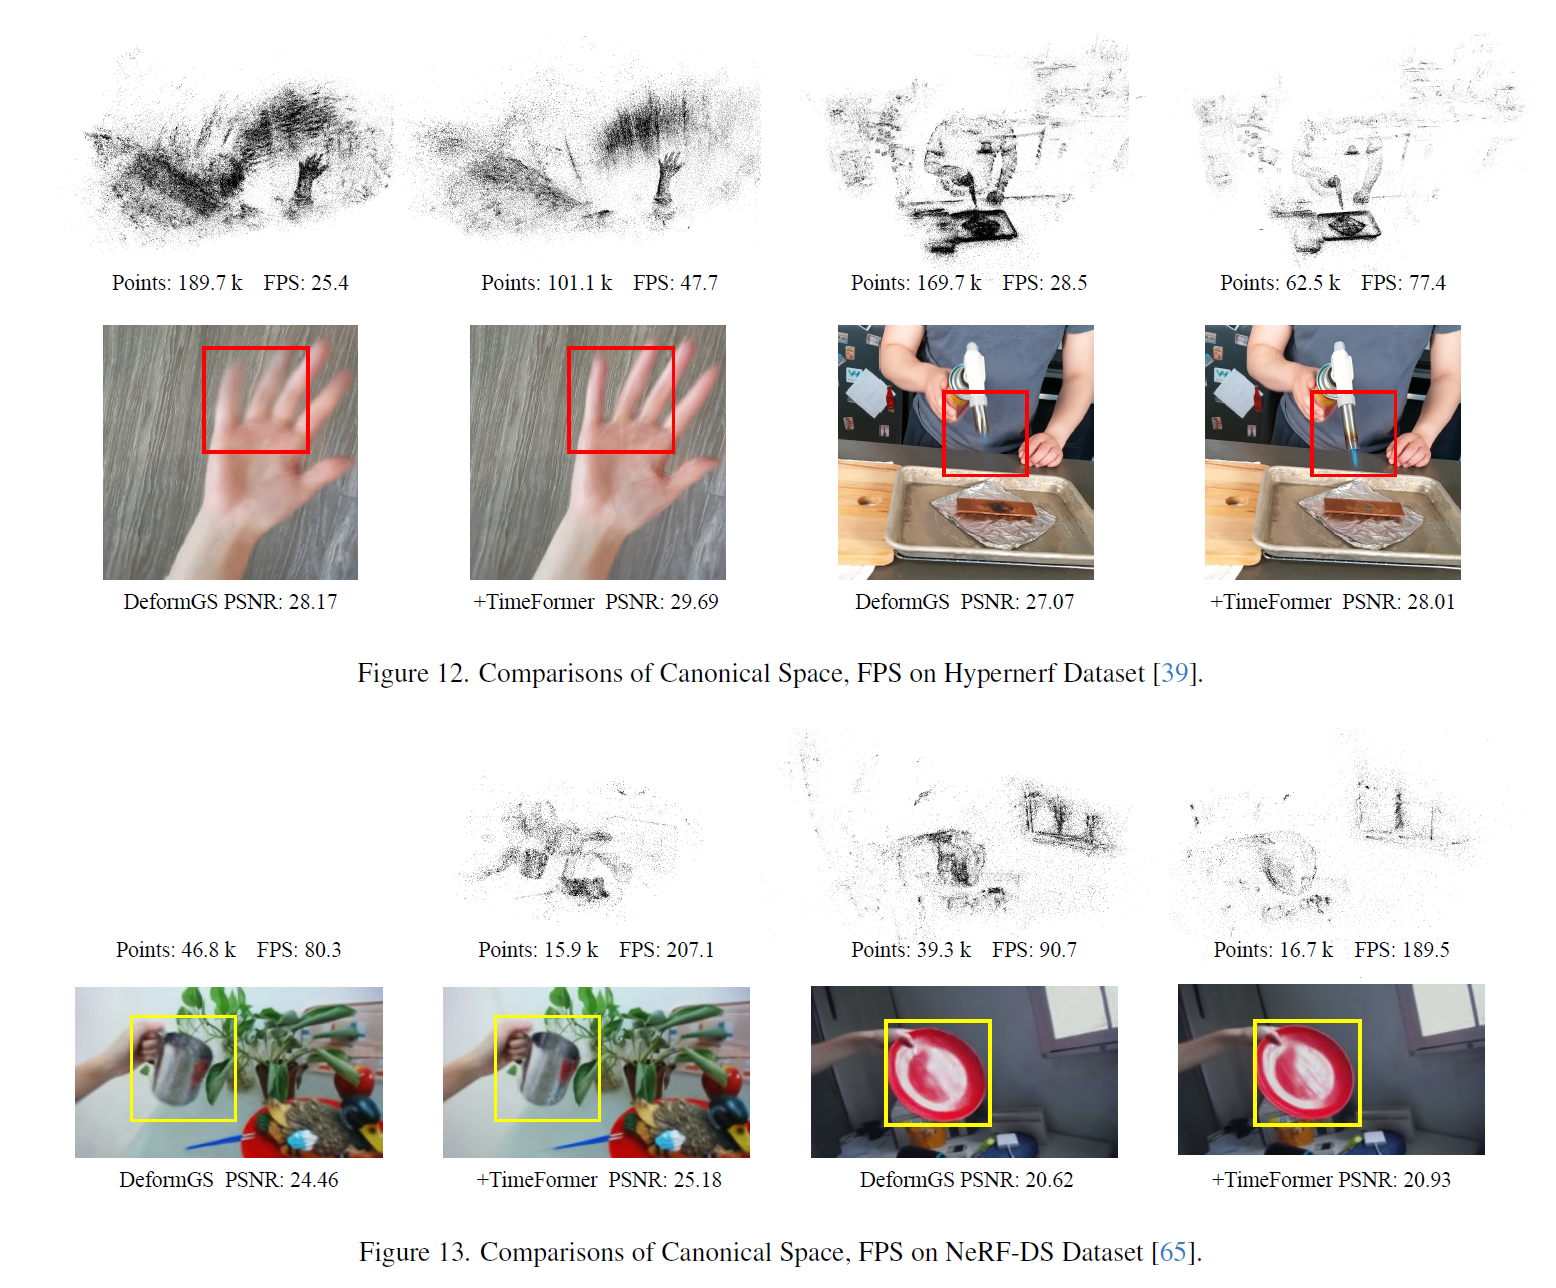
Canonical Space의 가우시안 분포와 FPS를 비교한 추가 자료입니다. TimeFormer가 불필요한 가우시안을 제거하여 더 깔끔한 공간 분포를 만듭니다.
4. 결론 (Conclusion)
이 논문은 TimeFormer라는 플러그 앤 플레이(Plug-and-play) 모듈을 제안했습니다. 이 모듈은 Global Temporal Attention을 통해 복잡한 움직임과 반사 재질을 효과적으로 학습합니다. 특히 Two-stream Optimization 전략 덕분에, 추론 시에는 추가적인 연산 비용 없이 기존 모델보다 더 빠르고 정확한 렌더링이 가능합니다. 한계점으로는 일부 복잡한 디테일이 너무 부드럽게(Overly smooth) 표현될 수 있다는 점이 있습니다.