이 논문은 사람이 일일이 사진에 “이건 고양이야”, “저건 강아지야"라고 알려주지 않아도, 컴퓨터가 스스로 이미지의 특징을 학습하는 방법에 대한 연구입니다. 특히 아주 간단하면서도 효과적인 방법을 제시하여 큰 주목을 받았습니다.
컴퓨터에게 사진을 주고 이게 뭔지 맞혀보라고 시키는 걸 **지도 학습(Supervised Learning)**이라 합니다. 정답을 알려주면서 공부시키는 거죠. 하지만 세상에는 정답이 없는 사진이 훨씬 많습니다. 이 정답 없는 사진들로 컴퓨터를 똑똑하게 만들 순 없을까요? 이게 바로 **‘자기 지도 학습(Self-Supervised Learning)’**의 목표입니다.
SimCLR이 사용하는 방법은 **‘대조 학습(Contrastive Learning)’**이라는 건데요, 아주 간단한 아이디어에서 출발합니다.
예시: 강아지 사진이 한 장 있다고 상상해 봅시다.
- 이 사진을 가지고 약간 다른 버전의 사진 두 장을 만듭니다. 예를 들어, 한 장은 강아지 얼굴만 확대(crop)하고, 다른 한 장은 색감을 살짝 바꾸는(color distortion) 거죠.
- 컴퓨터에게 이 두 사진은 ‘같은 강아지’에서 나온 긍정적 쌍(positive pair) 이라고 알려줍니다.
- 그리고 동시에, 전혀 다른 사진들(예: 고양이, 자동차, 나무 사진)을 보여주면서, 이것들은 방금 본 강아지 사진과 다른 부정적 쌍(negative pair) 이라고 알려줍니다.
이 과정을 수많은 사진으로 반복하면, 컴퓨터는 점차 ‘어떤 특징’이 같은 대상을 나타내고, ‘어떤 특징’이 다른 대상을 나타내는지 스스로 배우게 됩니다. 즉, ‘강아지다움’이 무엇인지 그 본질적인 **표현(representation)**을 학습하게 되는 거죠. SimCLR은 이 간단한 원리를 매우 효과적으로 구현한 프레임워크입니다.
- 참고: Stochastic Optimization Review (표현 학습 관련 발표 자료)
1. 서론 (Introduction)
연구의 시작은 “사람의 정답 없이 어떻게 컴퓨터가 **시각적 표현(visual representation)**을 배울 수 있을까?“라는 오랜 질문에서 출발합니다. 기존의 방법들은 복잡한 구조를 필요로 하거나, 대량의 이전 데이터를 저장해두는 메모리 뱅크(memory bank) 같은 부가적인 장치가 필요했습니다.
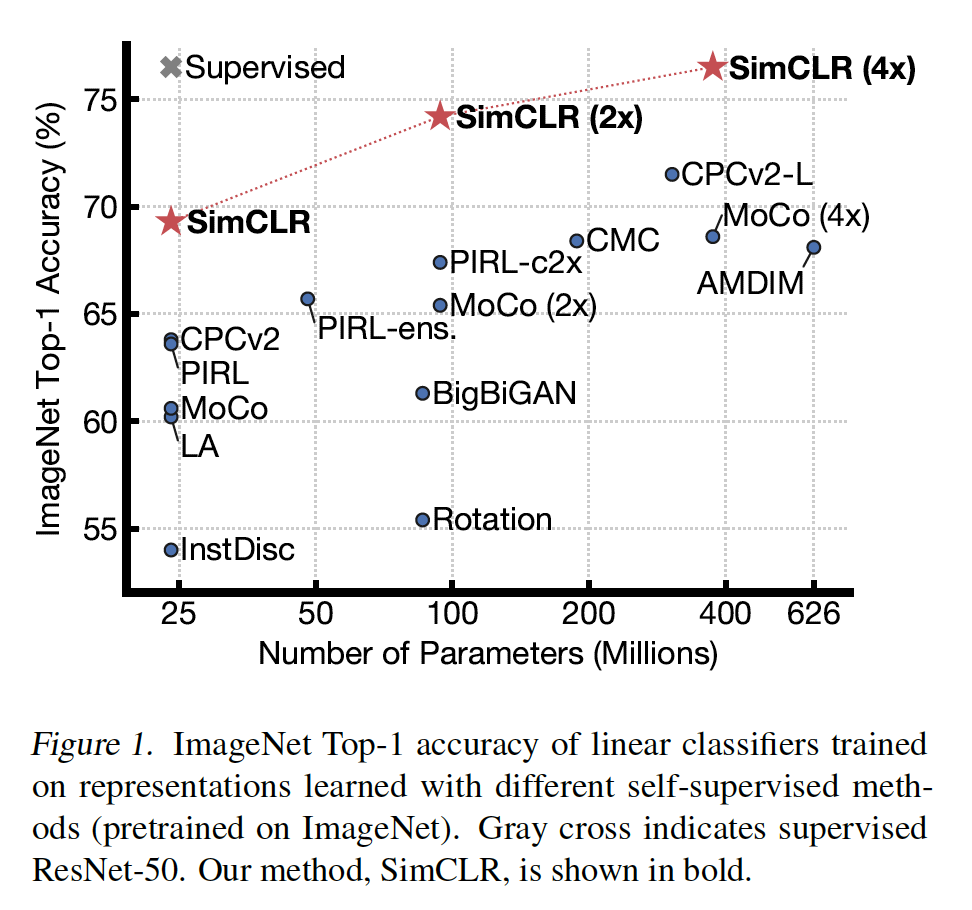
Figure 1은 SimCLR이 나오기 전까지의 여러 자기 지도 학습 모델들의 성능을 보여주는 그래프입니다. 가로축은 모델의 크기(Number of Parameters), 세로축은 이미지 분류 정확도(ImageNet Top-1 Accuracy)를 나타냅니다. 이 그래프에서 **SimCLR(별 모양 ★)**은 다른 모델들(점 모양 •)에 비해 훨씬 적은 파라미터로 더 높은 정확도를 달성하며, 심지어 사람이 정답을 알려주고 학습시킨 **지도 학습 모델(Supervised, 회색 십자가)**의 성능과 맞먹는 것을 보여줍니다. 이는 매우 간단한 프레임워크가 기존의 복잡한 방법들을 뛰어넘을 수 있음을 시사합니다.
이 논문은 SimCLR의 성공 비결이 다음 세 가지 핵심 요소의 조합에 있음을 체계적인 실험을 통해 보여줍니다.
- 데이터 증강 기법의 조합이 효과적인 표현을 학습하는 데 매우 중요하다.
- 모델의 최종 표현(representation)과 손실 함수(loss function) 사이에 **비선형 변환(nonlinear transformation)**을 추가하는 것이 성능을 크게 향상시킨다.
- 대조 학습은 지도 학습보다 더 큰 **배치 크기(batch size)**와 더 긴 학습 시간으로부터 더 큰 이득을 얻는다.
2. 기술 설명 (Technical Description)
SimCLR 프레임워크는 네 가지 주요 구성 요소로 이루어져 있습니다.
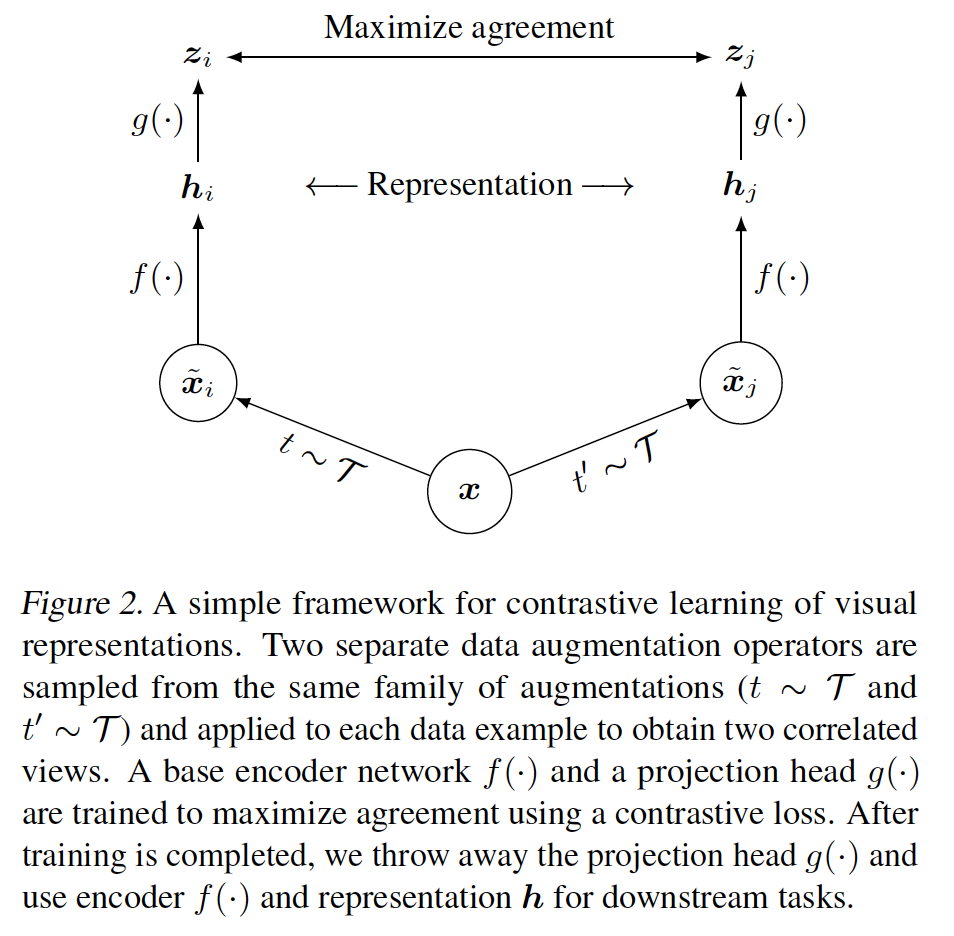
Figure 2는 이 전체 과정을 아주 잘 보여주는 그림입니다. 하나의 이미지 $x$에서 시작해서, 두 개의 서로 다른 데이터 증강(augmentation) $t$와 $t’$를 적용하여 두 개의 새로운 이미지 $\tilde{x}_i$와 $\tilde{x}_j$를 만듭니다. 이 둘은 서로 연관된 **‘긍정적 쌍’**이 됩니다. 이 두 이미지는 동일한 인코더 네트워크(encoder network) $f(\cdot)$를 통과하여 각각의 표현 벡터(representation vector) $h_i$와 $h_j$로 변환됩니다. 그 후, 이 표현 벡터들은 또 다른 작은 신경망인 투영 헤드(projection head) $g(\cdot)$를 거쳐 최종적으로 $z_i$와 $z_j$라는 벡터로 변환됩니다. 학습의 목표는 이 $z_i$와 $z_j$ 사이의 **유사도(agreement)**를 최대화하는 것입니다. 학습이 끝나면 투영 헤드 $g(\cdot)$는 버리고, 표현 벡터 $h$를 다른 작업(예: 이미지 분류)에 사용합니다.
데이터 증강 (Data Augmentation): 하나의 이미지로부터 두 개의 연관된 뷰(view)를 생성하는 과정입니다. 이 논문에서는 무작위 자르기 후 원래 크기로 복원(random cropping and resize), 색상 왜곡(color distortion), **가우시안 블러(Gaussian blur)**를 순차적으로 적용합니다. 어떤 증강 기법을 어떻게 조합하는지가 모델 성능의 핵심입니다.
기본 인코더 (Base Encoder): 증강된 이미지로부터 표현 벡터 $h_i$를 추출하는 신경망입니다. 이 논문에서는 주로 ResNet 구조를 사용하며, 특별한 구조적 제약이 없어 어떤 신경망이든 사용할 수 있습니다. $h_i = f(\tilde{x}_i)$ 입니다.
투영 헤드 (Projection Head): 인코더에서 나온 표현 벡터 $h$를 **대조 손실(contrastive loss)**을 계산하는 공간으로 매핑하는 작은 신경망 $g(\cdot)$입니다. 이 논문에서는 하나의 **은닉층(hidden layer)**을 가진 **MLP(Multi-Layer Perceptron)**를 사용합니다. $z_i = g(h_i)$ 이며, $h_i$가 아닌 $z_i$에 손실 함수를 적용하는 것이 성능 향상에 큰 도움이 된다는 것을 발견했습니다.
대조 손실 함수 (Contrastive Loss Function): 주어진 ‘긍정적 쌍’($z_i$, $z_j$)의 유사도는 높이고, 나머지 모든 ‘부정적 쌍’과의 유사도는 낮추도록 학습시키는 함수입니다. 이 논문에서는 NT-Xent (Normalized Temperature-scaled Cross Entropy) 손실을 사용합니다.
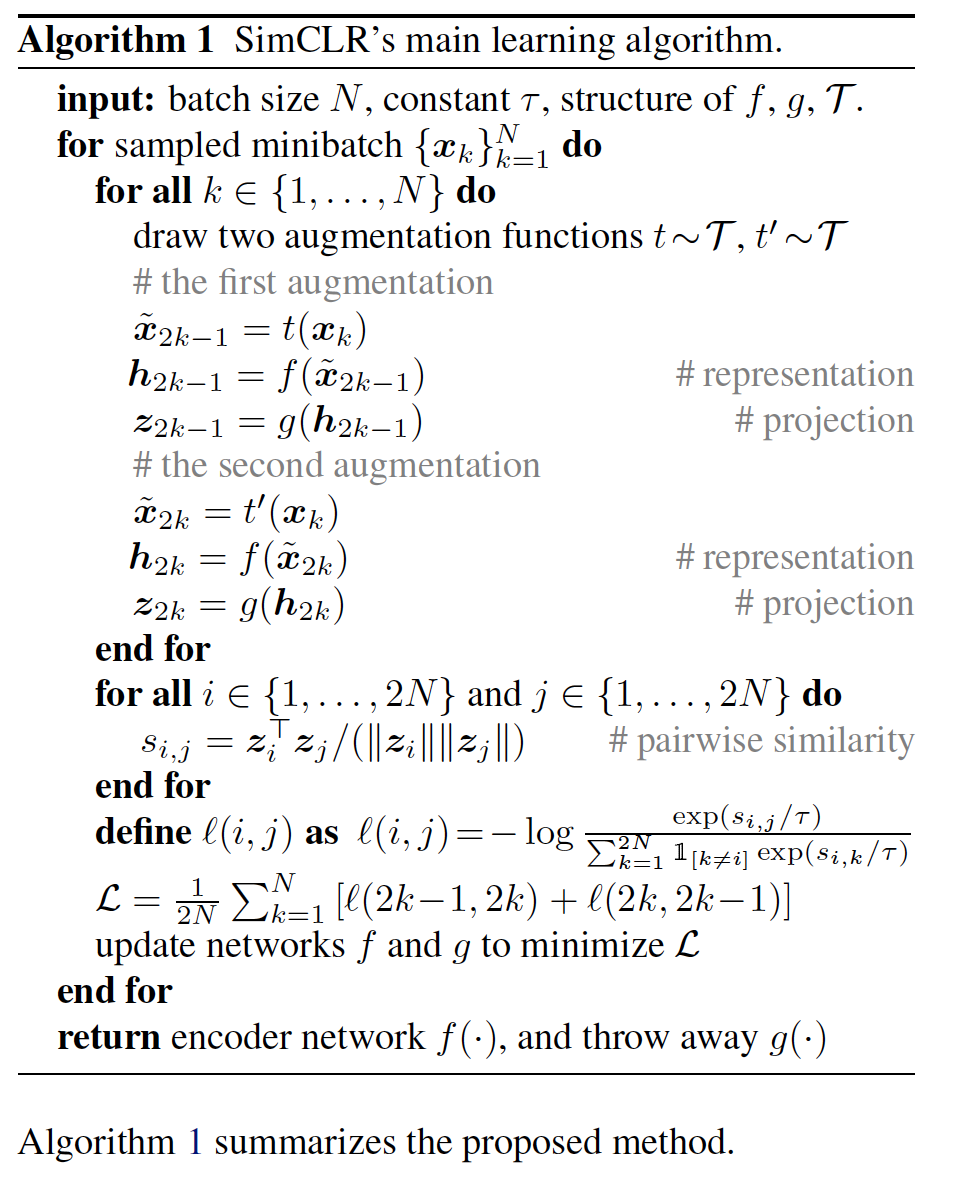 Algorithm 1은 이 SimCLR 학습 과정을 단계별로 요약한 것입니다.
N개의 이미지를 배치로 가져와 각 이미지마다 두 개의 증강된 뷰를 만들고, 인코더와 투영 헤드를 통과시켜 2N개의 $z$ 벡터를 얻습니다. 그런 다음 모든 벡터 쌍 간의 유사도($s_{i,j}$)를 계산하고, 이를 바탕으로 손실($l(i,j)$)을 계산하여 네트워크 $f$와 $g$를 업데이트합니다.
수식에 대해 좀 더 깊이 들어가 보겠습니다. NT-Xent 손실 함수는 다음과 같이 정의됩니다.
- $z_i$와 $z_j$는 각각 증강된 이미지 $\tilde{x}_i$와 $\tilde{x}_j$로부터 추출된 $l_2$ 정규화된(normalized) 표현 벡터입니다. 이 둘은 ‘긍정적 쌍’입니다.
- $\text{sim}(u, v) = u^T v / (||u|| ||v||)$는 두 벡터 간의 **코사인 유사도(cosine similarity)**를 계산합니다.
- $\tau$ (타우)는 온도(temperature) 하이퍼파라미터로, 유사도 분포를 얼마나 뾰족하게 만들지 조절합니다. $\tau$가 작을수록 모델은 어려운 부정적 예시(hard negatives, 즉 긍정적 예시와 유사도가 높은 부정적 예시)에 더 집중하게 됩니다. 이는 손실 함수의 기울기(gradient)에서 부정적 예시들에 대한 가중치를 조절하는 효과를 낳습니다.
- 분자 $\exp(\text{sim}(z_i, z_j)/\tau)$는 긍정적 쌍 간의 유사도를 지수적으로 증폭시킨 값입니다.
- 분모 $\sum_{k=1}^{2N} \mathbb{I}_{[k \neq i]} \exp(\text{sim}(z_i, z_k)/\tau)$는 $z_i$를 기준으로, 자기 자신을 제외한 배치 내의 모든 $2N-1$개의 다른 벡터(긍정적 쌍인 $z_j$ 1개와 부정적 쌍 $2N-2$개 포함)와의 유사도를 지수적으로 증폭시켜 합한 값입니다.
결론적으로 이 수식은 Softmax 함수의 형태를 띠며, 2N개의 벡터 중에서 $z_i$의 짝인 $z_j$를 올바르게 분류하는 다중 클래스 분류 문제로 볼 수 있습니다. 로그를 취하고 음수를 붙여, 정답(긍정적 쌍)의 확률을 최대화(손실을 최소화)하도록 합니다. 이것이 바로 Cross-Entropy 손실의 기본 원리입니다.
3. 실험 (Experiments)
SimCLR의 각 설계 요소가 성능에 어떤 영향을 미치는지 검증하기 위해 방대한 실험을 수행했습니다.
데이터 증강의 효과
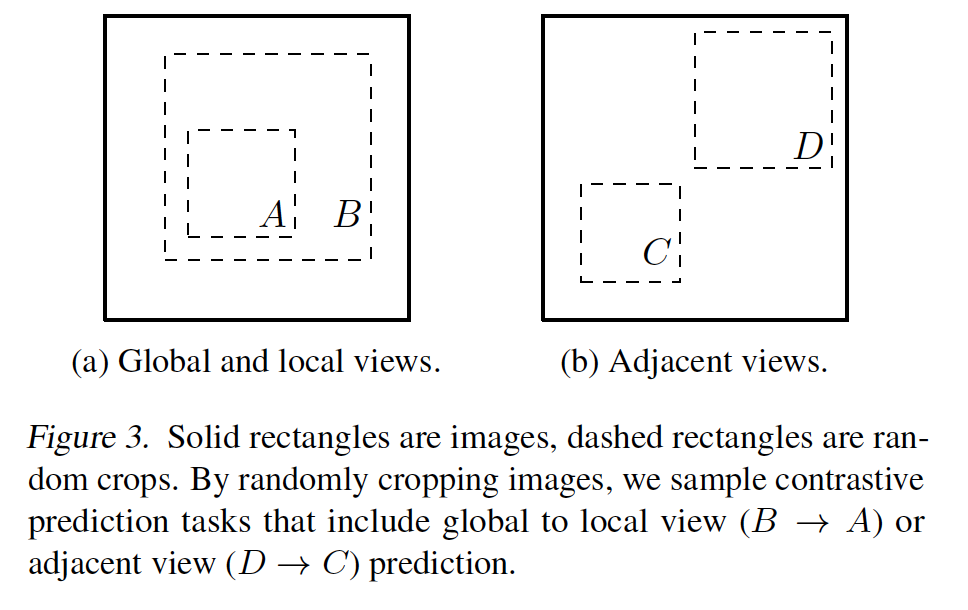
Figure 3은 **무작위 자르기(random cropping)**만으로도 이미지의 전체적인 모습을 보는 ‘global view’와 특정 부분을 보는 ’local view’ (B → A), 또는 인접한 부분을 보는 ‘adjacent view’ (D → C)를 예측하는 다양한 대조 학습 과제를 만들 수 있음을 보여줍니다.
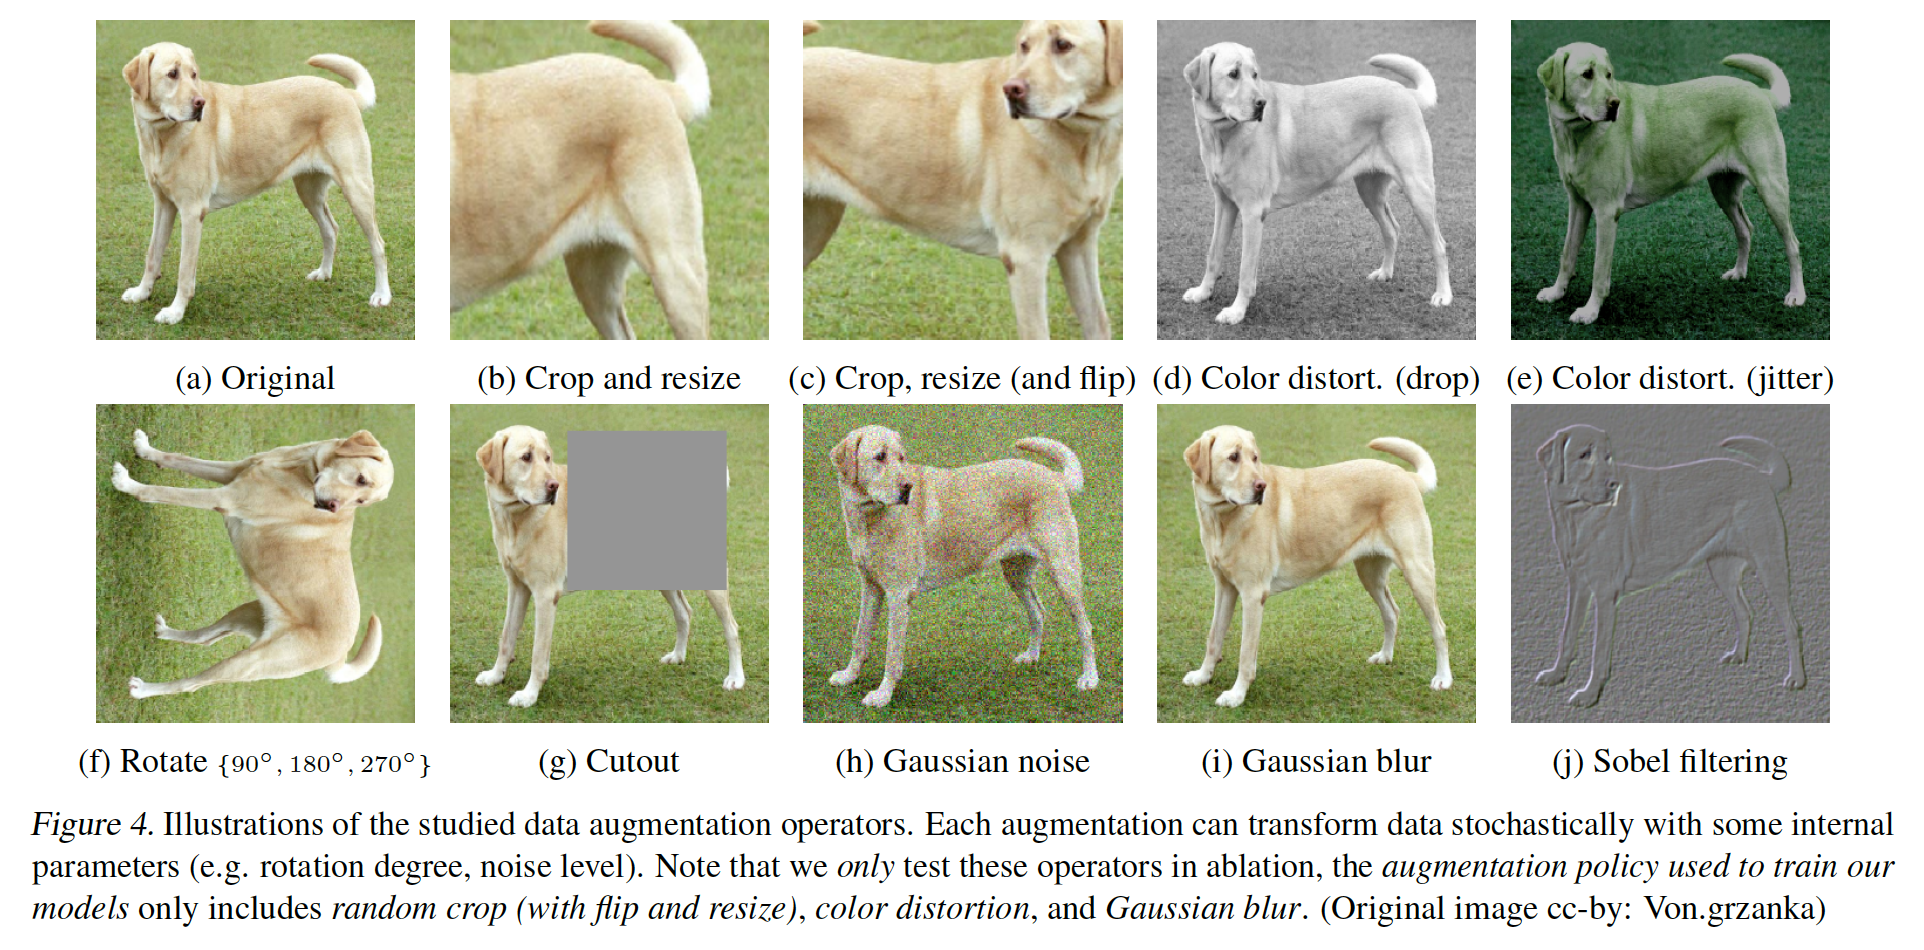
Figure 4는 실험에 사용된 다양한 데이터 증강 기법들을 시각적으로 보여줍니다. (a) 원본 이미지부터 시작해 자르기, 색상 왜곡, 회전, 노이즈, 블러 등 다양한 변환을 적용한 모습을 확인할 수 있습니다.
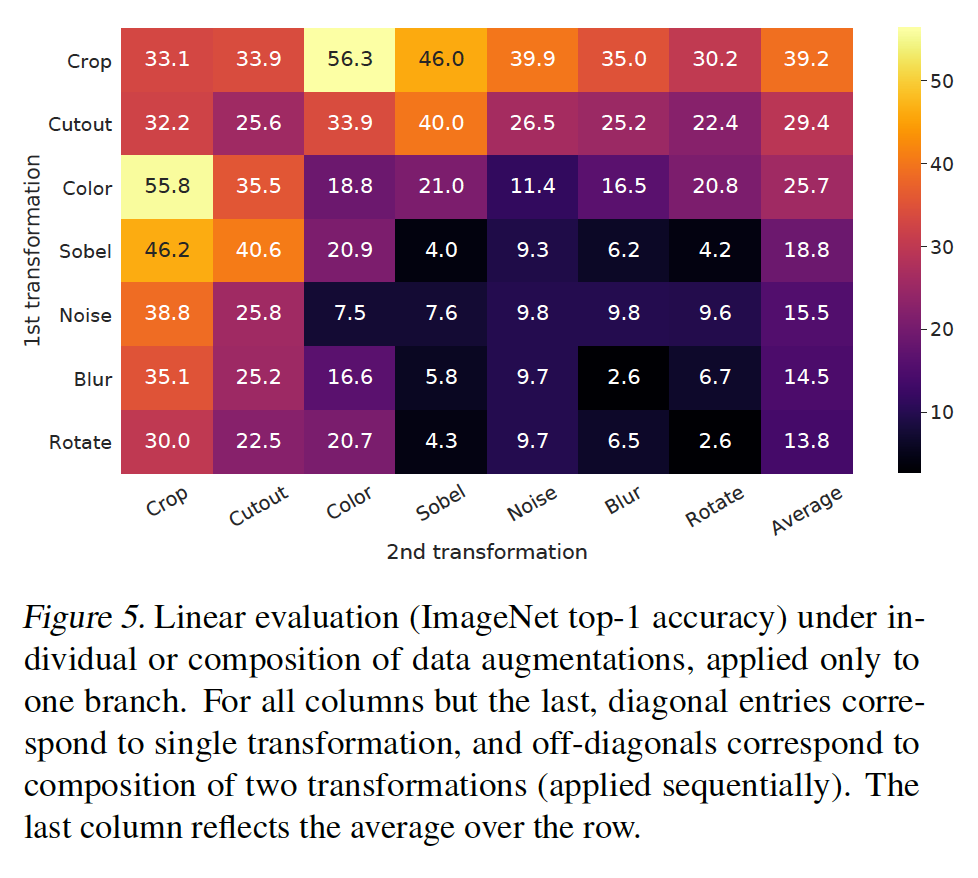
Figure 5는 이 증강 기법들의 조합 효과를 분석한 히트맵입니다. 대각선은 단일 변환의 성능, 비대각선은 두 변환 조합의 성능을 나타냅니다. 이 표에서 어떤 단일 변환도 좋은 성능을 내지 못하지만, 두 가지 변환을 조합했을 때(특히 ‘Crop’과 ‘Color’의 조합) 성능이 극적으로 향상됨을 알 수 있습니다.
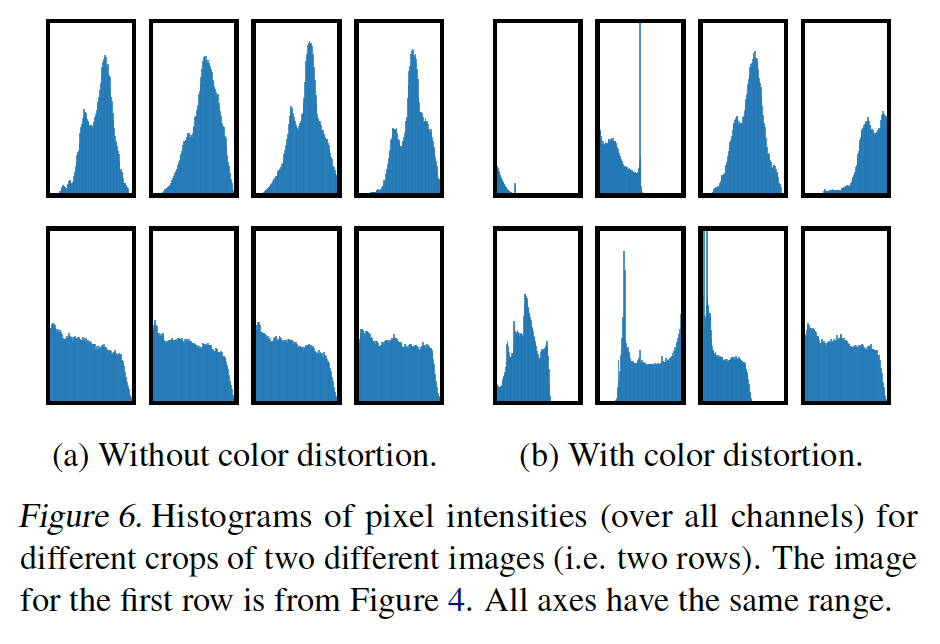
Figure 6은 왜 색상 왜곡이 중요한지 설명합니다. 색상 왜곡이 없으면(a), 같은 이미지에서 잘라낸 조각들은 비슷한 색상 분포(히스토그램)를 가집니다. 모델이 이 ‘쉬운 길’을 택해 색상만으로 정답을 맞히는 꼼수를 부릴 수 있습니다. 색상 왜곡을 추가하면(b), 이런 꼼수가 불가능해져 모델이 더 일반화 가능한 특징을 배우게 됩니다.
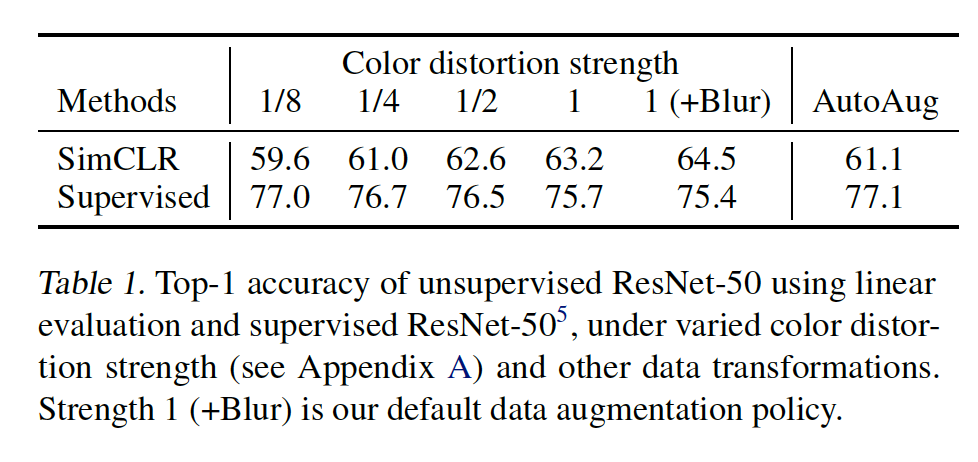 Table 1은 색상 증강의 강도에 따른 성능 변화를 보여줍니다. 자기 지도 학습(SimCLR)에서는 색상 증강을 강하게 할수록 성능이 향상되지만, 지도 학습에서는 오히려 성능이 저하되기도 합니다. 이는 자기 지도 학습이 지도 학습보다 더 강한 데이터 증강을 필요로 함을 의미합니다.
아키텍처의 영향
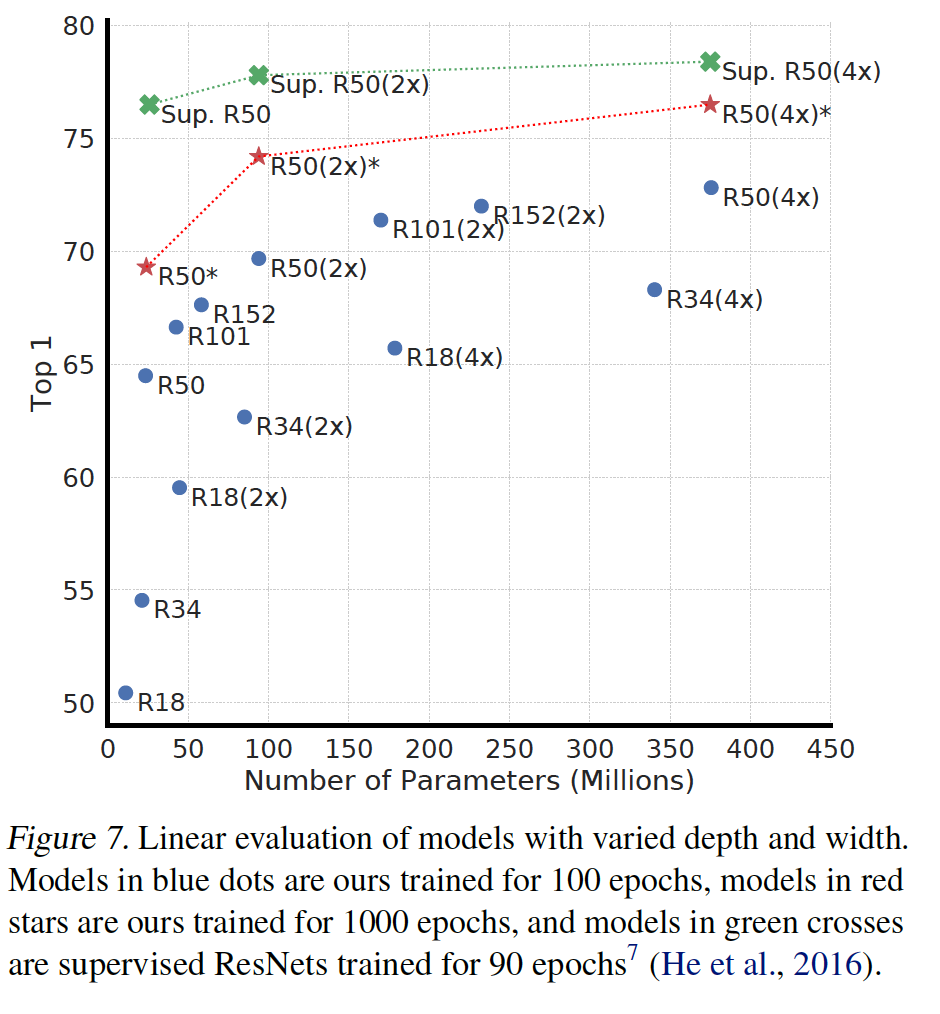
Figure 7은 모델의 깊이와 너비가 커질수록 성능이 향상됨을 보여줍니다. 흥미로운 점은 모델이 커질수록, 자기 지도 학습 모델(파란 점, 빨간 별)과 지도 학습 모델(녹색 십자가) 간의 성능 격차가 줄어든다는 것입니다. 이는 자기 지도 학습이 큰 모델로부터 더 많은 혜택을 본다는 것을 시사합니다.
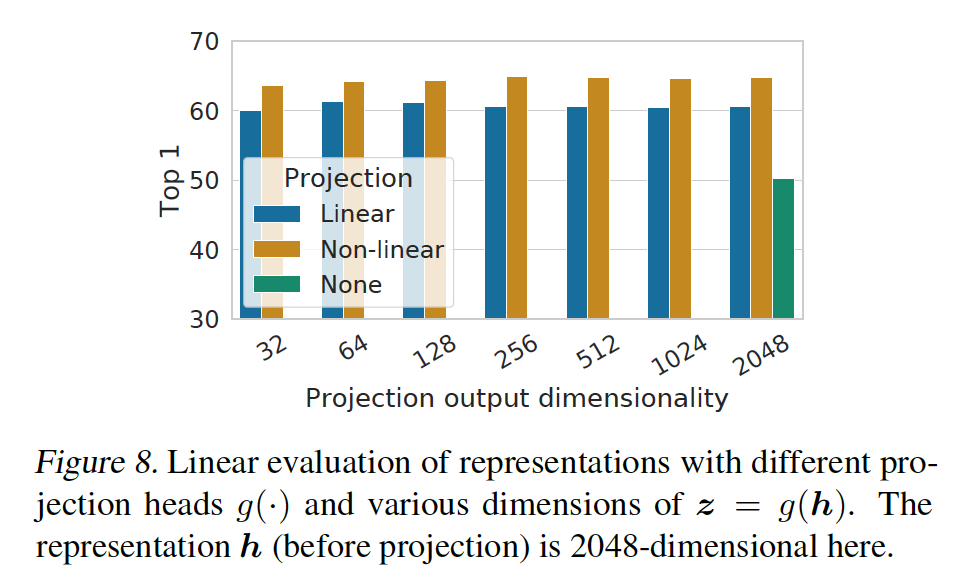
Figure 8은 **투영 헤드 $g(\cdot)$**의 구조에 따른 성능을 비교합니다. 비선형 MLP 헤드(‘Non-linear’)가 선형 헤드(‘Linear’)나 헤드가 없는 경우(‘None’)보다 월등히 좋은 성능을 보입니다.
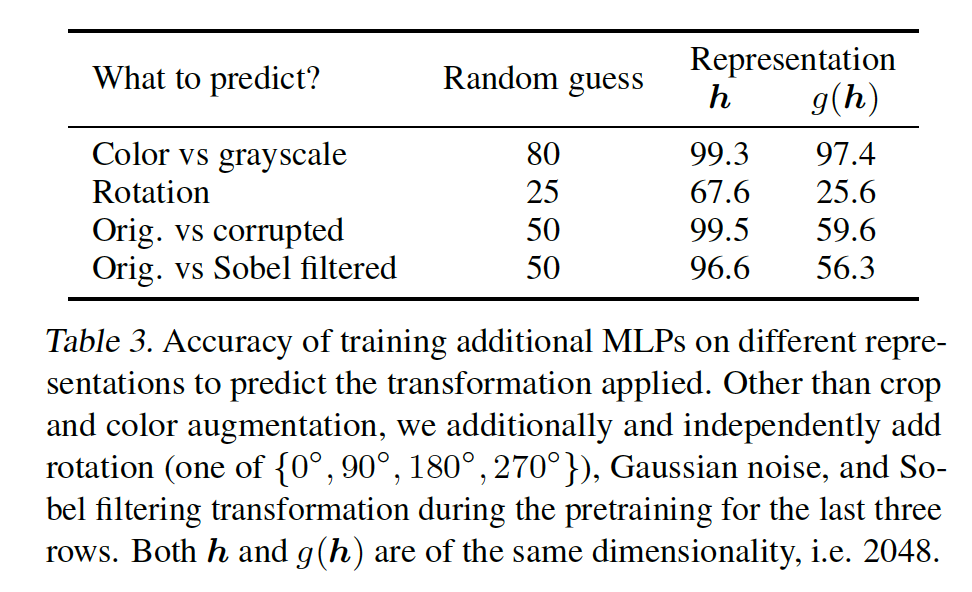 $h$와 $g(h)$가 어떤 증강(색상, 회전 등)이 적용되었는지 예측하는 실험을 했을 때, $h$가 훨씬 더 많은 정보를 담고 있는 것으로 나타났습니다. 즉, $g(h)$는 대조 학습 과제에 불필요한 정보(예: 색상, 방향)를 제거하는 역할을 하며, 이로 인해 그 이전 단계인 $h$에는 더 풍부한 정보가 보존되는 것입니다.
손실 함수와 배치 크기
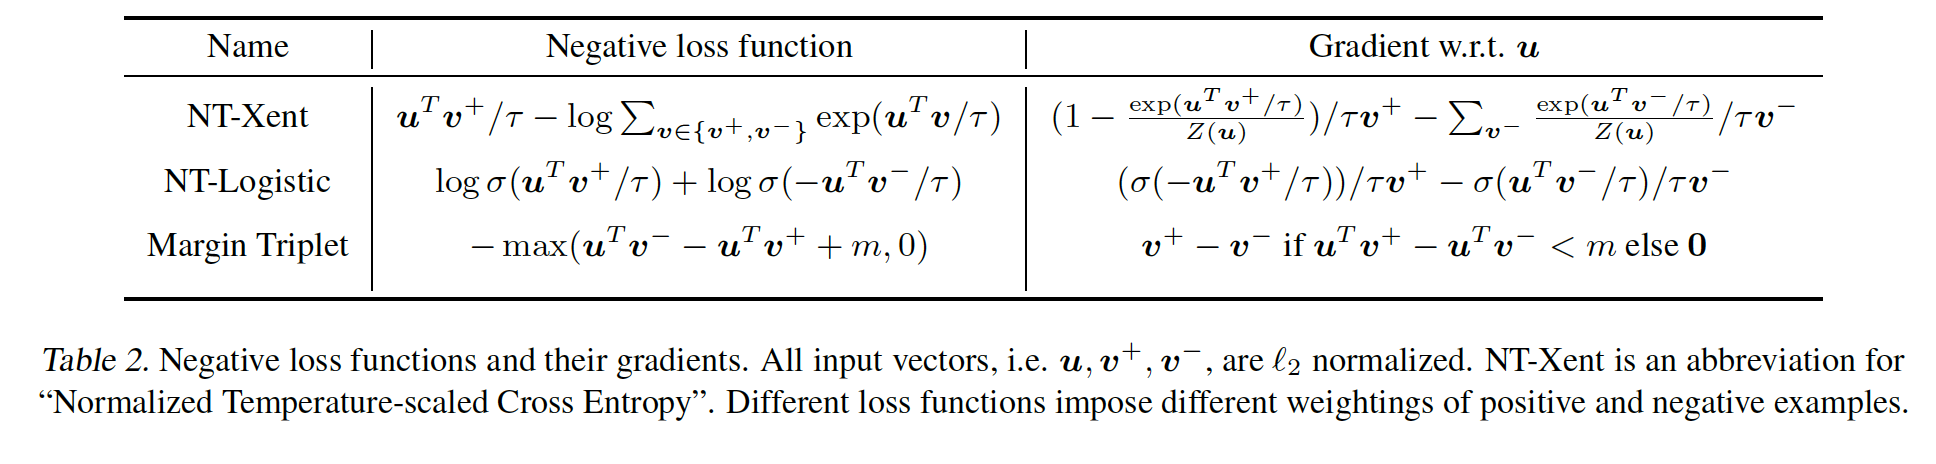 Table 2는 NT-Xent 손실 함수를 다른 대조 손실 함수들(NT-Logistic, Margin Triplet)과 수식 및 기울기 측면에서 비교합니다. NT-Xent는 온도 $\tau$와 $l_2$ 정규화를 통해 어려운 부정적 예시에 가중치를 두는 반면, 다른 손실 함수들은 그렇지 않다는 차이가 있습니다.
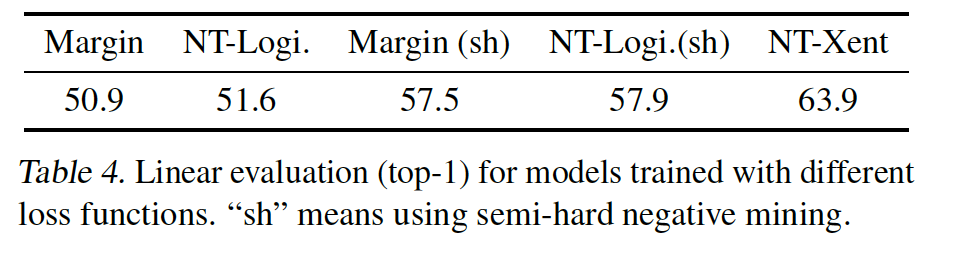 Table 4는 실제 성능 비교 결과로, NT-Xent가 다른 손실 함수들보다 훨씬 우수한 성능을 보임을 확인시켜 줍니다.
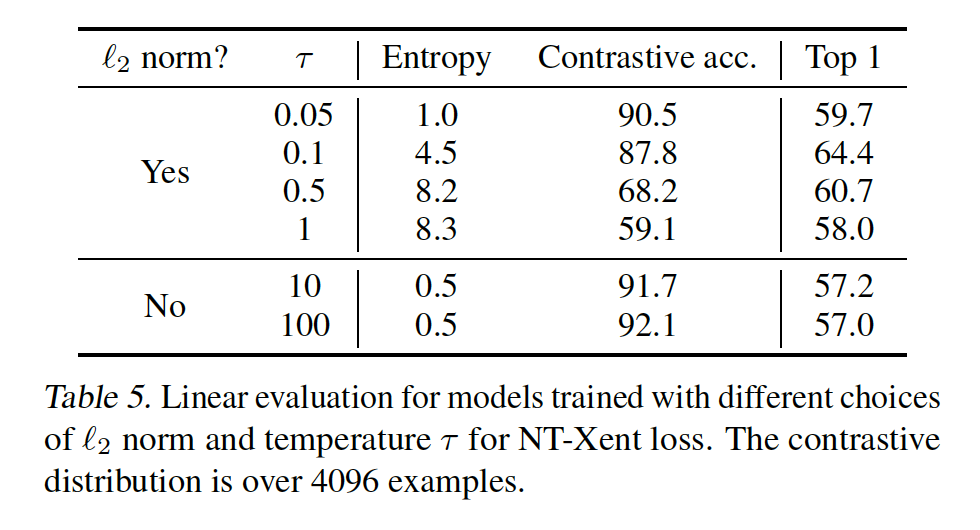 Table 5는 $l_2$ 정규화와 온도 $\tau$의 중요성을 보여줍니다. 정규화를 사용하지 않거나, 적절한 온도를 설정하지 않으면 성능이 크게 저하됩니다.
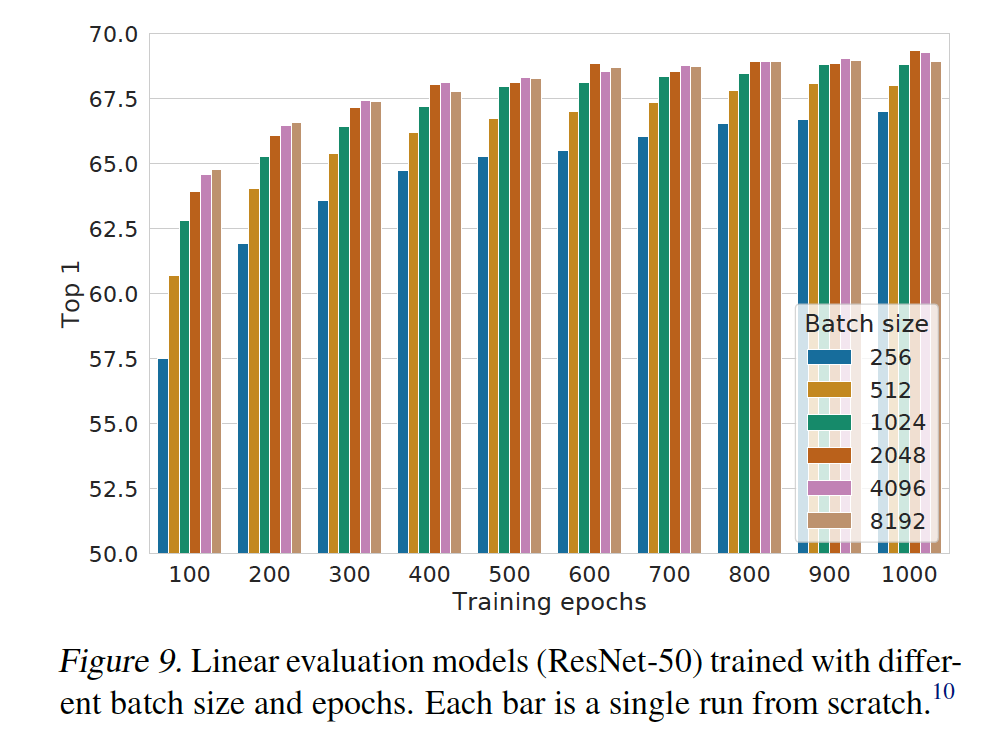
Figure 9는 배치 크기와 학습 에포크(epoch) 수에 따른 성능 변화를 보여줍니다. 학습 초기에는 배치 크기가 클수록 성능이 좋지만, 학습을 오래 진행할수록 그 차이가 줄어듭니다. 대조 학습에서는 큰 배치가 더 많은 부정적 예시를 제공하므로 수렴을 돕는 효과가 있습니다.
최신 기술과의 비교 (SOTA)
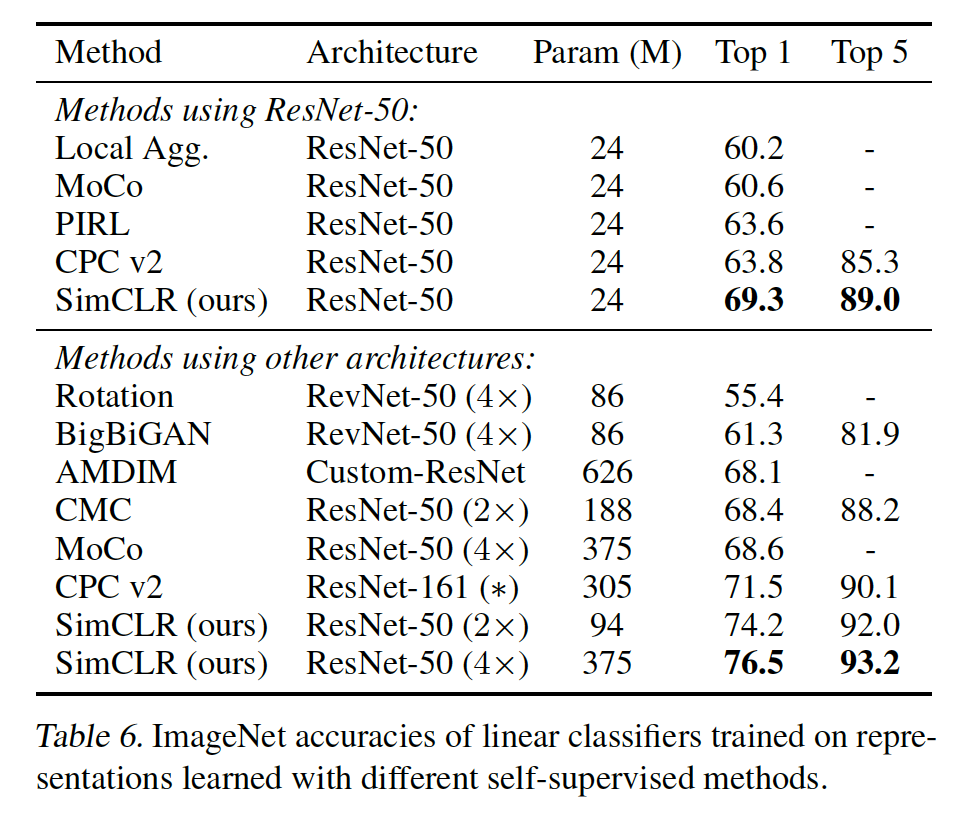 Table 6은 ImageNet 데이터셋에서의 선형 평가(linear evaluation) 결과를 다른 자기 지도 학습 모델들과 비교한 표입니다. SimCLR은 ResNet-50 (4x) 모델을 사용하여 76.5%의 Top-1 정확도를 달성, 이전 최고 성능을 크게 뛰어넘었으며 지도 학습 모델의 성능과 동등한 수준에 도달했습니다.
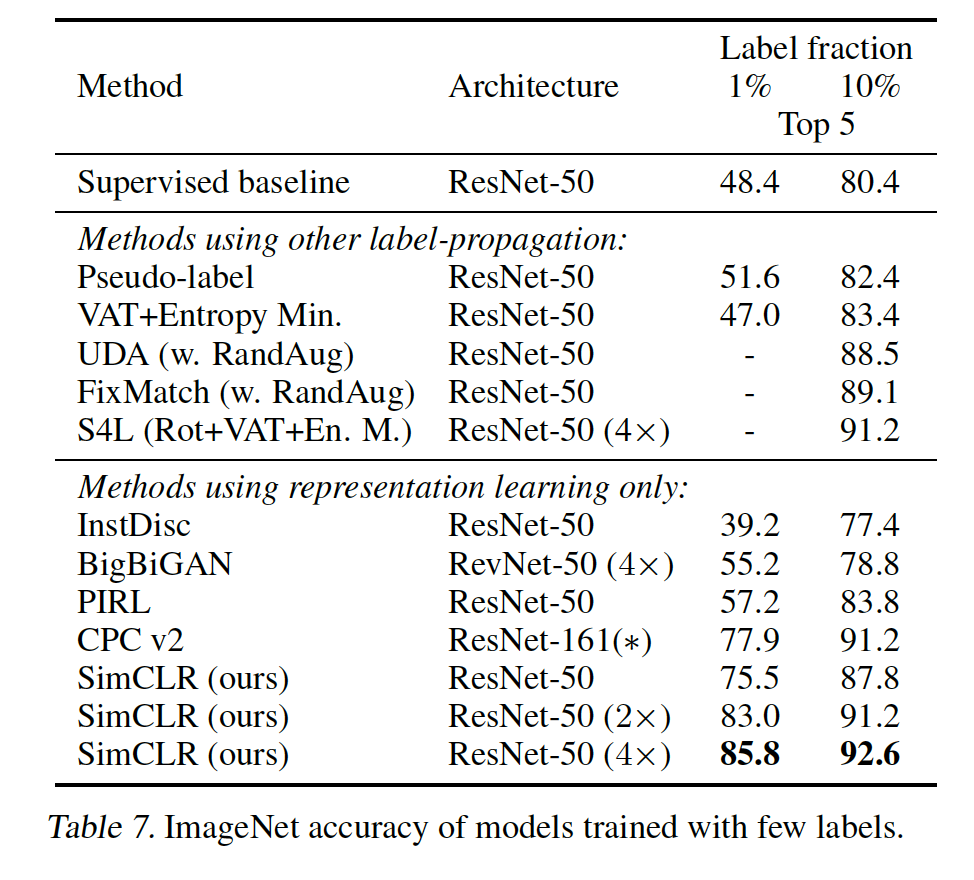 Table 7은 레이블이 적은 데이터(1% 또는 10%)로 모델을 **미세 조정(fine-tuning)**하는 준지도 학습(semi-supervised learning) 성능을 비교합니다. 여기서도 SimCLR은 다른 방법들을 큰 차이로 능가했습니다.
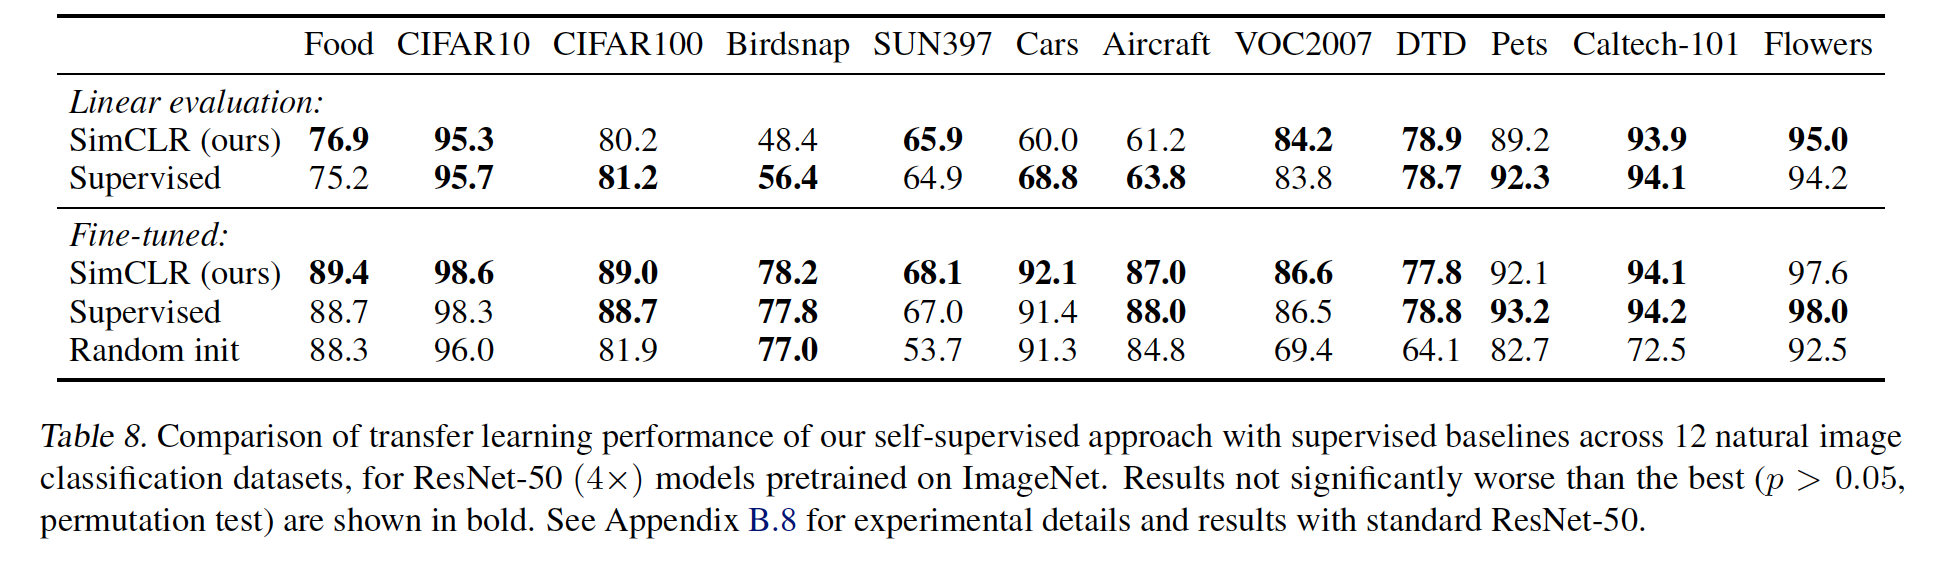 Table 8은 다른 12개의 다양한 이미지 데이터셋으로의 전이 학습(transfer learning) 성능을 보여줍니다. SimCLR로 사전 학습된 모델은 많은 데이터셋에서 지도 학습으로 사전 학습된 모델과 대등하거나 더 나은 성능을 보였습니다.
4. 결론 (Conclusion)
이 논문은 SimCLR이라는 매우 간단하면서도 강력한 대조 학습 프레임워크를 제시했습니다. SimCLR의 성공은 어느 하나의 새로운 발견이 아닌, 기존에 알려진 요소들을 체계적으로 연구하고 최적으로 조합한 결과입니다.
핵심적인 발견은 다음과 같습니다.
- 데이터 증강 기법의 강력한 조합(특히 무작위 자르기와 색상 왜곡)은 효과적인 표현 학습에 필수적이다.
- 인코더 뒤에 비선형 투영 헤드를 추가하고, 헤드를 통과하기 전의 표현을 사용하는 것이 성능을 크게 향상시킨다.
- **정규화된 Cross Entropy 손실 함수(NT-Xent)**와 적절한 온도 파라미터, 그리고 매우 큰 배치 크기에서의 학습이 매우 효과적이다.
SimCLR은 복잡한 구조나 메모리 뱅크 없이도 최첨단 성능을 달성함으로써, 자기 지도 학습의 잠재력이 여전히 과소평가되고 있음을 보여주었습니다. 이 연구는 이후의 수많은 자기 지도 학습 연구에 큰 영감을 주었습니다.