이 논문은 이미지 분할(Image Segmentation) 분야에 ‘파운데이션 모델(Foundation Model)’ 이라는 새로운 패러다임을 제시하는 “Segment Anything (SA)“를 소개합니다. 이미지 분할이란, 이미지 속 각 픽셀이 어떤 객체에 속하는지 구분하여 영역을 나누는 기술입니다. 예를 들어, 고양이 사진에서 픽셀 단위로 ‘여기는 고양이’, ‘여기는 배경’이라고 알려주는 것과 같습니다.
최근 자연어 처리(NLP) 분야에서는 GPT와 같이 웹 규모의 방대한 데이터로 사전 훈련된 **‘파운데이션 모델’**이 등장하여, 특정 작업에 대한 추가 훈련(fine-tuning) 없이도 ‘프롬프트(prompt)‘만으로 다양한 작업을 놀랍도록 잘 수행해내고 있습니다. 이 논문의 저자들은 이러한 성공에 영감을 받아, 이미지 분할 분야에도 적용할 수 있는 범용 모델을 만들고자 했습니다.
이를 위해 저자들은 다음 세 가지 핵심 요소를 새롭게 정의하고 개발했습니다.
- 새로운 과업(Task): 프롬프트 기반 분할 (Promptable Segmentation)
- 새로운 모델(Model): Segment Anything Model (SAM)
- 새로운 데이터셋(Data): Segment Anything 1-Billion (SA-1B)
이 세 가지는 서로 맞물려 돌아가는 톱니바퀴처럼 작용합니다. 좋은 모델(SAM)을 만들기 위해 방대한 데이터(SA-1B)가 필요하고, 이 데이터를 효율적으로 구축하기 위해 좋은 모델(SAM)을 ‘데이터 엔진’으로 활용했으며, 이 모든 것을 가능하게 하는 것이 바로 프롬프트 기반 분할입니다.
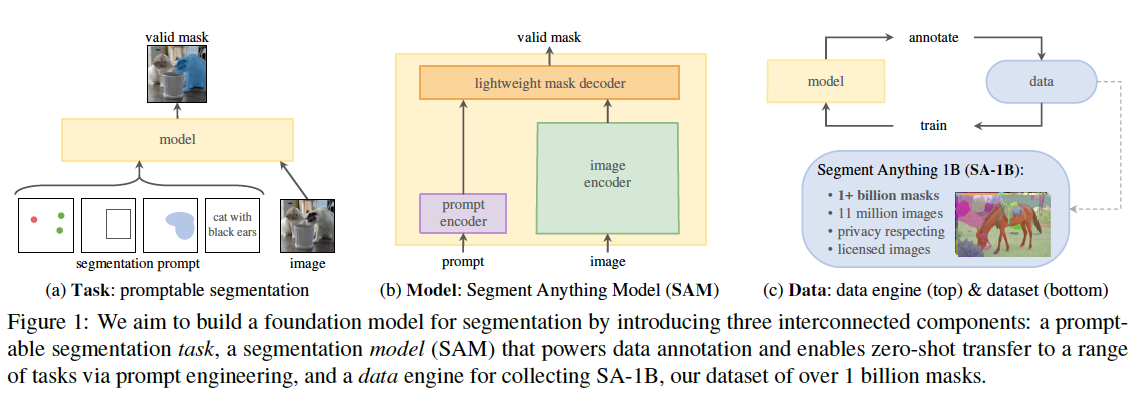
(a) 과업: 이 그림은 ‘프롬프트 기반 분할’이라는 새로운 task를 보여줍니다. 사용자가 이미지 위에 점을 찍거나(points), 네모 박스를 그리거나(box), 심지어 “검은 귀를 가진 고양이"처럼 텍스트(text)로 프롬프트를 주면, 모델이 그에 해당하는 객체의 마스크(mask)를 출력합니다.
(b) 모델: 이것이 바로 SAM(Segment Anything Model)의 구조입니다. 이미지를 분석하는 무거운 ‘이미지 인코더’, 사용자의 프롬프트를 이해하는 ‘프롬프트 인코더’, 그리고 이 둘을 합쳐 최종 마스크를 빠르게 만들어내는 가벼운 ‘마스크 디코더’로 구성됩니다.
(c) 데이터: 거대한 SA-1B 데이터셋을 구축하기 위한 ‘데이터 엔진’을 보여줍니다. 모델을 이용해 데이터 주석 작업을 돕고(annotate), 그 데이터로 모델을 다시 학습시키는(train) 과정을 반복하여 11억 개가 넘는 마스크 데이터를 구축했습니다.
기술 설명
1. 과업: 프롬프트 기반 분할 (Promptable Segmentation)
기존의 분할 모델들은 ‘고양이만 찾아내라’ 또는 ‘사람과 자동차만 구분해라’와 같이 정해진 종류의 객체만 분할할 수 있었습니다. 하지만 이 논문에서 제안하는 프롬프트 기반 분할은 “어떤 프롬프트가 주어지든 그에 해당하는 유효한 분할 마스크를 반환"하는 것을 목표로 합니다.
여기서 ‘유효한(valid)’ 마스크라는 점이 중요합니다. 예를 들어, 파란 셔츠를 입은 사람의 사진에서 셔츠 부분에 점 하나를 프롬프트로 찍었다고 가정해봅시다. 이 점은 ‘파란 셔츠’를 의미할 수도 있고, ‘셔츠를 입고 있는 사람 전체’를 의미할 수도 있습니다. 이렇게 프롬프트가 모호할 경우, 모델은 셔츠 마스크와 사람 마스크 둘 중 하나 이상의 합리적인 마스크를 출력해야 합니다.
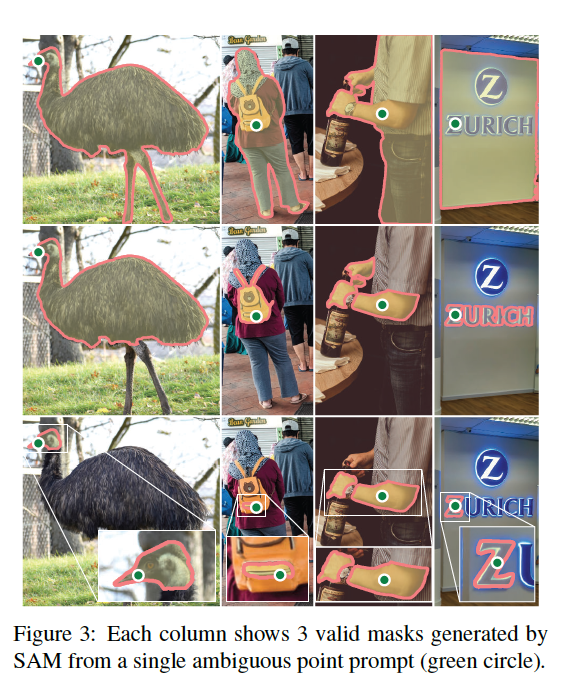
이 그림은 SAM이 어떻게 모호성을 처리하는지 잘 보여줍니다. 각 열은 하나의 이미지에 대한 결과입니다. 초록색 점(green circle)이라는 단 하나의 모호한 프롬프트가 주어졌을 때, SAM은 세 개의 서로 다른 유효한 마스크를 생성합니다. 예를 들어 첫 번째 열의 타조 이미지에서 목 부분에 점을 찍자, SAM은 타조의 머리, 목, 그리고 몸 전체에 해당하는 세 가지 마스크를 모두 제시합니다. 이를 통해 사용자는 자신이 원하는 결과를 선택할 수 있습니다.
2. 모델: SAM (Segment Anything Model)
SAM은 프롬프트 기반 분할 테스크를 실시간으로 수행하기 위해 매우 효율적인 구조로 설계되었습니다.
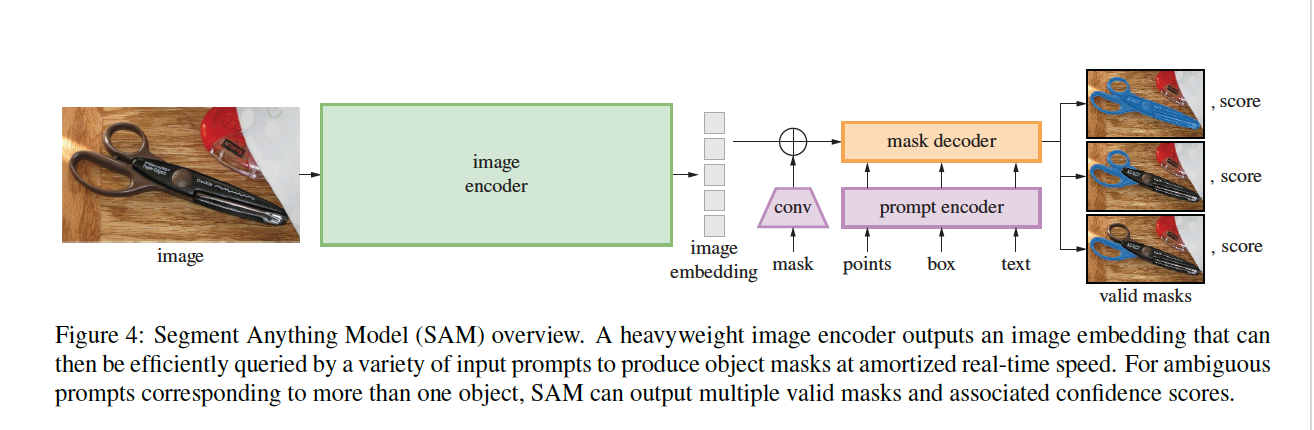
이미지 인코더 (Image Encoder): 무거운 Vision Transformer(ViT) 기반의 인코더로, 입력된 이미지 전체를 한 번만 처리하여 고차원의 ‘이미지 임베딩(image embedding)‘을 생성합니다. 이 과정은 계산량이 많지만, 이미지당 한 번만 수행하면 되므로 여러 프롬프트를 처리할 때 비용을 절약할 수 있습니다.
프롬프트 인코더 (Prompt Encoder): 점, 상자, 텍스트, 마스크 등 다양한 형태의 프롬프트를 이미지 임베딩과 결합할 수 있는 벡터 형태로 변환합니다. 예를 들어, 점이나 상자는 위치 정보를 담은 인코딩을 사용하고, 텍스트는 CLIP과 같은 언어 모델의 인코더를 활용합니다.
마스크 디코더 (Mask Decoder): 이미지 임베딩과 프롬프트 임베딩을 입력받아 최종 마스크를 출력하는 가볍고 빠른 모듈입니다. 이 디코더는 웹 브라우저에서도 약 50ms 만에 작동할 정도로 매우 효율적이어서, 사용자가 프롬프트를 바꾸는 대로 실시간으로 결과를 보여주는 상호작용이 가능합니다. 또한, 모호한 프롬프트에 대응하기 위해 3개의 마스크와 각 마스크의 신뢰도 점수(예상 IoU)를 함께 출력합니다.
모델 학습에는 Focal Loss와 Dice Loss를 결합한 손실 함수가 사용되었습니다.
이 논문에서 사용된 손실 함수는 $L = \alpha L_{focal} + \beta L_{dice}$ 형태로 표현할 수 있습니다.
Focal Loss ($L_{focal}$): 주로 객체 탐지에서 클래스 불균형 문제를 해결하기 위해 제안된 손실 함수입니다. 일반적인 Cross-Entropy 손실 함수에 $(1-p_t)^\gamma$ 항을 추가하여, 모델이 이미 잘 맞추는 쉬운 샘플(예: 배경 픽셀)에는 적은 가중치를 부여하고, 맞추기 어려운 어려운 샘플(예: 객체의 경계 픽셀)에 집중하도록 만듭니다. 이를 통해 경계가 명확한 마스크를 학습하는 데 도움을 줍니다.
Dice Loss ($L_{dice}$): 예측 마스크와 실제 마스크 간의 겹치는 영역(Intersection over Union, IoU)을 직접적으로 최대화하도록 설계된 손실 함수입니다. Dice 계수 $D = \frac{2|A \cap B|}{|A| + |B|}$를 기반으로 하며, 손실 함수는 $L_{dice} = 1 - D$로 정의됩니다. 이 손실 함수는 분할 영역의 크기에 덜 민감하고, 심한 불균형 상황에서도 안정적인 학습을 돕습니다.
이 두 손실 함수를 결합함으로써, 픽셀 단위의 정확성(Focal Loss)과 영역 단위의 유사성(Dice Loss)을 모두 고려하여 고품질의 마스크를 생성하도록 모델을 훈련시킵니다.
3. 데이터 엔진 및 SA-1B 데이터셋
고품질의 파운데이션 모델을 훈련시키기 위해서는 방대하고 다양한 데이터가 필수적이지만, 이미지 분할 분야에는 웹에서 바로 수집할 수 있는 대규모 데이터가 존재하지 않았습니다. 이 문제를 해결하기 위해 저자들은 ‘데이터 엔진(Data Engine)’ 이라는 독창적인 방법을 고안했습니다.
데이터 엔진은 3단계로 진행되었습니다.
- 보조-수동 단계 (Assisted-manual): 초기 SAM 모델을 이용해 전문 작업자가 대화형으로 마스크를 생성합니다. 모델이 대략적인 마스크를 제안하면, 작업자는 클릭 몇 번으로 수정하여 빠르고 정확하게 데이터를 만듭니다.
- 반자동 단계 (Semi-automatic): 모델이 발전함에 따라, 이제 모델이 이미지에서 확실한 객체들을 먼저 자동으로 찾아냅니다. 작업자는 모델이 놓친, 더 작거나 까다로운 객체들에 집중하여 마스크를 추가함으로써 데이터의 다양성을 높입니다.
- 완전 자동 단계 (Fully automatic): 최종 단계에서는 모델이 충분히 똑똑해져서 사람의 개입 없이도 고품질의 마스크를 대량으로 생성할 수 있게 됩니다. 저자들은 이미지에 $32 \times 32$ 격자 형태의 점 프롬프트를 자동으로 입력하고, 모호성 처리 기능을 활용하여 이미지 당 평균 100여 개의 마스크를 자동으로 생성했습니다.
이제부터 각 데이터 엔진 단계별로 실제 예시 상황과 과정을 구체적으로 살펴보겠습니다.
1. 보조-수동 단계 (Assisted-manual)
이 단계는 똑똑한 보조 도구를 활용해 사람이 수동으로 데이터를 만드는 과정입니다.
- 예시 상황: 전문 작업자에게 공원에 있는 강아지 사진 한 장이 주어졌습니다.
- 작업 방식:
- 작업자는 수작업으로 강아지 외곽선을 그리는 대신, 강아지 몸통 중앙에 점(point) 하나를 클릭합니다.
- 초기 SAM 모델이 즉시 그 점을 기반으로 “이것이 강아지인 것 같다"고 추측하며 대략적인 강아지 마스크를 생성해 보여줍니다. 이 마스크는 꼬리가 잘려있고, 배경의 풀 일부가 포함되어 있을 수 있습니다.
- 작업자는 모델의 예측을 수정하기 위해 잘린 꼬리 부분에 점을 하나 더 클릭하고(여기도 포함해줘!), 잘못 포함된 풀 부분에 점을 클릭합니다(여기는 빼줘!).
- 클릭할 때마다 SAM은 실시간으로 마스크를 업데이트하고, 몇 번의 클릭만으로 픽셀 수준까지 정확한 강아지 마스크가 완성됩니다.
- 결과: 이 방식을 통해 처음부터 손으로 그리는 것보다 6.5배 빠르게 고품질 마스크 데이터를 수집할 수 있었습니다. 이 단계에서 수집된 데이터로 SAM 모델을 반복적으로 재학습시켜 성능을 점차 향상시켰습니다.
2. 반자동 단계 (Semi-automatic)
1단계를 거쳐 똑똑해진 모델이 먼저 쉬운 작업을 처리하고, 사람은 더 어려운 작업에 집중하는 협업 단계입니다.
- 예시 상황: 작업자에게 다양한 물건이 있는 책상 사진이 주어졌습니다.
- 작업 방식:
- 작업자가 이미지를 열면, 1단계 데이터로 학습되어 더 강력해진 SAM이 이미지를 먼저 분석합니다.
- 모델은 자신이 90% 이상 확신하는 명확한 객체(예: 모니터, 키보드, 마우스)들의 마스크를 미리 자동으로 생성해 놓습니다. 🤖
- 작업자는 이미 생성된 마스크들을 검토하고, 모델이 놓친 더 작거나 복잡하고 애매한 객체(예: 엉켜있는 케이블, 펜, 책상 뒤편의 작은 화분)에만 집중하여 마스크를 추가합니다.
- 결과: 이 단계의 목표는 데이터의 다양성을 높이는 것입니다. 모델이 쉬운 것만 학습하지 않도록, 사람이 까다로운 객체 데이터를 보충해 줌으로써 모델이 “어떤 것이든(Anything)” 분할할 수 있는 능력을 키우게 됩니다.
3. 완전 자동 단계 (Fully automatic)
최종 단계에서는 사람의 개입 없이, 가장 강력해진 SAM 모델이 스스로 모든 데이터를 생성합니다.
- 예시 상황: 모델에게 수많은 과일이 진열된 시장 사진이 주어졌습니다.
- 작업 방식:
- 시스템이 이미지 전체에 32x32 간격의 촘촘한 격자(grid) 점 프롬프트를 자동으로 입력합니다.
- SAM은 각 점에 대해 모호성 처리 기능을 최대한 활용합니다. 예를 들어, 포도송이의 포도알 하나에 점이 찍혔다면, 모델은 다음과 같이 여러 개의 유효한 마스크를 동시에 생성합니다.
- 마스크 1: 포도알 하나
- 마스크 2: 포도알이 속한 포도송이 전체
- 마스크 3: 포도송이가 놓인 과일 상자 전체
- 이렇게 생성된 수많은 마스크들 중에서, 모델이 스스로 예측한 신뢰도 점수(IoU)가 높고 안정적인 마스크만 남기고 나머지는 필터링합니다.
- 결과: 이 자동화된 과정을 통해 이미지 한 장당 평균 100여 개의 고품질 마스크를 사람의 도움 없이 대량으로 얻을 수 있었고, 최종적으로 11억 개 이상의 마스크로 구성된 SA-1B 데이터셋을 구축할 수 있었습니다.
이 과정을 통해 탄생한 것이 바로 SA-1B 데이터셋입니다. 이 데이터셋은 1100만 개의 고해상도 이미지와 총 11억 개가 넘는 분할 마스크로 구성되어 있으며, 이는 기존에 가장 컸던 분할 데이터셋보다 마스크 수 기준으로 400배 이상 많은 규모입니다.
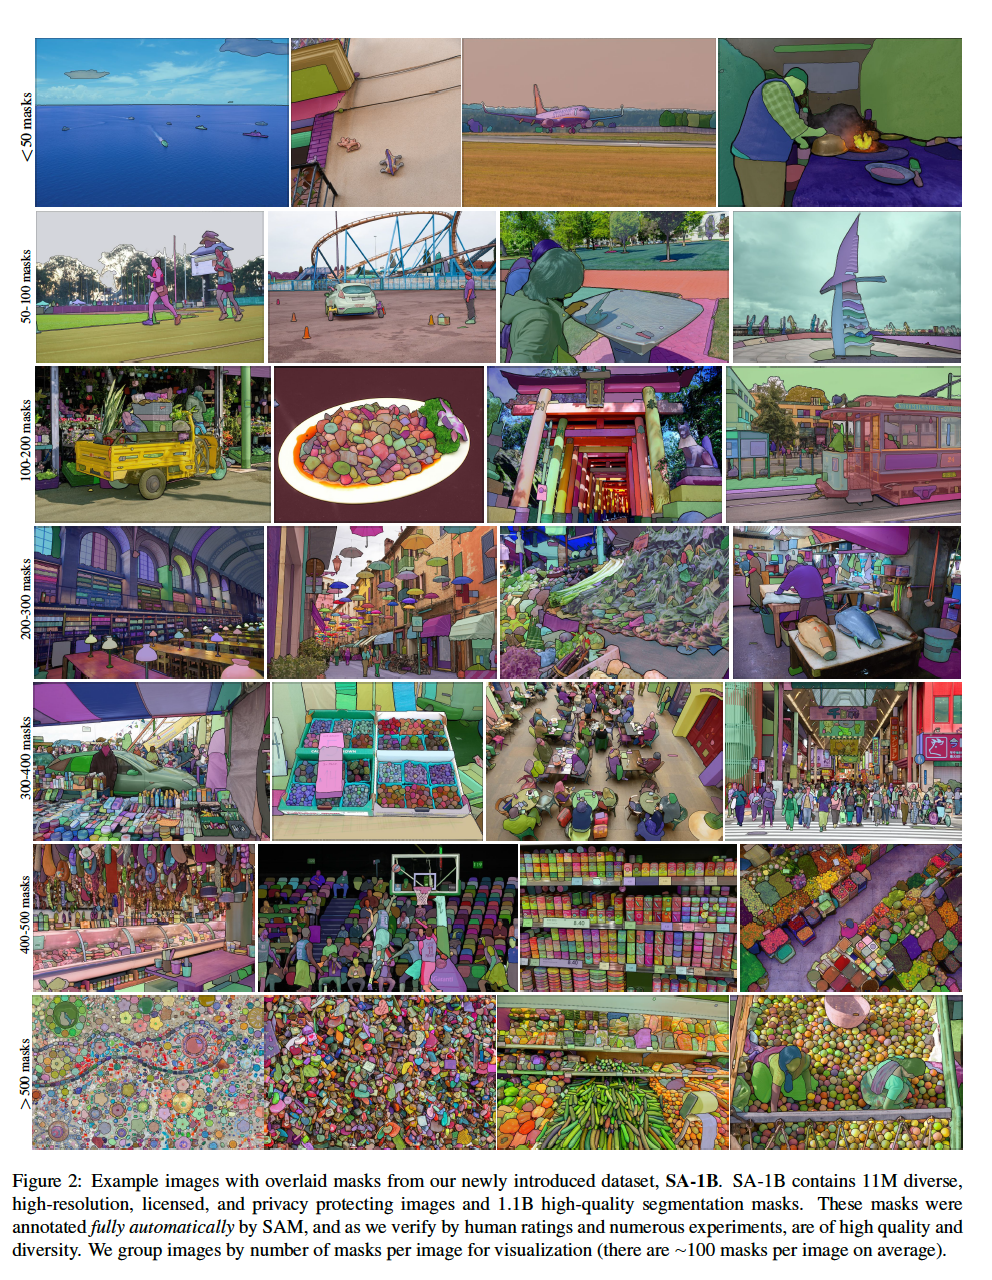
이 그림은 SA-1B 데이터셋에 포함된 다양한 이미지와 그 위에 오버레이된 마스크들을 보여줍니다. 위쪽으로 갈수록 이미지 당 마스크 수가 적고(<50개), 아래로 갈수록 마스크 수가 많은(>500개) 이미지들입니다. 이를 통해 데이터셋이 단순한 이미지부터 매우 복잡하고 객체가 많은 이미지까지 폭넓게 포함하고 있음을 알 수 있습니다.
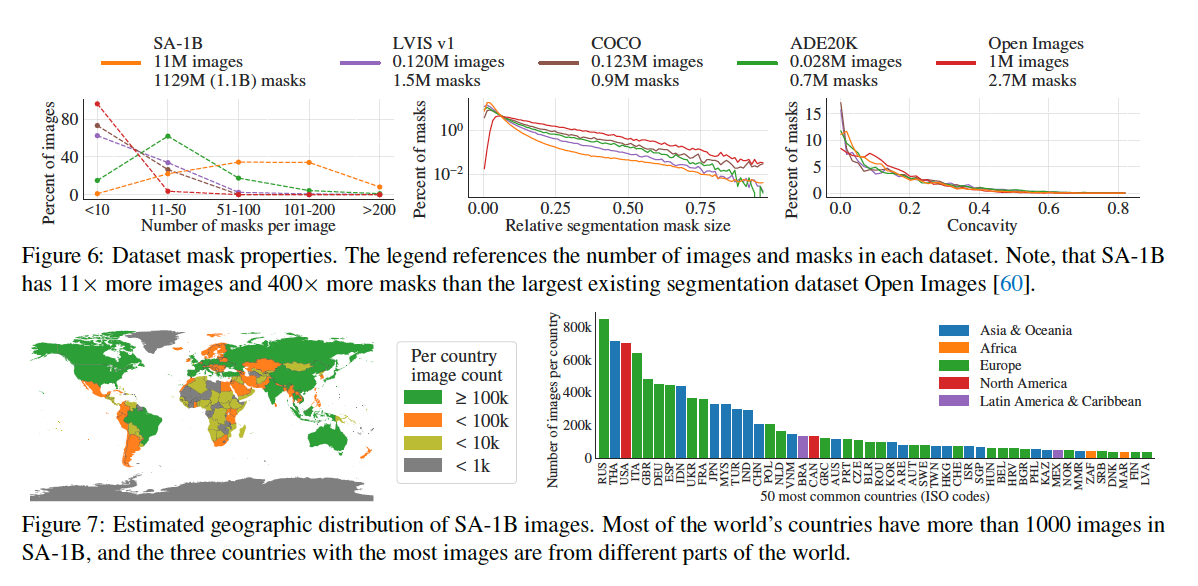
Figure 6은 SA-1B 데이터셋의 마스크 특성을 다른 주요 데이터셋(LVIS, COCO 등)과 비교합니다. SA-1B는 이미지당 마스크 수가 압도적으로 많고(왼쪽 그래프), 이로 인해 상대적으로 작거나 중간 크기의 마스크 비율이 높습니다(중간 그래프).
Figure 7은 데이터셋에 포함된 이미지들의 추정된 지리적 분포를 보여줍니다. 기존 데이터셋들이 북미나 특정 지역에 편중된 경향이 있었던 반면, SA-1B는 아시아, 유럽 등 훨씬 더 다양한 국가의 이미지를 포함하여 지리적 다양성을 확보했습니다.
실험 (Experiments)
저자들은 SAM이 훈련 데이터에서 보지 못한 새로운 종류의 이미지나 작업에 대해서도 얼마나 잘 작동하는지, 즉 제로샷 전이(Zero-shot Transfer) 성능을 평가하기 위해 다양한 실험을 진행했습니다.
1. 단일 점 기반 마스크 생성 평가
가장 핵심적인 실험으로, 이미지에 단 하나의 점을 프롬프트로 주었을 때 얼마나 유효한 마스크를 생성하는지 평가했습니다.
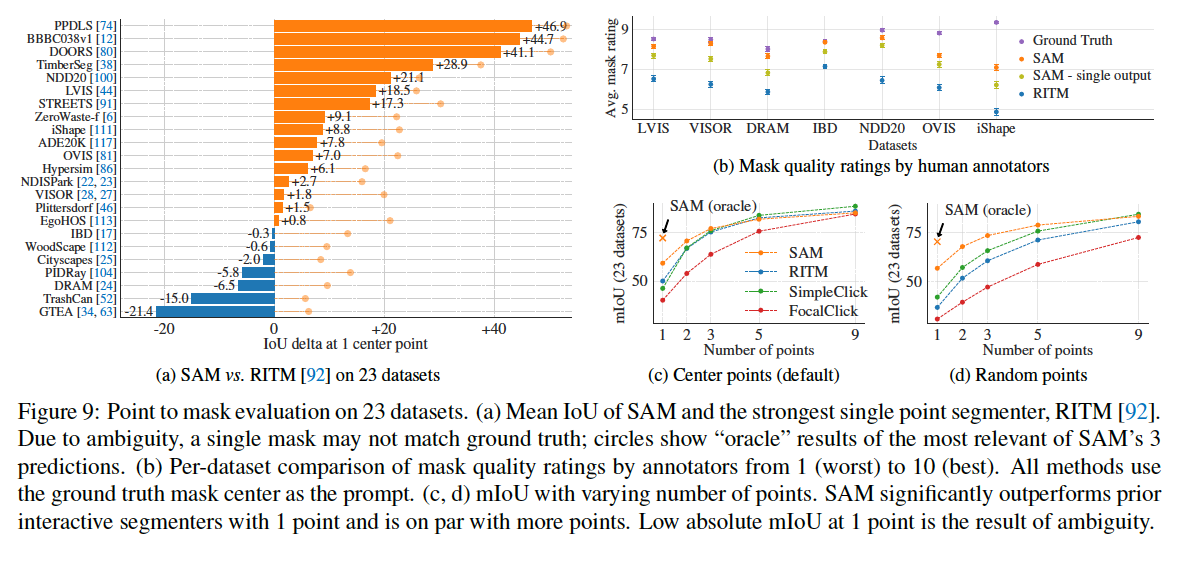
(a) 자동 평가(mIoU): 23개의 다양한 데이터셋에서 기존 최강의 대화형 분할 모델인 RITM과 성능을 비교했습니다. SAM은 23개 중 16개 데이터셋에서 더 높은 성능(IoU)을 보였습니다. 특히 ‘SAM (oracle)‘은 SAM이 출력한 3개의 마스크 중 정답과 가장 가까운 것을 선택했을 때의 성능인데, 이 경우 모든 데이터셋에서 RITM을 압도했습니다. 이는 단일 점 프롬프트가 모호하기 때문에, 자동 평가 지표만으로는 모델의 실제 성능을 제대로 측정하기 어렵다는 것을 보여줍니다.
(b) 사람 평가: 전문 작업자가 직접 마스크의 품질을 1~10점으로 평가한 결과입니다. 모든 데이터셋에서 사람들은 SAM이 생성한 마스크의 품질이 RITM보다 월등히 높다고 평가했습니다. 이는 SAM이 IoU 점수로는 측정되지 않는, 시각적으로 더 자연스럽고 정확한 마스크를 생성한다는 것을 의미합니다.
2. 제로샷 엣지 검출, 객체 제안 및 인스턴스 분할
SAM은 분할 모델이지만, 그 능력을 응용하여 다른 컴퓨터 비전 작업에도 제로샷으로 적용했습니다.
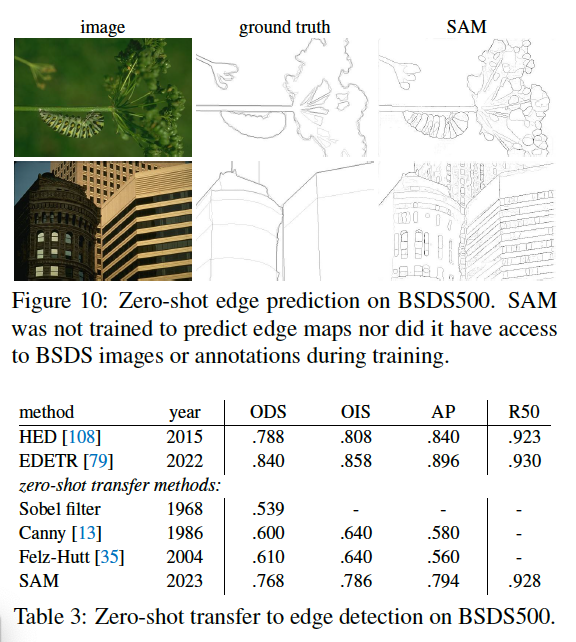
SAM이 생성한 여러 마스크들의 경계를 종합하여 엣지 맵을 만들었습니다. 그 결과, 엣지 검출을 위해 전혀 훈련되지 않았음에도 불구하고, Figure 10에서 보듯이 매우 합리적인 엣지 맵을 생성했습니다. Table 3의 정량 평가에서는 최신 전문 모델보다는 성능이 낮았지만, 초기의 딥러닝 기반 엣지 검출 모델(HED)과 비슷한 수준의 성능을 보여주며 SAM의 범용성을 입증했습니다.
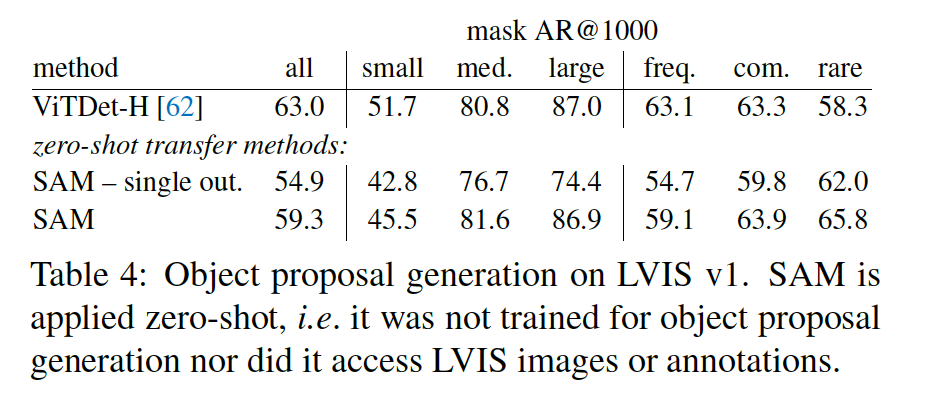
이미지 내에 객체가 있을 만한 영역을 제안하는 작업에서, LVIS 데이터셋으로 훈련된 강력한 탐지 모델(ViTDet-H)과 성능을 비교했습니다. 놀랍게도 SAM은 중간 크기, 큰 크기, 그리고 희귀한 객체에 대해서는 전문 모델보다 더 높은 재현율(Average Recall)을 기록했습니다.
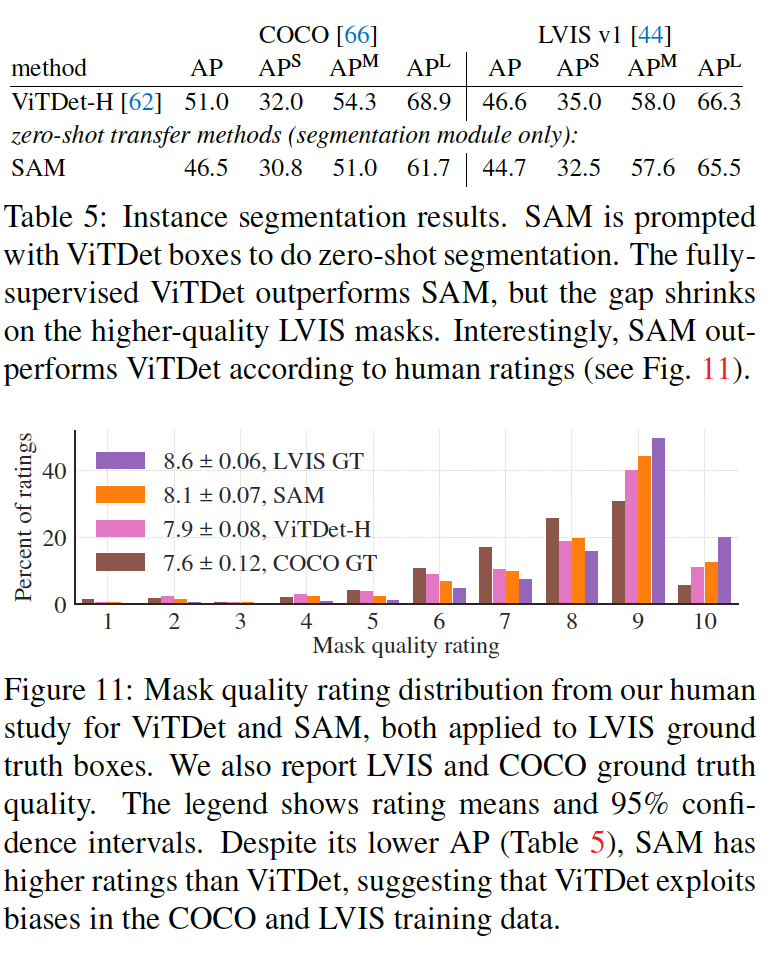
객체 탐지기가 찾아낸 박스를 프롬프트로 주어 객체를 분할하는 실험입니다. Table 5의 자동 평가 점수(AP)는 전문 모델인 ViTDet-H보다 낮았지만, Figure 11의 사람 평가에서는 SAM의 마스크 품질이 더 높게 평가되었습니다. 이는 ViTDet-H가 COCO나 LVIS 데이터셋의 고유한 주석 편향(예: 마스크에 구멍이 없는 등)까지 학습하여 점수를 높인 반면, SAM은 그런 편향 없이 더 보편적으로 고품질의 마스크를 생성하기 때문으로 분석됩니다.
3. 제로샷 텍스트-마스크 변환
개념 증명 단계의 실험으로, 텍스트 프롬프트를 사용해 객체를 분할하는 가능성을 보여주었습니다.
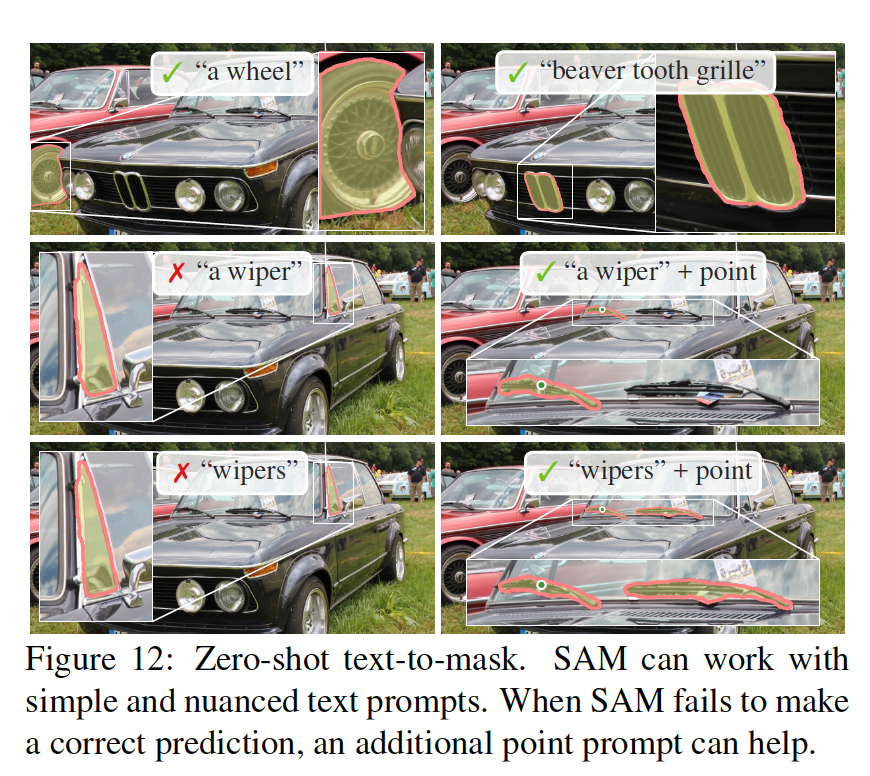
SAM은 “a wheel(바퀴)” 같은 간단한 텍스트뿐만 아니라, “beaver tooth grille(비버 이빨 그릴)“과 같은 구체적이고 미묘한 표현까지 이해하고 해당 객체를 정확하게 분할해냈습니다. 텍스트만으로 실패할 경우, 점 프롬프트를 추가하여 정확도를 높일 수도 있습니다.