CVPR 2016에서 발표되어 딥러닝 역사에 한 획을 그은 논문, Deep Residual Learning for Image Recognition에 대한 리뷰를 공유합니다.
이 논문은 당시 딥러닝 모델의 큰 난제였던 ‘네트워크가 깊어질수록 오히려 성능이 저하되는’ 문제를 해결했습니다. 저자들의 해법인 **ResNet (Residual Network)**은 ‘잔차 학습’이라는 혁신적인 구조를 도입하여 이전에는 불가능했던 100층 이상의 초심층 신경망 훈련을 가능하게 했습니다.
서론
컴퓨터가 이미지를 인식하는 기술, 예를 들어 사진 속의 고양이를 알아보는 인공지능(AI)은 ‘심층 신경망(Deep Neural Network)‘이라는 기술을 사용합니다. 이 신경망은 인간의 뇌가 정보를 처리하는 방식을 모방한 것으로, 여러 개의 층(layer)으로 이루어져 있습니다. 이론적으로는 이 층을 많이 쌓을수록, 즉 네트워크가 ‘깊어질수록’ 더 똑똑해져야 합니다. 마치 우리가 여러 단계의 사고를 거쳐 복잡한 문제를 해결하는 것과 같죠.
하지만 실제로는 무작정 층을 깊게 쌓기만 하면 오히려 성능이 떨어지는 성능 저하 (Degradation) 문제가 발생했습니다. 신기하게도 이는 단순히 계산이 너무 복잡해져서 생기는 과적합(overfitting) 문제도 아니었습니다. 더 깊은 모델이 그보다 얕은 모델보다 훈련 데이터에 대한 오류율(training error)이 더 높게 나타나는 이상한 현상이었습니다.
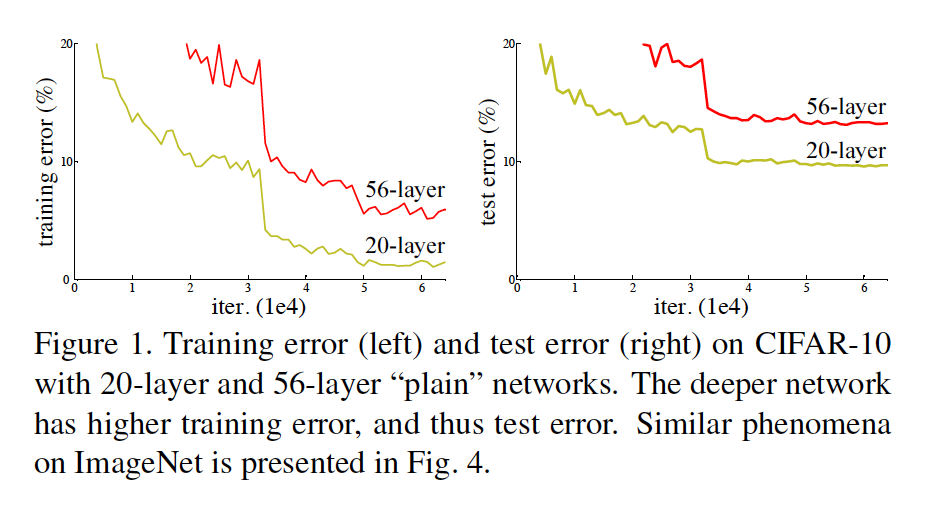
위 그림은 이 문제를 명확히 보여줍니다. CIFAR-10이라는 이미지 데이터셋으로 20층 네트워크와 56층 네트워크를 학습시킨 결과입니다. 왼쪽 그래프(training error)를 보면, 더 깊은 56층 네트워크(붉은색 선)가 20층 네트워크(노란색 선)보다 훈련 오류가 더 높습니다. 당연히 오른쪽 그래프(test error)에서도 56층 네트워크의 테스트 오류가 더 높게 나타납니다. 상식적으로 더 깊은 네트워크가 최소한 얕은 네트워크만큼의 성능은 내야 하는데, 실제로는 그렇지 못했던 것입니다.
이 논문은 바로 이 ‘성능 저하’ 문제를 해결하기 위해 **깊은 잔차 학습 (Deep Residual Learning)**이라는 새로운 프레임워크를 제안합니다. 간단히 말해, 네트워크가 처음부터 정답을 완벽하게 맞추려고 애쓰는 대신, 이미 알고 있는 정보(입력값)를 바탕으로 ‘차이(residual)‘만을 학습하도록 구조를 바꾼 것입니다. 이 혁신적인 방법으로 저자들은 이전에 불가능하다고 여겨졌던 152층 깊이의 네트워크를 성공적으로 훈련시켰고, 당시 이미지 인식 대회인 ILSVRC 2015에서 1위를 차지하는 쾌거를 이루었습니다.
기술 설명
ResNet의 핵심 아이디어는 어떻게 ‘차이’만을 학습하게 만드는 것일까요? 바로 **지름길 연결 (Shortcut Connection)**이라는 구조를 통해 구현됩니다.
기존의 신경망은 입력값 x가 여러 층을 순서대로 통과하며 복잡한 함수 H(x)를 학습하려고 했습니다. 예를 들어, 고양이 사진(x)을 보고 ‘고양이’라는 정답(H(x))을 바로 찾아내려는 방식이었죠.
하지만 ResNet은 생각을 바꿨습니다. ‘어차피 입력값 x가 있는데, 굳이 H(x) 전체를 새로 배울 필요가 있을까? 그냥 x에다가 약간의 정보만 더해서 정답을 만들면 되지 않을까?’ 라는 접근입니다. 그래서 네트워크가 학습해야 할 목표를 H(x)에서 F(x) = H(x) - x로 바꿉니다. 여기서 F(x)가 바로 입력값과 정답 사이의 ‘차이’, 즉 **잔차 (residual)**입니다. 네트워크는 이 잔차 F(x)를 학습한 뒤, 원래 입력값 x를 더해 최종 결과(F(x) + x)를 만들어냅니다.
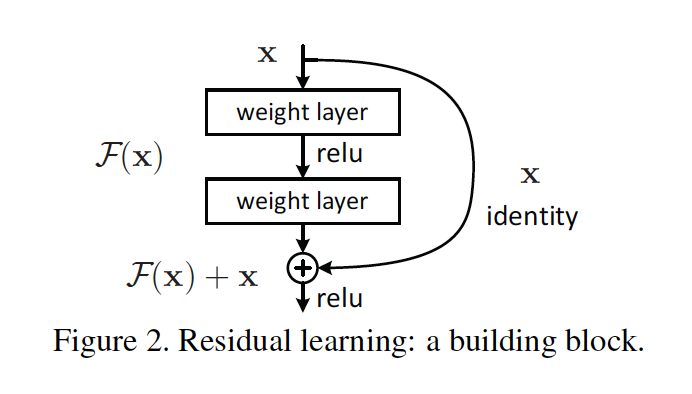
위 그림은 이 ‘잔차 학습’의 기본 단위를 보여줍니다.
- 입력값
x가 두 갈래로 나뉩니다. - 한쪽은 기존처럼 가중치 층(weight layer)을 통과하며 복잡한 변환, 즉
F(x)를 학습합니다. - 다른 한쪽은 아무런 변환 없이 그대로 건너뛰는 ‘지름길(shortcut)‘을 따라갑니다. 이를 **항등 매핑 (identity mapping)**이라고 부릅니다.
- 마지막에 두 결과(
F(x)와x)가 더해져 최종 출력(F(x) + x)이 됩니다.
이 구조가 왜 효과적일까요? 만약 어떤 층에서 아무것도 학습할 필요 없이 입력값을 그대로 전달하는 것이 최선인 상황이라면, 기존 네트워크는 여러 층을 거치며 입력과 출력이 똑같아지는 복잡한 변환을 학습해야만 했습니다. 이는 매우 어려운 일이었죠. 하지만 ResNet 구조에서는 네트워크가 잔차 F(x)를 그냥 ‘0’으로 만들기만 하면 됩니다. 즉, 가중치를 0으로 만들어 아무것도 바꾸지 않으면, 자연스럽게 입력 x가 그대로 출력으로 나가게 됩니다. 훨씬 쉬운 방법으로 최적의 해를 찾을 수 있는 것입니다.
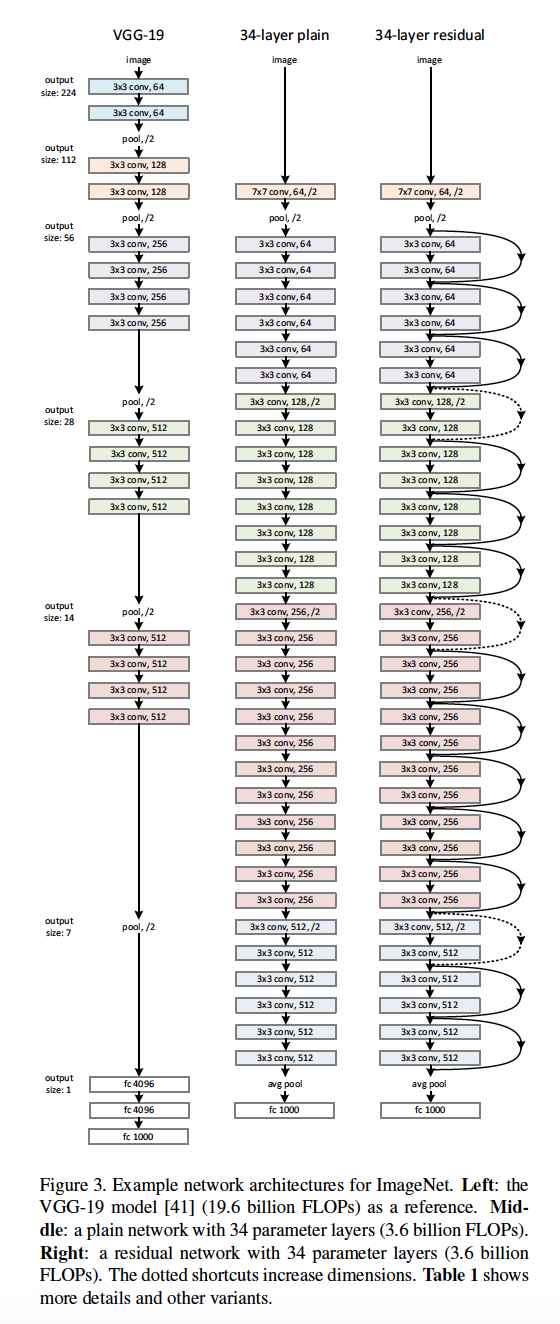
다음은 실제 네트워크 구조입니다.
- VGG-19 (왼쪽): 당시 표준으로 여겨지던 깊은 네트워크 구조입니다.
- 34-layer plain (중간): VGG-19의 모델을 따라 단순히 층을 깊게 쌓은 일반적인 네트워크입니다. 이 구조에서 성능 저하 문제가 발생합니다.
- 34-layer residual (오른쪽): 중간의 ‘plain’ 네트워크와 똑같은 구조에 ‘지름길 연결(shortcut connection)‘만 추가한 ResNet 구조입니다. 굽은 화살표들이 바로 이 지름길을 나타냅니다.
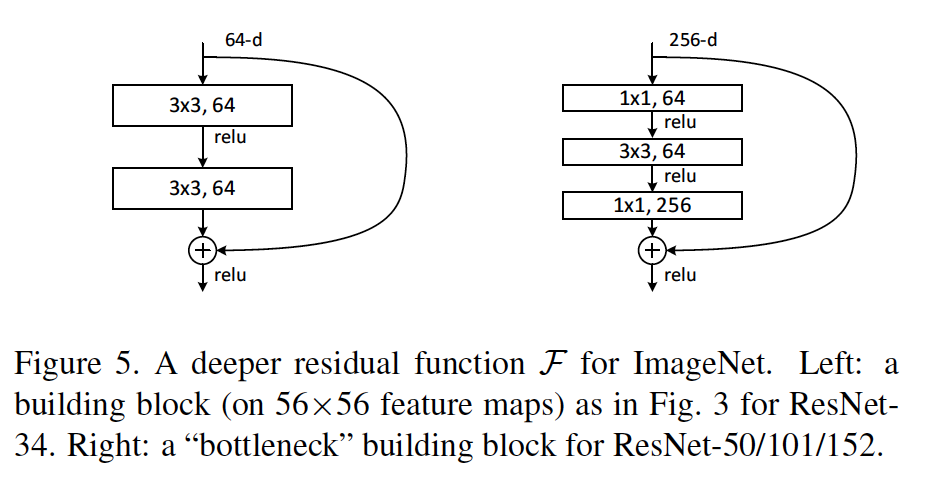
더 깊은 네트워크(50층 이상)를 효율적으로 만들기 위한 병목 (Bottleneck) 구조는 다음과 같습니다.
- 기존의 블록(왼쪽)이 3x3 필터의 합성곱 층 두 개로 이루어졌다면, 병목 블록(오른쪽)은 1x1, 3x3, 1x1 합성곱 층 세 개로 구성됩니다.
- 첫 번째 1x1 합성곱은 채널 수를 줄여 계산량을 감소시키고(병목처럼 입구가 좁아짐), 3x3 합성곱으로 핵심적인 연산을 수행한 뒤, 마지막 1x1 합성곱으로 다시 채널 수를 원래대로 복원하는 방식입니다.
- 이 구조 덕분에 층은 더 깊게 쌓으면서도 전체적인 계산 복잡도는 VGG 네트워크보다 낮게 유지할 수 있었습니다.
실험
저자들은 제안한 ResNet의 효과를 증명하기 위해 이미지넷(ImageNet)과 CIFAR-10이라는 대표적인 이미지 데이터셋으로 다양한 실험을 진행했습니다.
이미지넷(ImageNet) 분류 실험
이미지넷은 1000개의 클래스(종류)로 이루어진 128만 장의 방대한 이미지 데이터셋입니다.
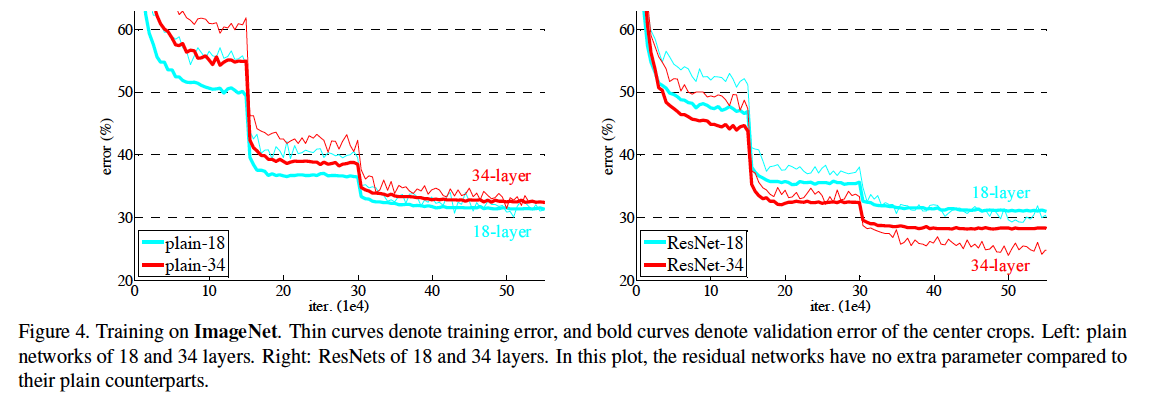
위 결과들은 ResNet이 성능 저하 문제를 어떻게 해결하는지 보여줍니다.
- 왼쪽 그래프: 일반(plain) 네트워크의 경우, 34층(붉은색 선)이 18층(하늘색 선)보다 훈련 오류와 검증 오류 모두 더 높습니다. 전형적인 성능 저하 현상입니다.
- 오른쪽 그래프: ResNet의 경우, 상황이 역전됩니다. 34층 ResNet(붉은색 선)이 18층 ResNet(하늘색 선)보다 오류율이 훨씬 낮습니다. 깊이가 깊어질수록 성능이 향상된 것입니다.
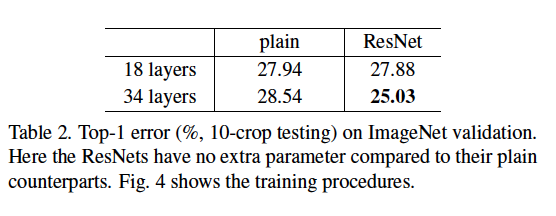
위 표는 이 결과를 수치로 보여줍니다. 일반 네트워크는 18층(27.94%)에서 34층(28.54%)으로 갈 때 오류율이 높아졌지만, ResNet은 18층(27.88%)에서 34층(25.03%)으로 갈 때 오류율이 2.8%나 크게 감소했습니다.
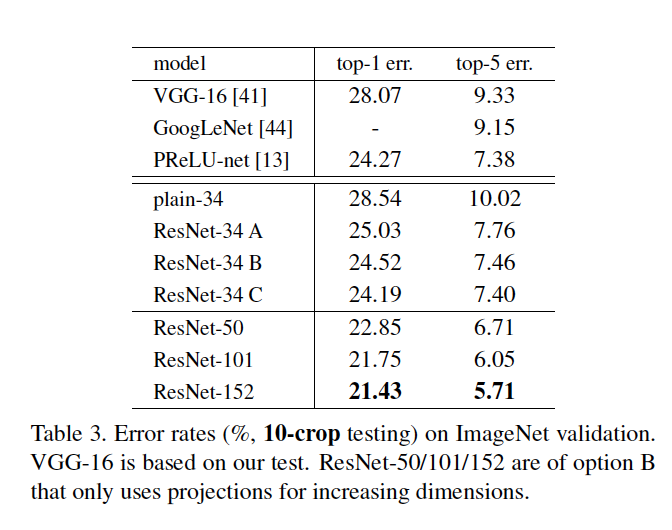
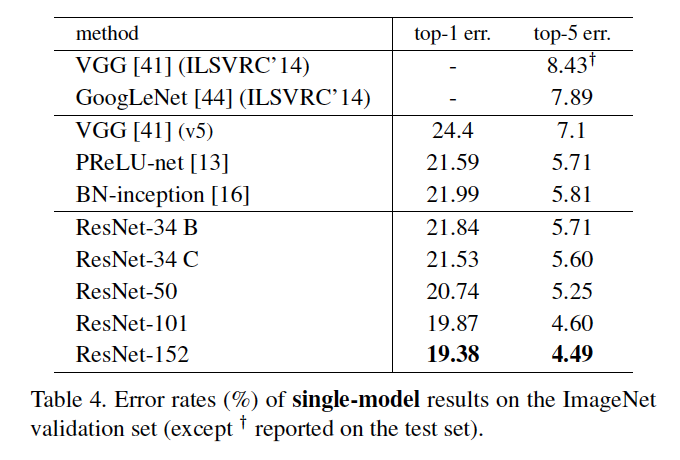
더 깊은 ResNet 모델들의 성능은 위 두 표와 같습니다. 저자들은 앞에서 설명한 ‘병목’ 구조를 사용해 50층, 101층, 그리고 무려 152층에 달하는 ResNet을 만들었습니다. 34층(25.03%)부터 시작해 50층(22.85%), 101층(21.75%), 152층(21.43%)으로 깊어질수록 top-1 오류율이 꾸준히 감소하는 것을 볼 수 있습니다. 성능 저하 문제없이 깊이의 이점을 취한 것입니다.
특히 152층 ResNet은 단일 모델만으로 4.49%의 top-5 검증 오류율을 달성했는데, 이는 당시 다른 여러 모델을 합친 앙상블(ensemble) 결과보다도 좋은 성적이었습니다.
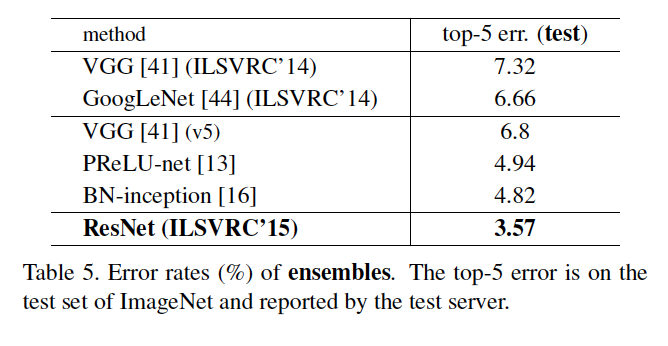
최종 대회 결과, 여러 ResNet 모델을 앙상블하여 이미지넷 테스트 데이터셋에서 **3.57%**라는 경이로운 top-5 오류율을 기록하며 ILSVRC 2015 대회에서 1위를 차지했습니다.
CIFAR-10 분석 및 1000층 이상의 네트워크
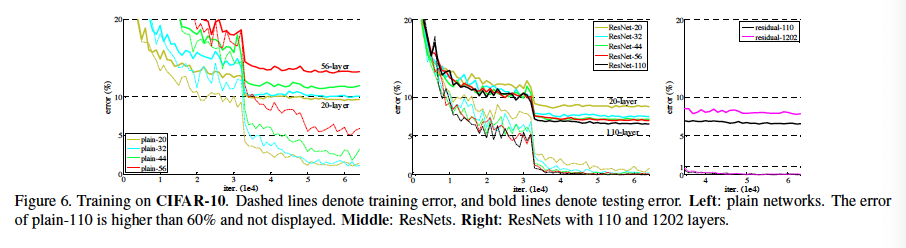
CIFAR-10 데이터셋을 이용한 실험에서도 비슷한 결과가 나타났습니다. 위 그래프는 CIFAR-10에서의 훈련 과정을 보여줍니다.
- 왼쪽 (plain networks): 일반 네트워크는 20층에서 56층으로 깊어질수록 오류율이 점점 높아지는 성능 저하 현상을 보입니다.
- 중간 (ResNets): 반면, ResNet은 20층부터 110층까지 깊이가 증가할수록 오류율이 꾸준히 감소합니다.
- 오른쪽 (110-layer vs 1202-layer): 저자들은 여기서 더 나아가 1202층이라는 극단적으로 깊은 네트워크를 훈련시키는 데 성공했습니다. 훈련 오류는 0.1% 미만으로 매우 낮았지만(오른쪽 그래프 아래쪽 선), 테스트 오류(7.93%)는 110층 모델(6.43%)보다 다소 높게 나타났습니다. 이는 작은 데이터셋에 비해 모델이 너무 거대해서 발생한 과적합(overfitting) 때문으로 분석됩니다.
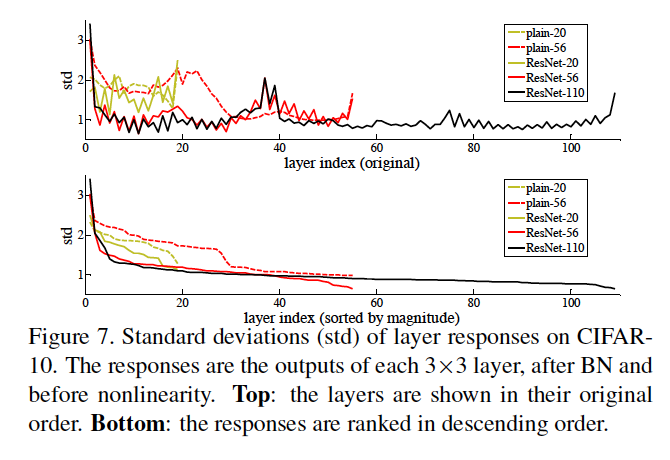
위 그래프는 각 층의 응답(출력값)의 표준편차를 분석한 것입니다.
- 그래프를 보면 전반적으로 ResNet(붉은색, 검은색 선)의 응답값이 일반 네트워크(노란색, 분홍색 선)보다 작습니다. 이는 ResNet의 잔차 함수가 일반적으로 ‘0’에 가까운 값을 갖는다는 가설을 뒷받침합니다. 즉, 각 층이 신호를 크게 바꾸기보다는 조금씩만 수정한다는 의미입니다.
- 또한 ResNet-20, 56, 110을 비교해보면, 네트워크가 깊어질수록 각 층의 응답값이 더 작아지는 경향을 보입니다. 더 많은 층이 협력하여 신호를 조금씩 점진적으로 바꾼다는 것을 시사합니다.
객체 탐지(Object Detection) 실험
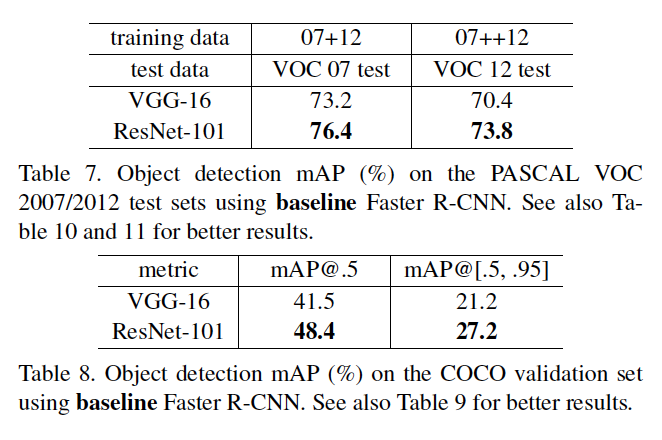
ResNet은 단순히 이미지를 분류하는 것을 넘어, 이미지 속 특정 물체의 위치를 찾아내는 객체 탐지 과제에서도 뛰어난 성능을 보였습니다. 아래 표들은 기존의 VGG-16 네트워크를 ResNet-101로 교체했을 때의 성능 향상을 보여줍니다. 특히 어려운 COCO 데이터셋에서 mAP(객체 탐지 성능의 주요 척도)가 28%나 상대적으로 향상되었습니다. 이는 ResNet이 학습한 표현(representation) 자체가 매우 우수하다는 것을 증명합니다.
결론
- 성능 저하 (Degradation) 문제 정의 및 해결: 이전까지는 명확하게 설명되지 않았던, 네트워크가 깊어질수록 훈련이 더 어려워지는 문제를 ‘성능 저하’로 명확히 정의하고, 이를 ‘잔차 학습(Residual Learning)‘이라는 혁신적인 아이디어로 해결했습니다.
- 초심층 신경망 (Extremely Deep Network)의 가능성 제시: ‘지름길 연결(Shortcut Connection)‘이라는 간단하면서도 강력한 구조를 통해 152층, 나아가 1000층이 넘는 매우 깊은 신경망의 훈련을 가능하게 했습니다. 이는 딥러닝 모델의 깊이에 대한 기존의 한계를 완전히 무너뜨린 것입니다.
- 다양한 분야에서의 SOTA (State-of-the-art) 달성: 제안된 ResNet은 이미지 분류뿐만 아니라 객체 탐지, 분할 등 다양한 컴퓨터 비전 분야에서 압도적인 성능을 보여주며 새로운 표준 모델로 자리 잡았습니다.
FYI
ResNet을 구현한 좋은 예시 링크가 있어서 가져와봤습니다!
https://github.com/JayPatwardhan/ResNet-PyTorch