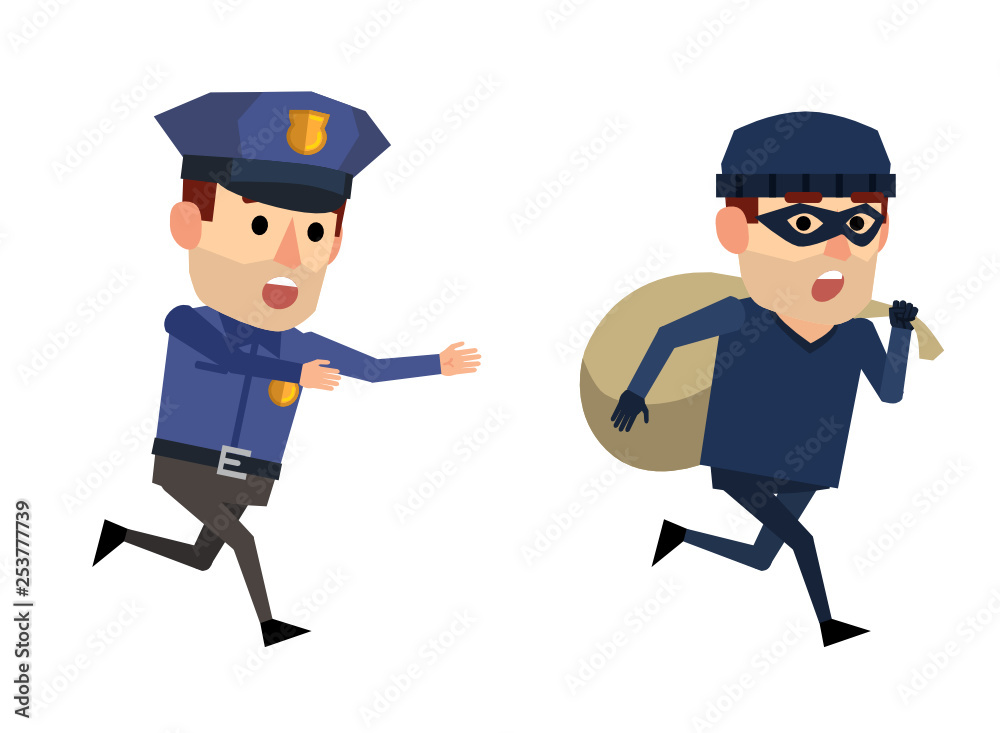
**‘위조지폐범(G)’**과 **‘경찰(D)’**이 있다고 상상해 보세요.
- 위조지폐범 (Generator, G): 이 친구의 목표는 진짜 같은 위조지폐를 만드는 것입니다. 처음에는 아주 서툴러서 종이에 그림을 그린 수준의 가짜 돈을 만듭니다.
- 경찰 (Discriminator, D): 이 경찰의 임무는 진짜 돈과 위조지폐범이 만든 가짜 돈을 구별하는 것입니다. 처음에는 위조지폐가 너무 가짜 같아서 구별하기 아주 쉽습니다.
이제 이 둘이 서로 **경쟁(adversarial)**을 시작합니다.
- **경찰(D)**은 진짜 돈 수백만 장과 위조지폐범(G)이 만든 가짜 돈 수백만 장을 보면서 진짜와 가짜를 구별하는 능력을 훈련합니다. 점점 똑똑해져서 웬만한 가짜는 다 잡아냅니다.
- **위조지폐범(G)**은 자기가 만든 돈이 경찰(D)에게 계속 걸리자, 어떻게 하면 경찰을 속일 수 있을지 연구합니다. “아, 홀로그램이 없어서 걸렸구나”, “종이 질감이 달라서 걸렸구나” 등등 경찰(D)이 무엇을 보고 가짜로 판단하는지, 그 피드백을 받아서(이것이 backpropagation입니다) 점점 더 정교한 위조지폐를 만듭니다.
- 이제 위조지폐범(G)이 만든 가짜 돈이 너무 정교해져서 경찰(D)이 헷갈리기 시작합니다.
- 그럼 **경찰(D)**은 더 열심히 훈련해서, 아주 미세한 차이점(예: 잉크 냄새)까지 구별해내려고 노력합니다.
- 이 경쟁은 계속됩니다.
이 게임의 최종 목표는 위조지폐범(G)이 너무 완벽한 위조지폐를 만들어서, 경찰(D)이 이게 진짜인지 가짜인지 구별할 확률이 **정확히 50% (즉, 찍는 수준)**가 되는 것입니다. 이 순간, 위조지폐범(G)은 ‘진짜 돈의 분포(distribution)‘를 완벽하게 학습했다고 말할 수 있습니다.
이 논문은 이 아이디어를 컴퓨터 모델, 특히 multilayer perceptrons (신경망)에 적용한 것입니다. $G$는 가짜 이미지(데이터)를 만들고, $D$는 진짜 이미지(데이터)와 $G$가 만든 가짜 이미지를 구별하도록 훈련합니다.
I. 서론 (Introduction)
이 논문은 generative models (생성 모델)을 학습하기 위한 새로운 프레임워크인 **Generative Adversarial Nets (GAN)**을 제안합니다.
기존의 deep generative models (심층 생성 모델)들은 maximum likelihood estimation (최대우도추정) 같은 전략을 사용했는데, 이 과정에서 매우 복잡하고 다루기 힘든 확률적 계산 (intractable probabilistic computations)이 많이 필요했습니다. 이 때문에 Markov chains (MCMC) 같은 근사적인 방법을 사용해야 했고, 이는 학습을 어렵고 느리게 만들었습니다.
이 논문은 이런 어려움을 피하는 새로운 방법을 제시합니다. 바로 **adversarial process (적대적 과정)**을 이용하는 것입니다. 두 개의 모델, 즉 데이터 분포를 포착하는 **generative model ($G$)**과 샘플이 $G$가 아닌 실제 학습 데이터에서 왔을 확률을 추정하는 **discriminative model ($D$)**을 동시에 학습시킵니다.
$G$의 학습 절차는 $D$가 실수할 확률을 최대화하는 것입니다. 이 프레임워크는 minimax two-player game에 해당합니다. 이 논문은 $G$와 $D$가 충분한 용량(capacity)을 가질 때, $G$가 학습 데이터의 분포를 완벽히 복구하고 $D$는 모든 곳에서 $\frac{1}{2}$를 출력하는 유일한 해가 존재함을 이론적으로 보입니다.
가장 큰 장점은 $G$와 $D$가 multilayer perceptrons (다층 퍼셉트론)으로 정의될 때, 전체 시스템이 **backpropagation (역전파)**만으로 학습될 수 있다는 것입니다. 학습이나 샘플 생성 과정에서 Markov chains나 approximate inference (근사 추론) 네트워크가 전혀 필요하지 않습니다.
II. 기술 설명 (Technology Description)
Adversarial nets 프레임워크는 두 모델이 모두 multilayer perceptrons일 때 가장 간단하게 적용됩니다.
- Generator ($G$): $G$는 입력 노이즈 변수에 대한 prior $p_z(z)$ (예: 랜덤 노이즈)를 입력받아, 데이터 공간으로의 매핑 $G(z; \theta_g)$을 수행합니다. $G$는 파라미터 $\theta_g$를 갖는 미분 가능한 함수(신경망)입니다.
- Discriminator ($D$): $D$는 데이터 $x$를 입력받아 $D(x; \theta_d)$라는 단일 스칼라 값을 출력합니다. 이 값은 $x$가 $G$가 생성한 $p_g$가 아닌, 실제 데이터 $p_{data}$로부터 왔을 확률을 나타냅니다. $D$는 파라미터 $\theta_d$를 갖는 신경망입니다.
$D$는 실제 데이터($x$)와 $G$가 만든 가짜 데이터($G(z)$) 모두에 대해 정답 레이블을 맞힐 확률을 최대화하도록 학습됩니다. 동시에 $G$는 $\log(1 - D(G(z)))$를 최소화하도록, 즉 $D$가 속아서 $D(G(z))$를 1에 가깝게 만들도록 학습됩니다.
이것이 바로 minimax game의 핵심입니다.
Equation (1): 이 게임의 가치 함수(Value function) $V(G, D)$는 다음과 같습니다.
- $\max_{D} V(D, G)$: $D$의 관점입니다. $D$는 $V$를 최대화하려 합니다.
- $\mathbb{E}_{x \sim p_{data}(x)}[\log D(x)]$: 실제 데이터$x$가 주어졌을 때,$D(x)$(진짜라고 판단할 확률)가 1에 가까워지도록 합니다.$\log(1)$은 0으로 최대값입니다.
- $\mathbb{E}_{z \sim p_z(z)}[\log(1 - D(G(z)))]$: 가짜 데이터 $G(z)$가 주어졌을 때, $D(G(z))$ (진짜라고 판단할 확률)가 0에 가까워지도록 합니다. $\log(1-0)$은 0으로 최대값입니다.
- 즉, $D$는 진짜는 진짜로(1), 가짜는 가짜로(0) 완벽하게 분류하도록 학습됩니다.
- $\min_{G} V(D, G)$: $G$의 관점입니다. $G$는 $V$를 최소화하려 합니다.
- $G$는 첫 번째 항($\mathbb{E}_{x \sim p_{data}(x)}[\log D(x)]$)에 영향을 줄 수 없습니다.
- $G$는 두 번째 항($\mathbb{E}_{z \sim p_z(z)}[\log(1 - D(G(z)))]$)만 제어할 수 있습니다. $G$는 $D$가 $G(z)$를 진짜라고 속게(즉, $D(G(z))$가 1이 되게) 만들어야 합니다. $D(G(z))$가 1에 가까워지면 $\log(1 - 1)$은 $-\infty$에 가까워지며, 이는 $V$를 최소화하는 방향입니다.
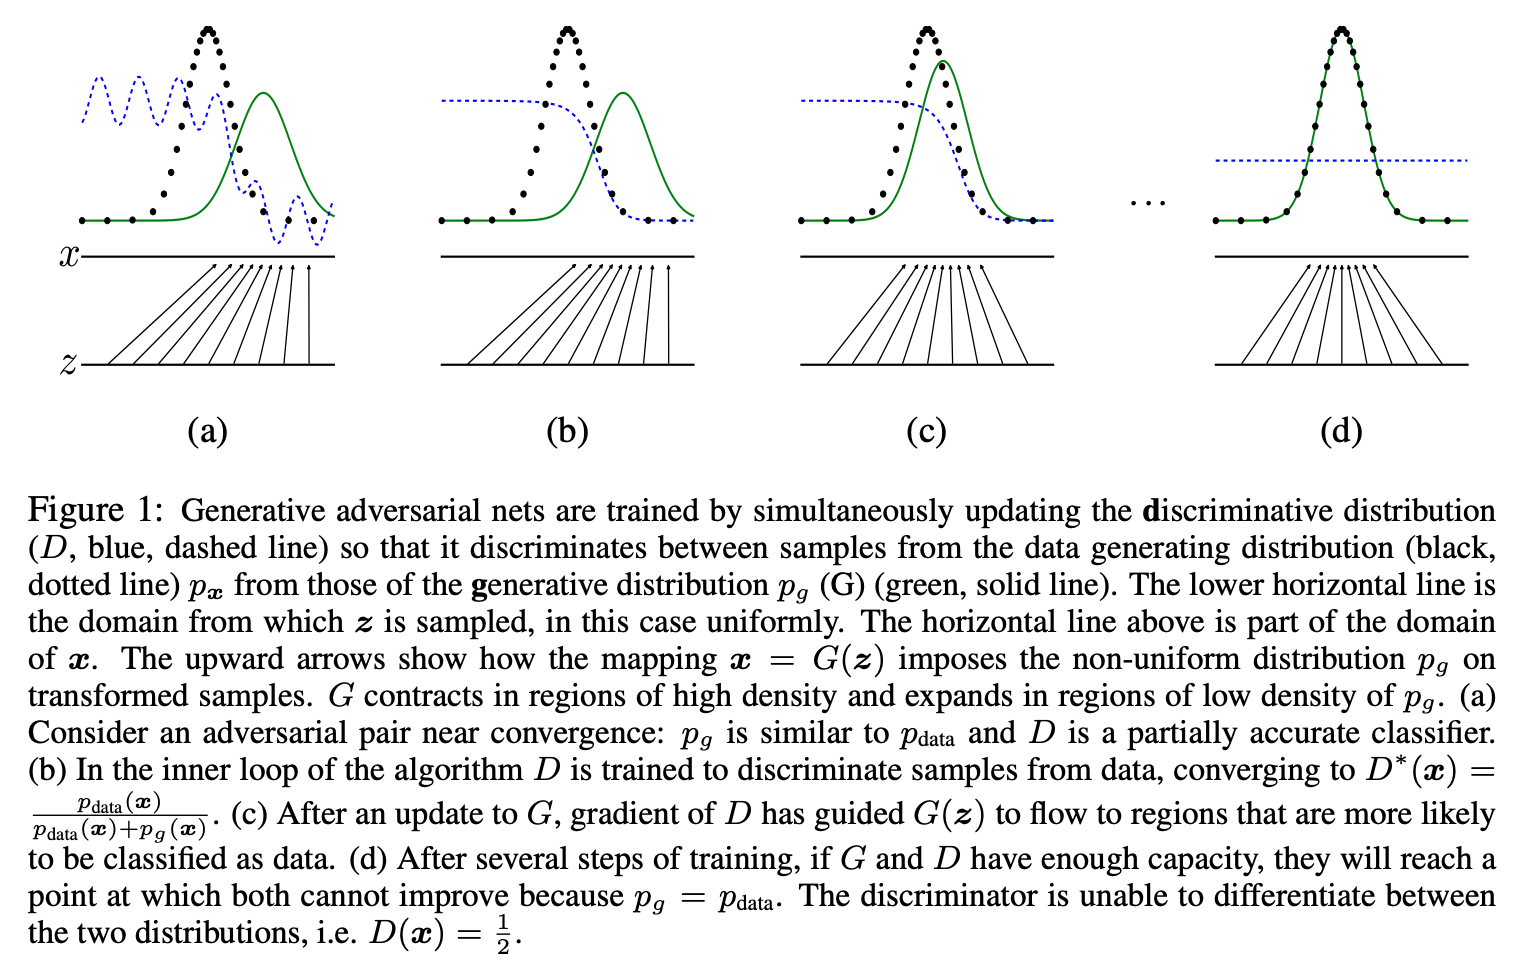
이 그림은 이 적대적 학습 과정을 시각적으로 보여줍니다. $p_{data}$ (검은 점선, 실제 데이터)와 $p_g$ (녹색 실선, $G$가 생성)가 있고, $D$ (파란 파선)가 이 둘을 구별하려 합니다. (b)에서 $D$가 두 분포를 구별하도록 업데이트되고, (c)에서 $G$가 $D$를 속이는 방향(즉, $D$가 ‘진짜’라고 판단하는 높은 영역)으로 $p_g$를 이동시키도록 업데이트됩니다. (d)는 $p_g = p_{data}$가 되어 $G$와 $D$가 더 이상 개선될 수 없는 평형 상태($D(x) = \frac{1}{2}$)에 도달한 것을 보여줍니다.
Algorithm 1은 이 과정을 학습하는 구체적인 알고리즘을 보여줍니다.
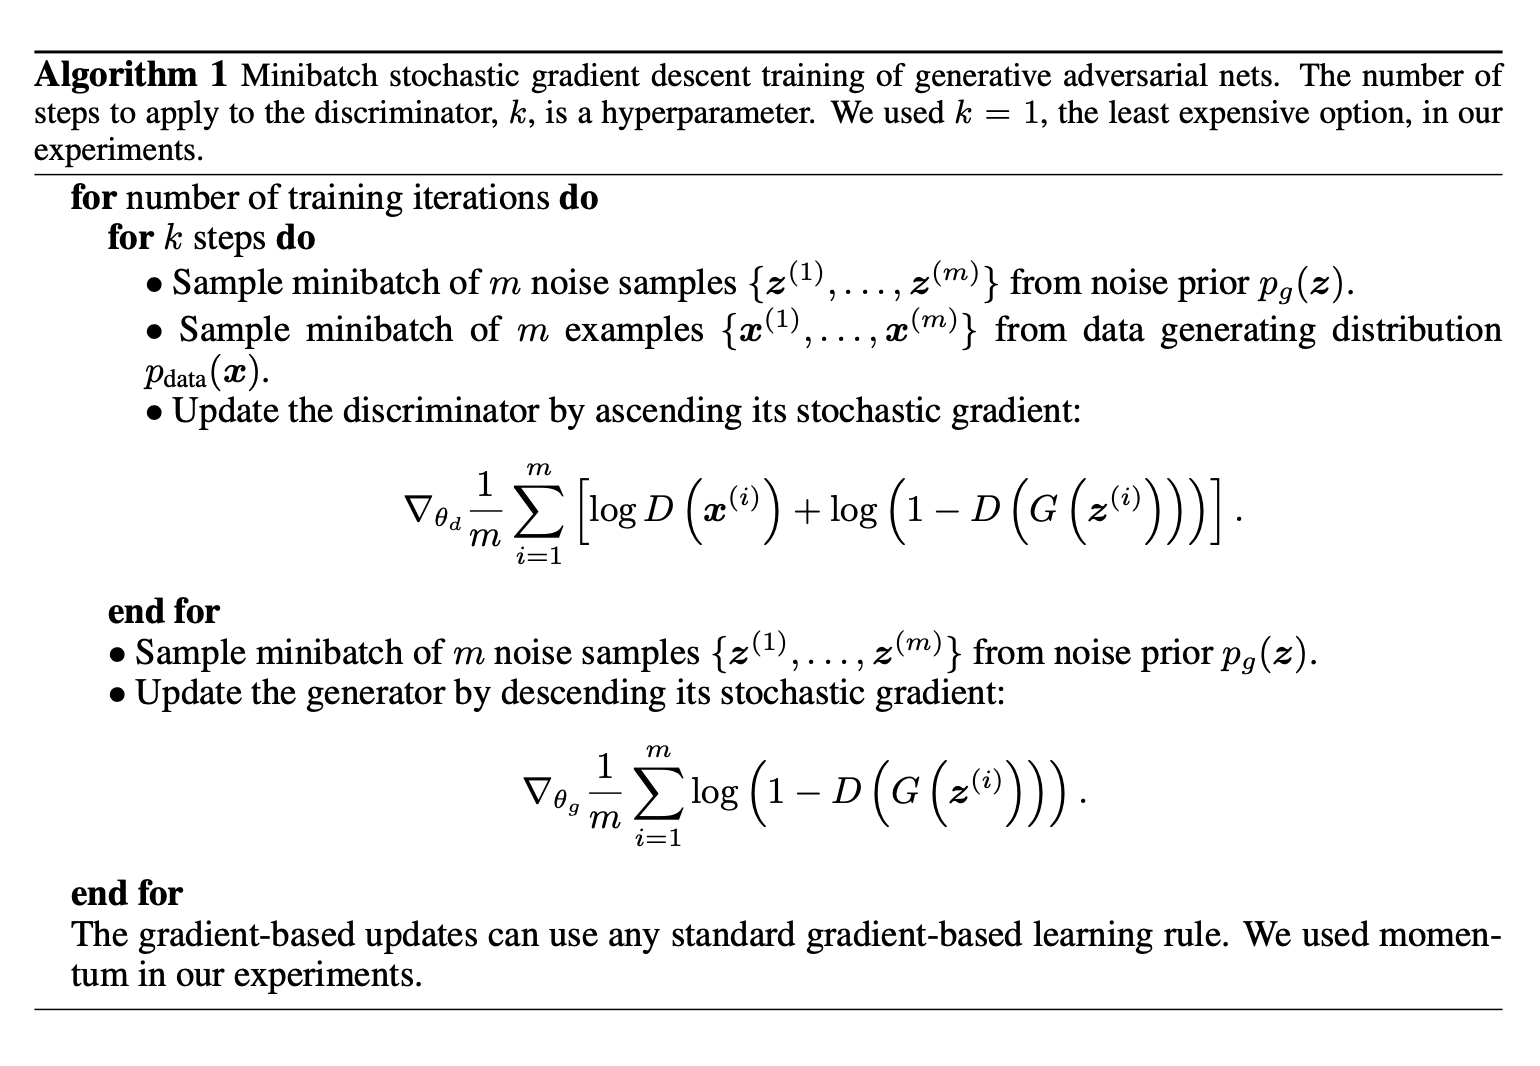
minibatch stochastic gradient descent (미니배치 확률적 경사 하강법)을 사용합니다. 학습 루프 안에서:
$D$를 $k$ 스텝 동안 최적화합니다. (실험에서는 $k=1$을 사용)
- 노이즈 샘플 $z$와 실제 데이터 샘플 $x$를 미니배치로 뽑습니다.
- $D$의 stochastic gradient (확률적 경사)를 상승 (ascending)시킵니다.
$D$ Gradient Update:
$$ \nabla_{\theta_d}\frac{1}{m}\sum_{i=1}^{m}[\log D(x^{(i)}) + \log(1 - D(G(z^{(i)})))] $$$G$를 1 스텝 최적화합니다.
- 새로운 노이즈 샘플 $z$를 미니배치로 뽑습니다.
- $G$의 stochastic gradient (확률적 경사)를 하강 (descending)시킵니다.
$G$ Gradient Update:
$$ \nabla_{\theta_g}\frac{1}{m}\sum_{i=1}^{m}\log(1 - D(G(z^{(i)})))] $$
이 논문은 $G$를 학습시킬 때 $\log(1 - D(G(z)))$를 최소화하는 것보다 $\log D(G(z))$를 최대화하는 것이 초기에 더 강력한 gradient를 제공한다고 지적합니다.
Proposition 1: 주어진 $G$에 대해, 최적의 판별자 $D$는 다음과 같습니다.
증명:
목표: $G$가 고정되어 있을 때, $D$는 $V(G, D)$를 최대화하려고 합니다. $V(G, D)$는 다음과 같습니다 :
$V(G, D)$는 모든 $x$에 대한 적분입니다. 이 적분값을 최대화하려면, 적분 안의 함수, 즉 $f(y) = a \log(y) + b \log(1-y)$ 형태의 값을 모든 $x$ 지점에서 개별적으로 최대화하면 됩니다. 여기서 $y = D(x)$, $a = p_{data}(x)$, $b = p_g(x)$입니다.
이 함수의 최댓값을 찾기 위해 $y$에 대해 미분하여 0으로 설정합니다:
결론: $y = D(x)$, $a = p_{data}(x)$, $b = p_g(x)$를 다시 대입하면, $V(G, D)$를 최대화하는 최적의 $D(x)$는 정확히 다음과 같습니다.
Theorem 1:
증명:
최적 지점 (
이것이 유일한 최소값인가?: 논문은
최종 결론: JSD는 두 분포 간의 ‘거리’를 측정하는 지표이며, 항상 0보다 크거나 같습니다 ($JSD \ge 0$). JSD가 0이 되는 유일한 경우는 두 분포가 정확히 같을 때입니다 ($p_{data} = p_g$). 따라서 $C(G)$는 $C(G) = -\log 4 + (\text{항상 0 이상인 값})$ 입니다. $C(G)$의 전역 최소값($C^*$)은 $JSD=0$일 때 달성되며, 그 값은 $-\log 4$입니다.
$JSD=0$은 $p_g = p_{data}$를 의미하므로, $G$의 학습 목표($C(G)$ 최소화)가 $p_g$를 $p_{data}$와 같게 만드는 것과 동일함이 수학적으로 증명되었습니다.
Algorithm 1의 수렴성 (Convergence)
Proposition 2:
목표:
핵심 1 (Convexity):
- 이유:$U(p_g, D) = \int [ p_{data} \log D + p_g \log(1-D) ] dx$입니다. 이는$p_g$에 대한$A + \int p_g \cdot B(x) dx$형태의 선형(linear) 함수이며, 선형 함수는 convex입니다.
핵심 2 (Supremum):
- 따라서$G$의 비용 함수$C(G)$는$p_g$에 대해 convex합니다.
핵심 3 (Gradient):
- Danskin’s Theorem에 따르면,$\sup_D U(p_g, D)$의$p_g$에 대한 gradient는,$U(p_g, D)$를 최대화하는$D$(즉,$D_G^*$) 를 찾은 다음, 그$D_G^*$를 고정한 채$U(p_g, D_G^*)$를$p_g$에 대해 미분한 값과 같습니다.
- 알고리즘 1은 정확히 이 작업을 근사적으로 수행합니다.
(1)$D$를 최적화합니다 ($D_G^*$를 근사). (2)$G$를 업데이트합니다 ($U(p_g, D_G^*)$의 gradient descent를 수행).
결론:
Convex 함수를 gradient descent (경사 하강법)로 최적화하면 (충분히 작은 업데이트 스텝으로), 그 유일한 전역 최적해(
한계점
논문은 마지막에 중요한 현실적 문제를 언급합니다. 위의 모든 증명은 우리가 $p_g$라는 확률 분포 자체를 직접 최적화할 수 있다고 가정한 비모수적(non-parametric) 환경에서 이루어졌습니다.
실제: 우리는 $p_g$ 자체를 최적화하는 것이 아니라, $G(z; \theta_g)$라는 multilayer perceptron (신경망)의 **파라미터 $\theta_g$**를 최적화합니다.
문제: $C(G)$가 $p_g$에 대해서는 convex할지라도, $G$의 파라미터 $\theta_g$에 대해서는 전혀 convex하지 않습니다. $\theta_g$ 공간은 critical points (임계점, 즉 local minima 나 saddle point)가 많습니다.
결론: 따라서 실제 학습(Algorithm 1)이 이론적인 전역 최적해($p_g = p_{data}$)에 도달한다는 이론적 보장은 없습니다.
그럼에도 불구하고, 논문은 multilayer perceptron이 실험에서 훌륭한 성능을 보여주기 때문에, 이 이론적 보장의 부재에도 불구하고 합리적인 모델이라고 주장합니다. (🤔??)
III. 실험 (Experiments)
Adversarial nets는 MNIST, Toronto Face Database (TFD), CIFAR-10 데이터셋에서 훈련되었습니다.
생성 모델의 성능 평가는 생성된 샘플의 log-likelihood를 직접 계산하기 어려워 까다롭습니다. 이 논문은 Gaussian Parzen window (가우시안 파젠 창) 기법을 사용하여 테스트셋 데이터의 확률을 추정했습니다.
Table 1은 이 Parzen window 기반 log-likelihood 추정 결과를 보여줍니다.
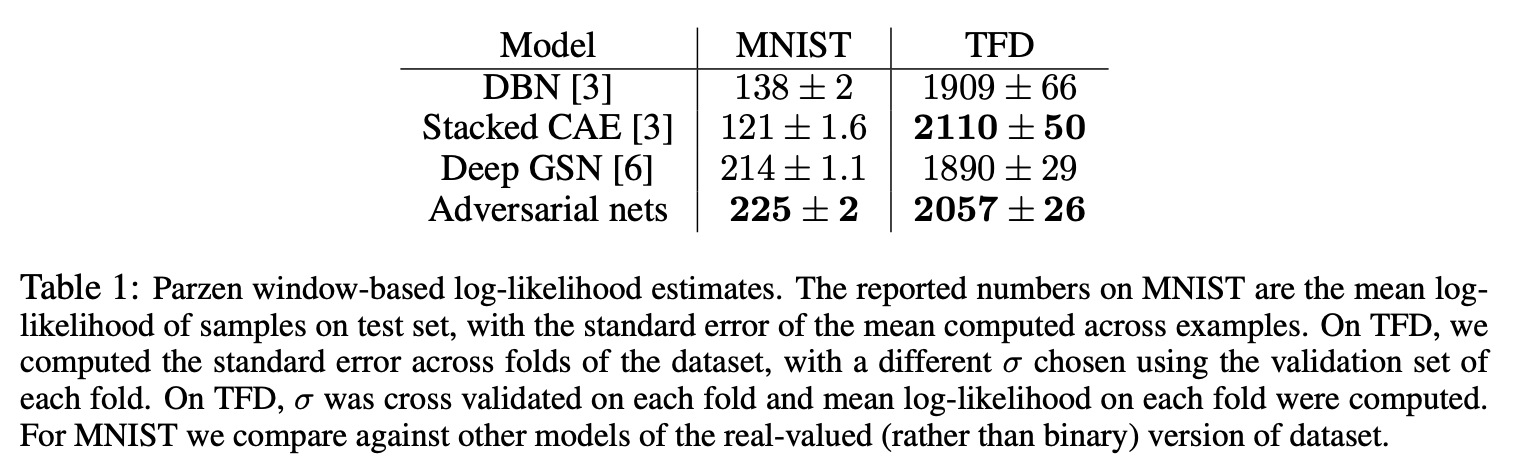
MNIST와 TFD 데이터셋에 대해 Adversarial nets의 결과를 DBN, Stacked CAE (Stacked Contractive Auto-encoders), Deep GSN 등 다른 모델들과 비교합니다. 이 표는 Adversarial nets가 기존의 우수한 생성 모델들과 “최소한 경쟁력 있는(at least competitive)” 성능을 보임을 나타냅니다.
Figure 2는 훈련된 generator 넷에서 추출한 샘플들을 시각화합니다.
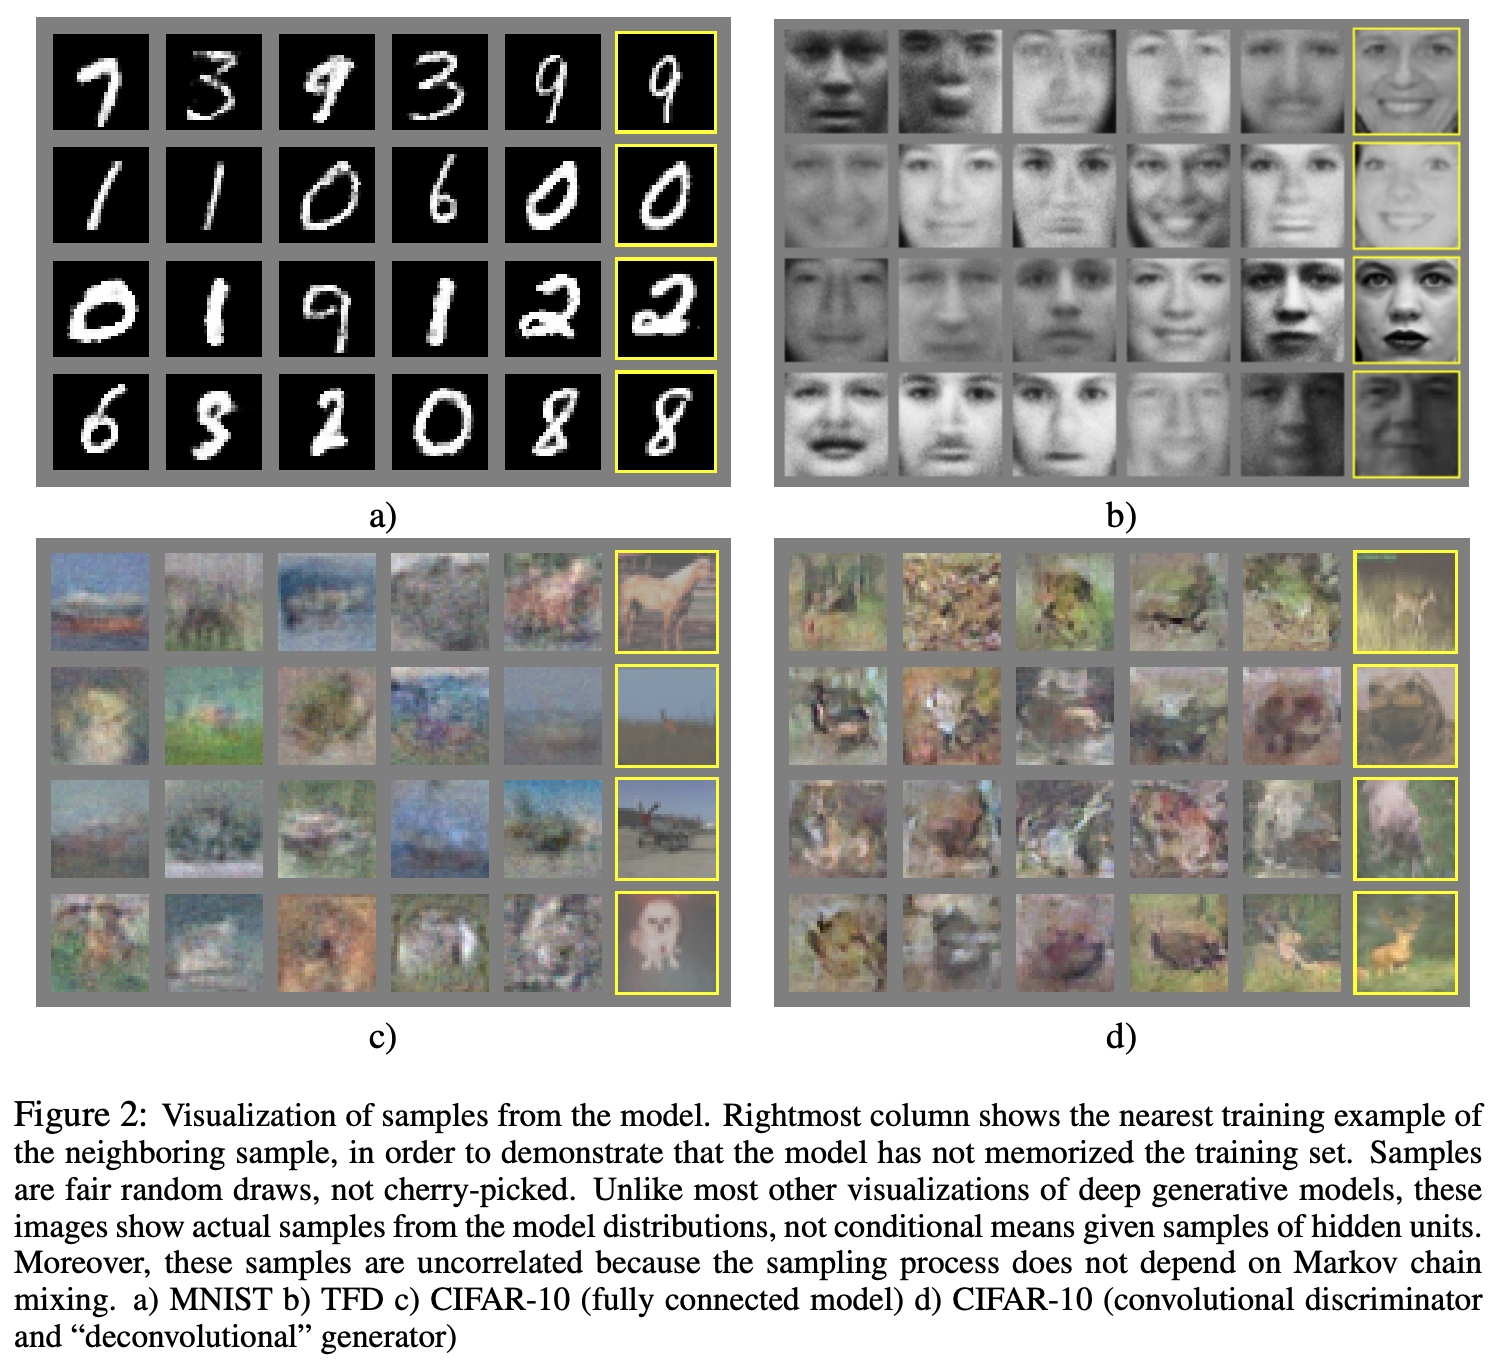
MNIST (숫자), TFD (얼굴), CIFAR-10 (물체)에 대해 생성된 이미지들을 보여줍니다. 이 그림에서 중요한 점은 각 이미지 그리드의 가장 오른쪽 열입니다. 이 열은 바로 왼쪽의 생성된 샘플과 가장 가까운 실제 훈련 데이터를 보여줍니다. 이는 모델이 훈련 데이터를 단순히 **“암기(memorized)”**한 것이 아니라 새로운 샘플을 생성하고 있음을 보여주기 위한 것입니다. 이 샘플들은 Markov chain에 의존하지 않기 때문에 서로 상관관계가 없습니다.
Figure 3은 $z$ 공간(노이즈 입력 공간)의 좌표 사이를 linearly interpolating (선형 보간)하여 얻은 숫자 이미지들을 보여줍니다.
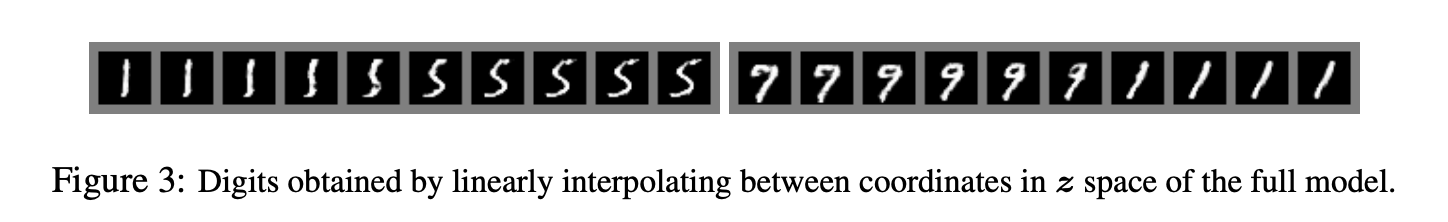
예를 들어 ‘1’을 생성하는 $z$ 벡터와 ‘5’를 생성하는 $z$ 벡터 사이의 중간 지점들을 $G$에 입력하면, ‘1’이 ‘5’로 부드럽게 변해가는 중간 형태의 숫자 이미지들이 생성됩니다. 이는 $G$가 의미 있는 representation (표현)을 학습했음을 시사합니다.
IV. 결론 (Advantages and disadvantages)
이 새로운 프레임워크는 장점과 단점을 모두 가집니다.
Table 2는 generative modeling (생성 모델링)의 여러 접근법들이 겪는 어려움들을 요약합니다.
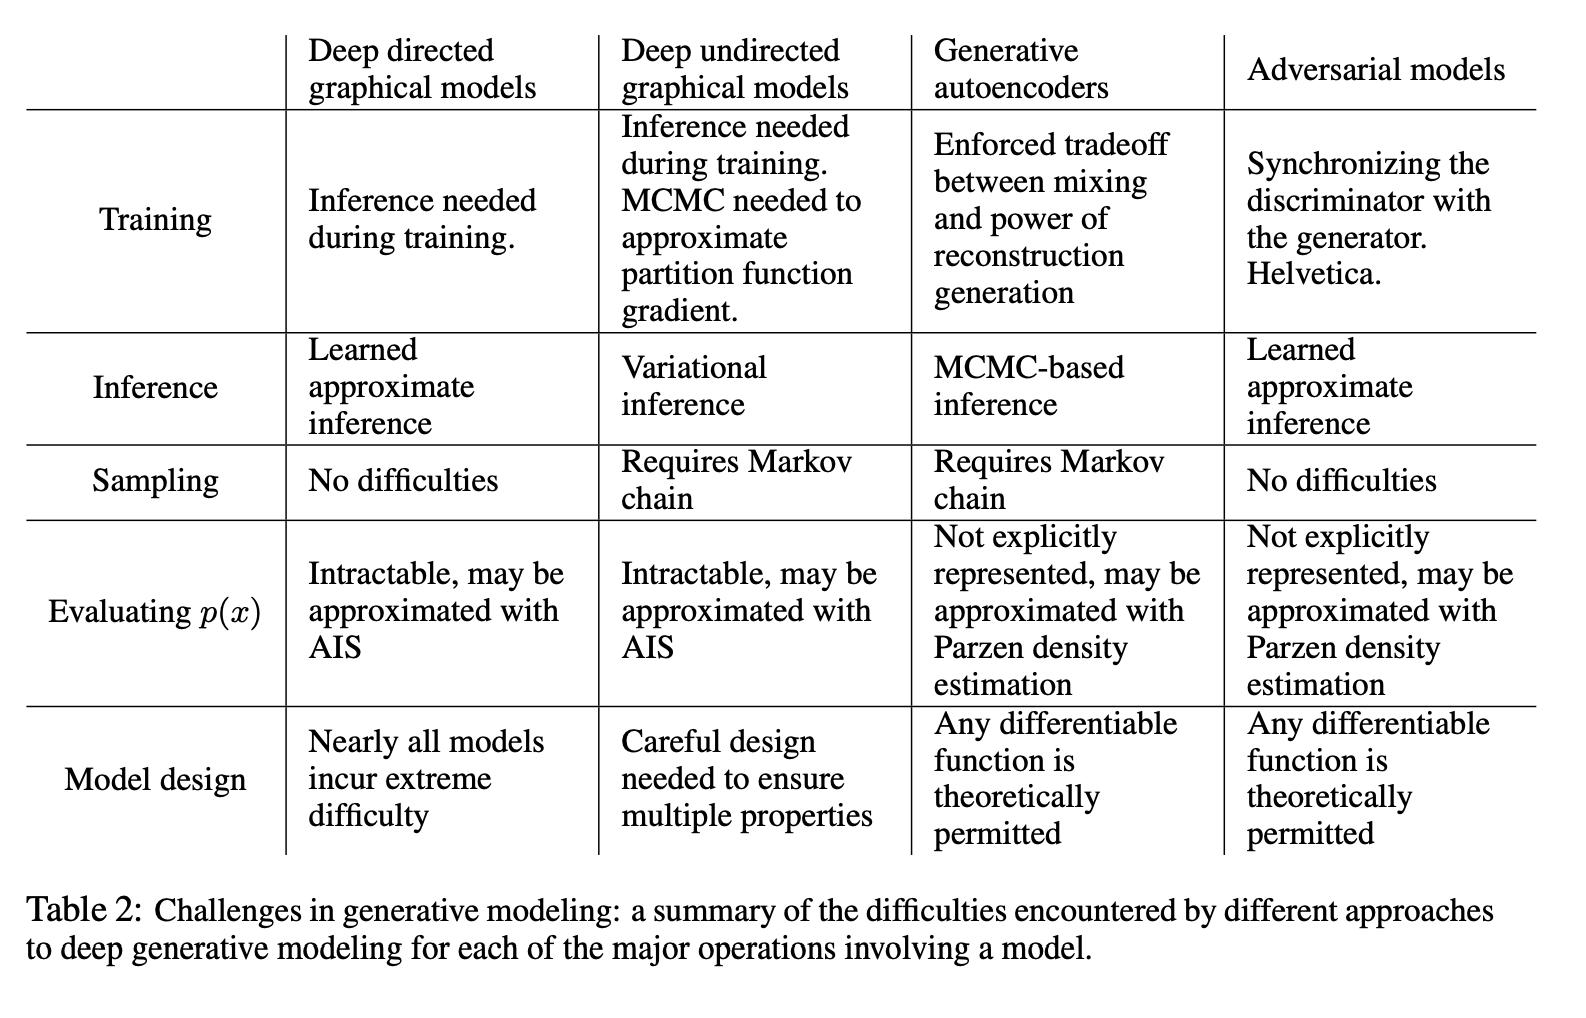
Adversarial models를 Deep directed graphical models, Deep undirected graphical models, Generative autoencoders와 비교합니다.
장점:
- Markov chains가 전혀 필요 없습니다. 샘플링은 $G$를 통한 단 한 번의 forward propagation (순전파)입니다.
- 학습 중 inference (추론)가 필요 없습니다.
- gradient (기울기)를 얻기 위해 backpropagation (역전파)만 사용합니다.
- 매우 날카롭거나 degenerate (퇴화된) 분포(즉, 한 점에 모인 분포)도 표현할 수 있습니다. (반면 MCMC 기반 방법들은 분포가 어느 정도 “흐릿해야(blurry)” 믹싱이 잘 됩니다).
단점:
- $p_g(x)$ (생성된 데이터의 확률)에 대한 명시적인 표현이 없습니다.
- $D$와 $G$가 학습 중에 잘 **“동기화(synchronized)”**되어야 합니다. 만약 $G$가 $D$의 업데이트 없이 너무 많이 학습되면, $G$가 $p_{data}$를 모델링하기에 충분한 다양성을 갖지 못하고 특정 $x$ 값으로 **collapse (붕괴)**하는 “Helvetica 시나리오” (여러 $z$가 똑같은 $x$로 매핑되는 현상)에 빠질 수 있습니다.