개요
엄청난 독서광이라 세상의 모든 책을 읽은 친구(Large Language Model)가 있다고 상상해 보세요. 이 친구는 글은 기가 막히게 잘 쓰지만, 태어나서 한 번도 그림이나 사진을 본 적이 없습니다. 반대로, 그림만 하루 종일 봐서 시각적인 정보는 완벽하게 알지만 말주변이 없는 친구(Vision Encoder)도 있습니다.
Flamingo는 이 두 친구를 이어주는 ‘마법의 통역사’ 같은 모델입니다.
그림 잘 보는 친구가 사진을 보고 “이건 털이 복슬복슬한 고양이야"라고 정보를 압축해서 넘겨주면, Flamingo의 특별한 장치(Perceiver Resampler 등)가 이것을 글 잘 쓰는 친구가 이해할 수 있는 언어로 번역해 줍니다.
가장 대단한 점은 **‘눈치(Few-Shot Learning)’**가 엄청나게 빠르다는 것입니다. 예전에는 인공지능에게 “이건 고양이고, 이건 강아지야"라고 수만 번 가르쳐야(Fine-tuning) 겨우 알아들었습니다. 하지만 Flamingo는 마치 똑똑한 고등학생처럼, 시험 문제집에서 예시 문제 한두 개만 쓱 보여주면(Few-Shot), 바로 원리를 깨닫고 처음 보는 문제도 척척 풀어냅니다. 사진과 글이 섞여 있는(Interleaved) 복잡한 블로그 게시물 같은 것도 순서대로 이해하고 대화할 수 있는 능력을 갖췄습니다.
1. 서론 (Introduction)
이 논문은 비전(Vision)과 언어(Language)를 결합한 멀티모달 모델인 Flamingo를 소개합니다. 기존 모델들은 새로운 작업을 수행하기 위해 수천 개의 데이터로 모델을 미세 조정(Fine-tuning)해야 했습니다. 하지만 Flamingo는 사전 학습된 강력한 Vision Encoder와 Large Language Model(LLM)을 결합하여, 단 몇 개의 예시(Few-Shot)만으로도 이미지 및 비디오 이해 작업에서 최고 성능(SOTA)을 달성합니다.
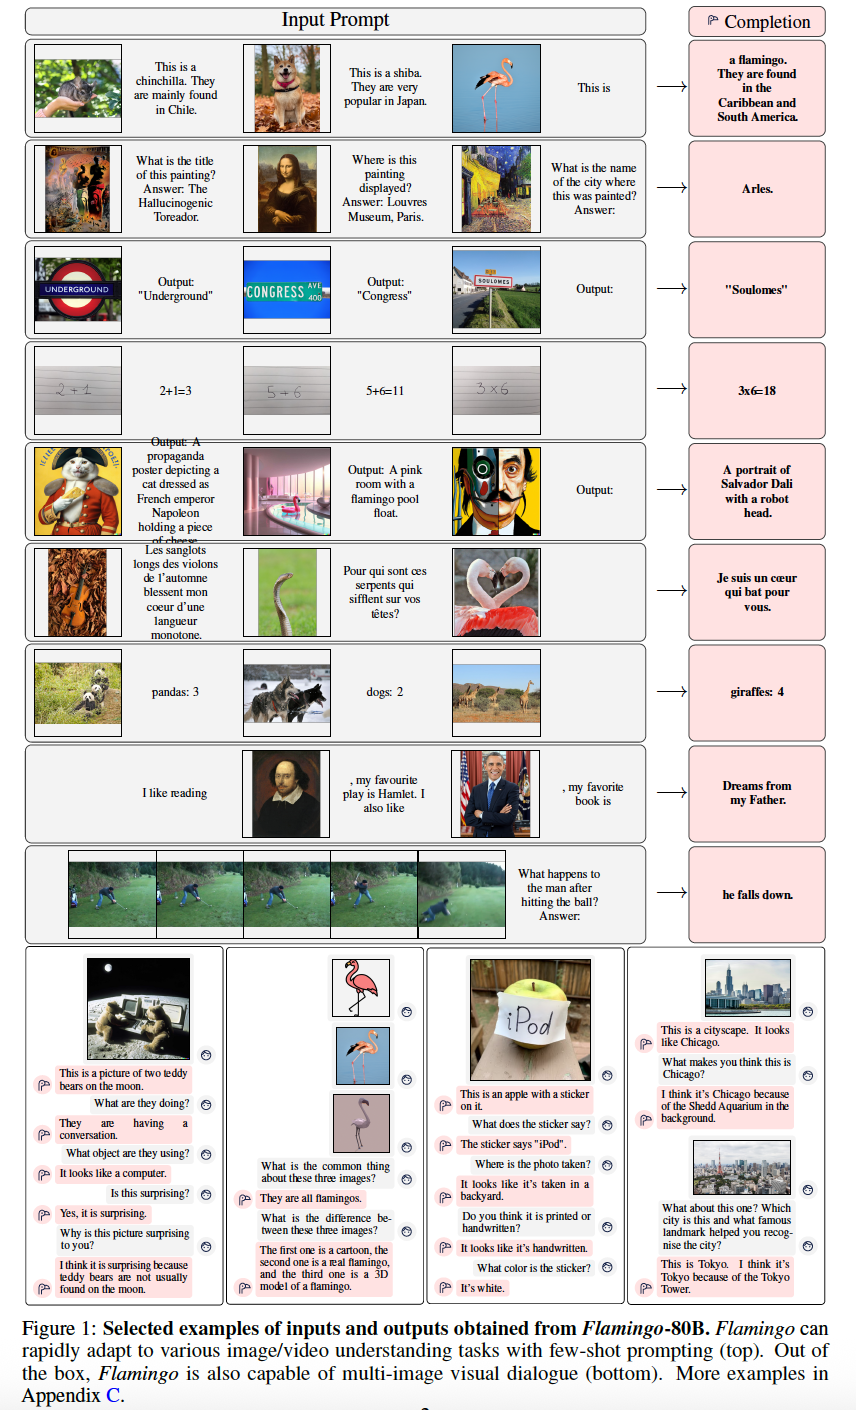
이 그림은 Flamingo가 이미지와 텍스트가 섞인 입력을 받아, 동물 분류, 도시 이름 맞추기, 수학 문제 풀이 등 다양한 작업을 수행하는 것을 보여줍니다. 특히 몇 개의 예시만 주어지면(Few-shot prompting) 새로운 태스크에 빠르게 적응하는 것을 확인할 수 있습니다.
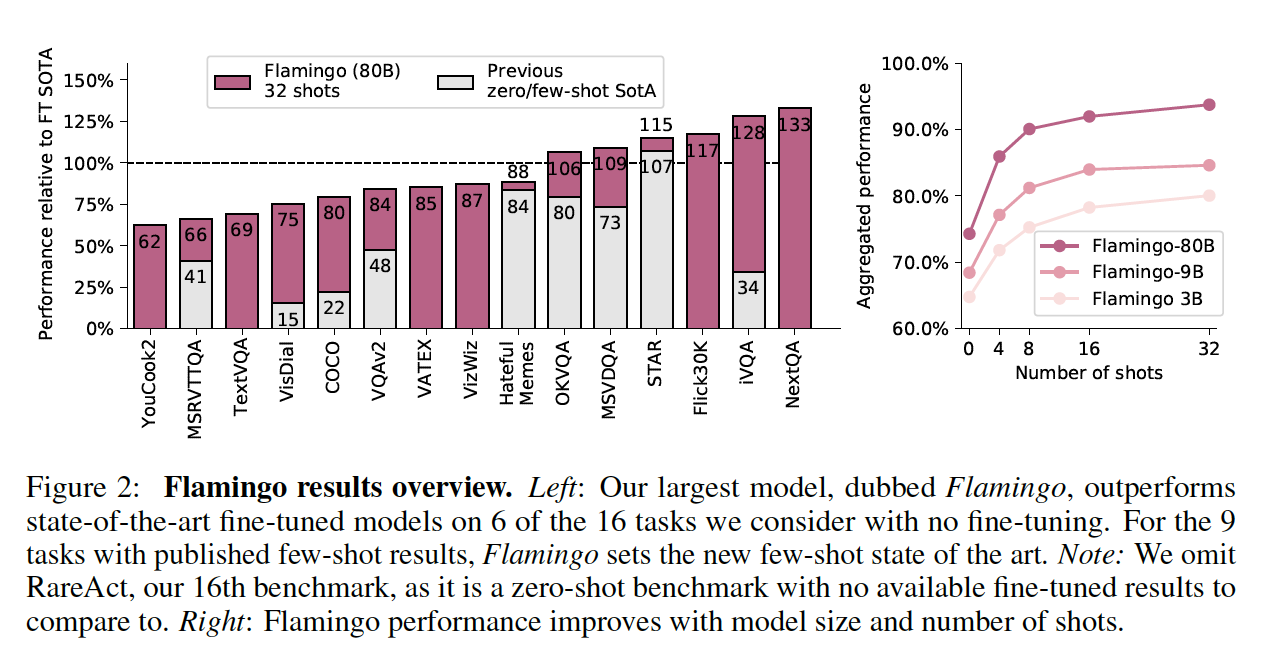
왼쪽은 Flamingo가 별도의 Fine-tuning 없이도, 수천 배의 데이터를 사용해 학습한 기존 모델들(SOTA)보다 16개 중 6개 태스크에서 더 뛰어난 성능을 보임을 나타냅니다. 오른쪽은 모델의 크기(Parameters)와 샷(Shot) 수가 늘어날수록 성능이 향상됨을 보여줍니다.
2. 기술적 설명 (Technical Description)
Flamingo의 핵심은 이미 잘 학습된 Vision Encoder와 LLM을 ‘얼리지(Frozen)’ 않은 상태로 두고, 둘 사이를 연결하는 새로운 레이어만 학습시키는 것입니다. 이를 통해 기존 모델들이 가진 방대한 지식을 잊어버리지 않으면서(Catastrophic Forgetting 방지) 시각 정보를 통합합니다.
2.1 아키텍처 (Architecture)
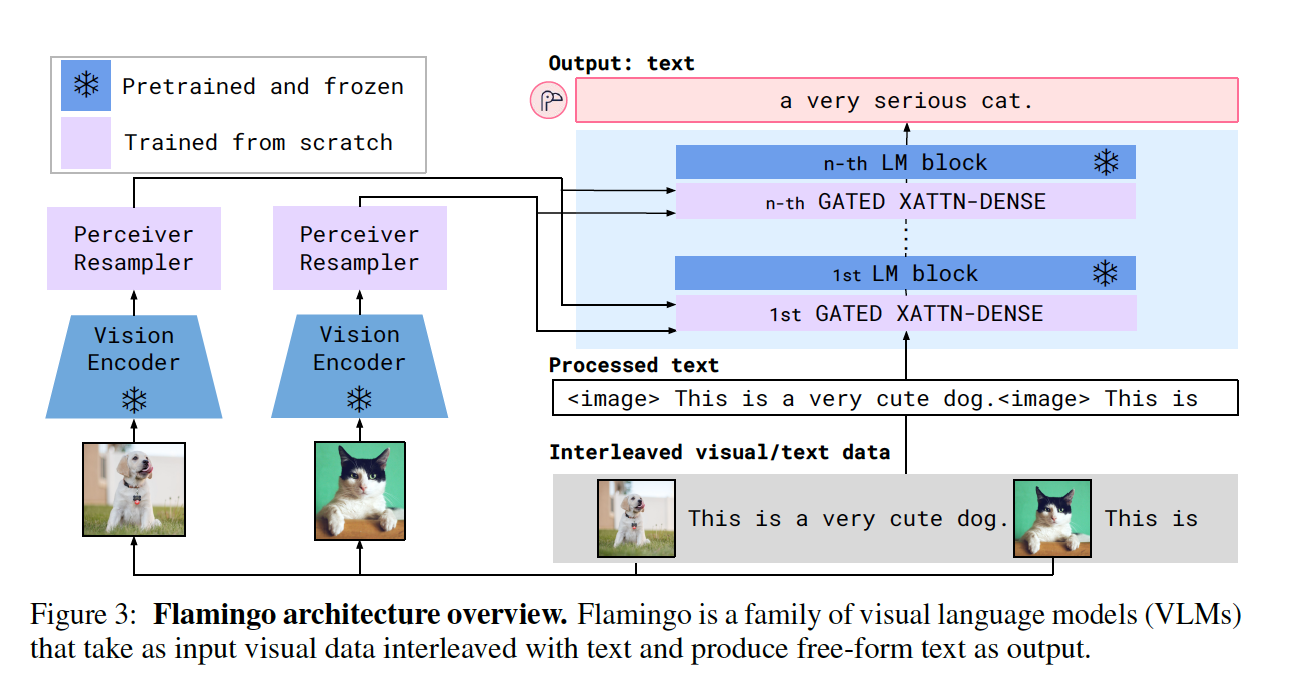
입력된 시각 데이터(이미지/비디오)는 Vision Encoder를 거쳐 Perceiver Resampler로 들어갑니다. 여기서 고정된 개수의 Visual Token으로 변환된 후, LLM 층 사이에 삽입된 GATED XATTN-DENSE 레이어를 통해 언어 모델에 시각 정보가 주입됩니다. 파란색 부분은 학습되지 않는 Frozen 상태, 보라색 부분만 학습되는 파라미터입니다.
2.2 Visual Processing & Perceiver Resampler
Vision Encoder(NFNet)는 시각적 특징을 추출합니다. 하지만 이미지나 비디오의 해상도나 길이에 따라 특징맵의 크기가 달라질 수 있습니다. 이를 해결하기 위해 Perceiver Resampler를 도입했습니다.
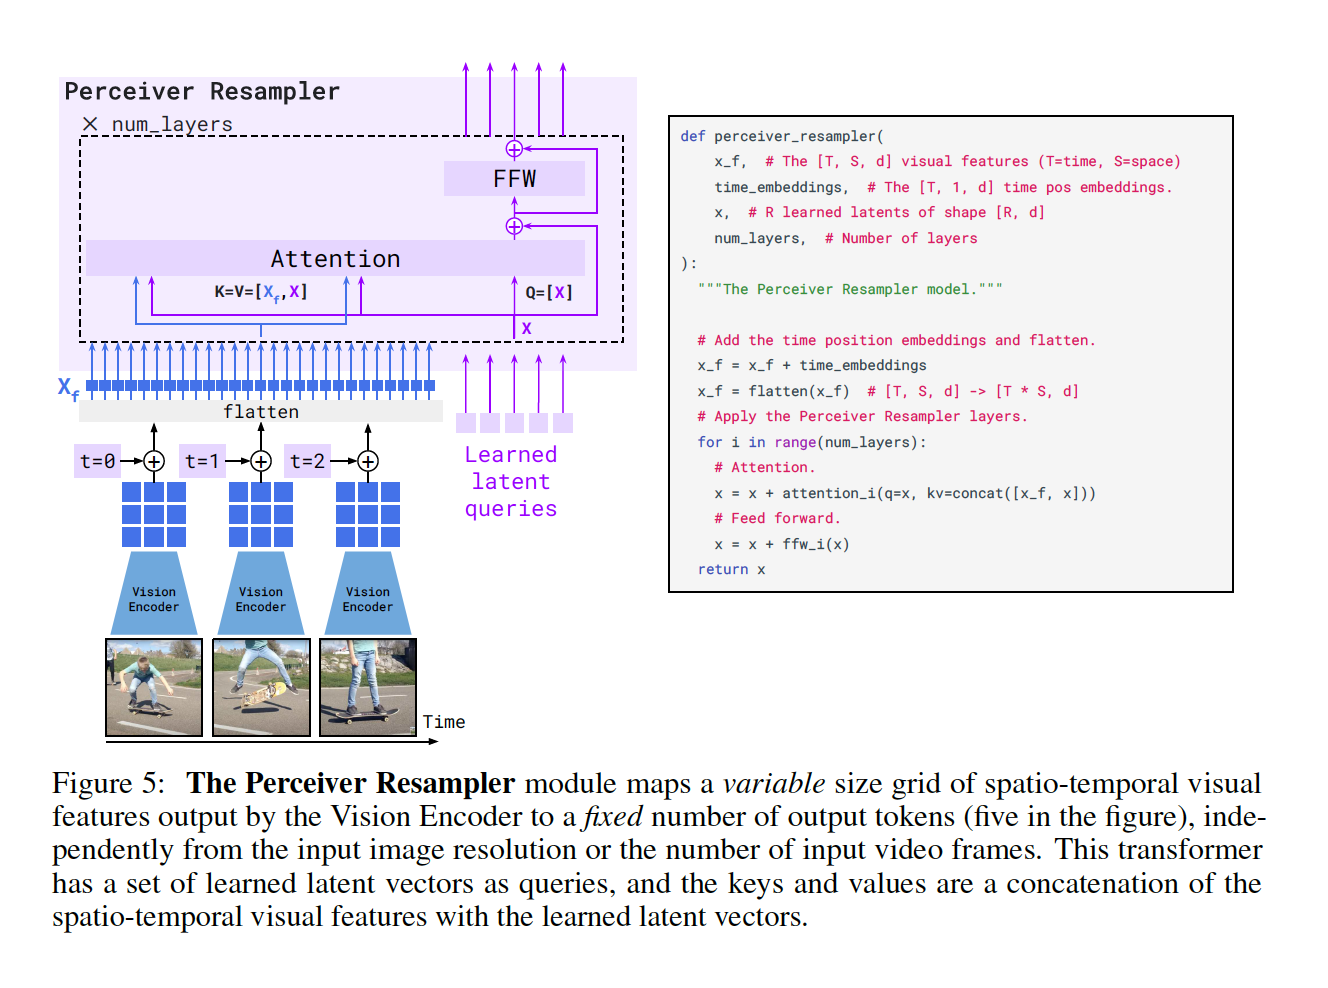
이 모듈은 가변적인 크기의 시각적 특징(Visual features)을 입력받아, 고정된 개수(예: 64개)의 Visual Token으로 변환합니다. 이는 Transformer 기반 구조로, 학습 가능한 Latent Query를 사용하여 시각 정보에서 중요한 부분만 추출합니다. 이를 통해 계산 복잡도를 줄이고 LLM이 시각 정보를 효율적으로 처리하게 합니다.
2.3 GATED XATTN-DENSE & Conditioning
추출된 시각 정보는 LLM이 다음 토큰을 예측할 때 활용됩니다. 이를 위해 기존 LLM 레이어 사이에 새로운 Cross-Attention 레이어를 삽입합니다.
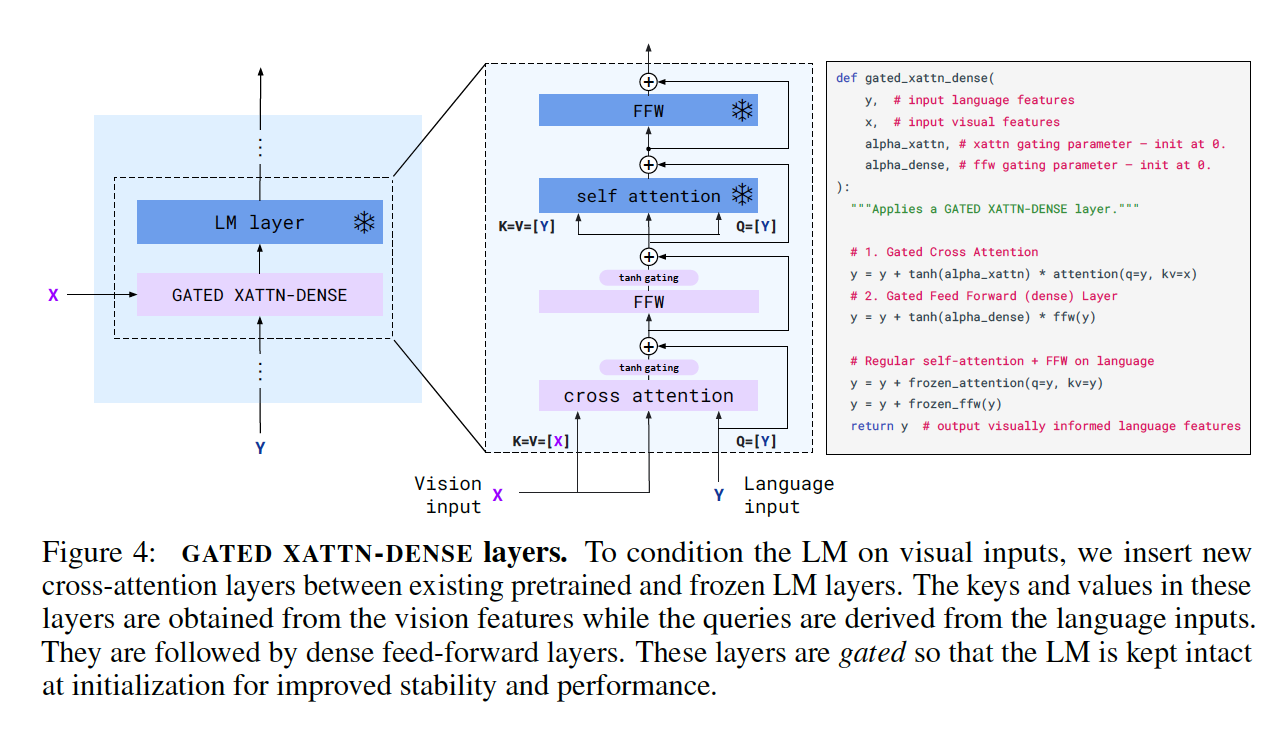
기존 LLM 블록 앞에 Cross-Attention(시각 정보 참조)과 Feed-Forward 레이어를 추가했습니다. 중요한 점은 Tanh Gating 기법을 사용했다는 것입니다.
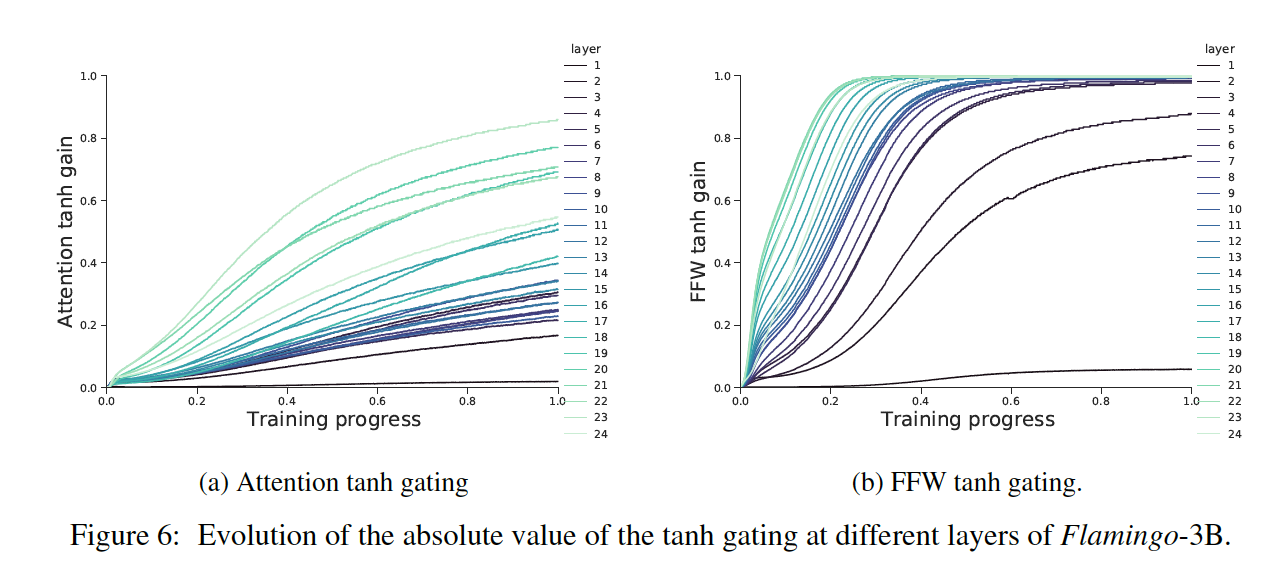
초기에 Tanh 게이트 값은 0으로 설정됩니다. 이는 학습 초기에는 시각 정보를 무시하고 오로지 언어 모델의 원래 성능 그대로 작동하게 하여 학습 안정성을 높입니다. 학습이 진행될수록 게이트 값이 커지며 시각 정보를 받아들입니다.
수식 설명 (Likelihood Modeling):
이 모델은 인터리브 된(섞인) 이미지와 비디오 $x$가 주어졌을 때 텍스트 $y$의 확률을 다음과 같이 모델링합니다.
$$ p(y|x) = \prod_{l=1}^{L} p(y_l \mid y_{<l}, x_{\leq l}) $$
이 수식은 조건부 확률의 연쇄 법칙(Chain Rule)을 나타냅니다.
- $y_l$: 현재 예측하려는 $l$번째 언어 토큰입니다.
- $y_{<l}$: 이전에 생성된 모든 텍스트 토큰들입니다.
- $x_{\le l}$: 현재 텍스트 토큰 $y_l$보다 시퀀스상 이전에 등장한 이미지/비디오들의 집합입니다.
의미: Flamingo는 텍스트를 생성할 때, 텍스트의 문맥($y_{<l}$)뿐만 아니라, 현재 시점 이전에 나왔던 모든 시각 정보($x_{\le l}$)를 조건(Condition)으로 하여 다음 단어를 예측합니다. 이는 자기회귀(Autoregressive) 생성 방식입니다.
2.4 Multi-visual Input & Data
Flamingo는 텍스트와 이미지가 섞인 데이터를 처리하기 위해 특별한 마스킹 기법을 사용합니다.
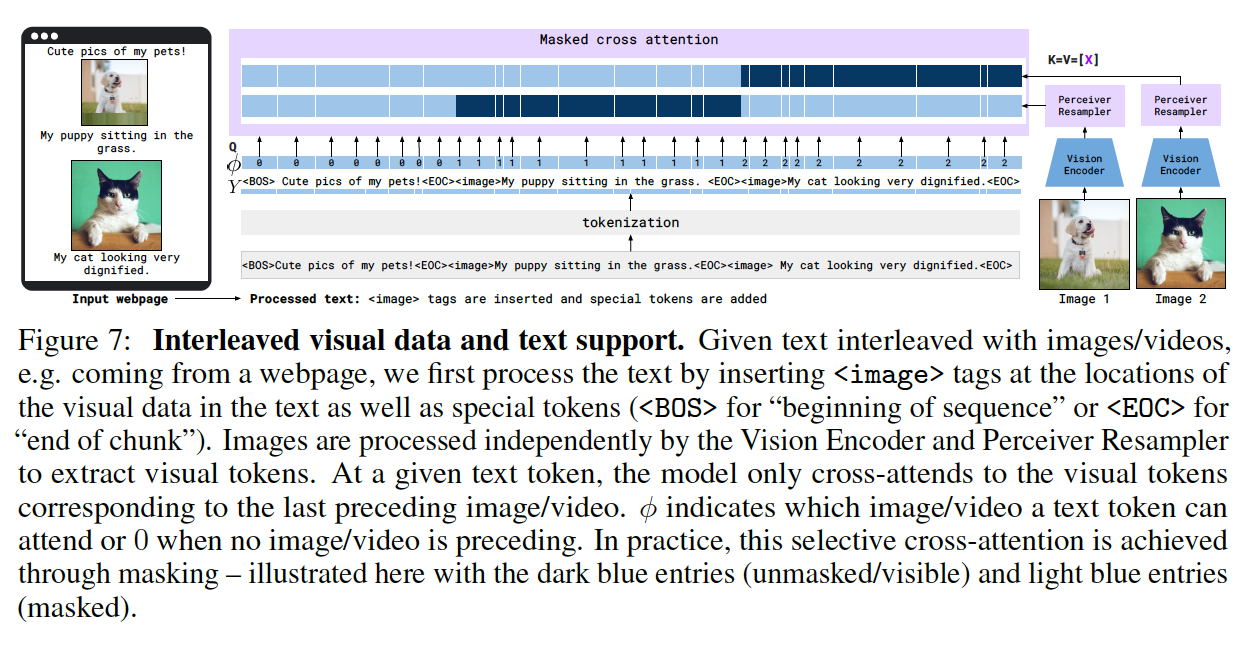
모델은 텍스트 토큰을 예측할 때, 해당 텍스트 직전에 나온 이미지에만 Cross-Attention을 수행하도록 마스킹 처리(진한 파란색) 됩니다. 하지만 Self-Attention(텍스트끼리의 관계)을 통해 전체 문맥은 유지됩니다.
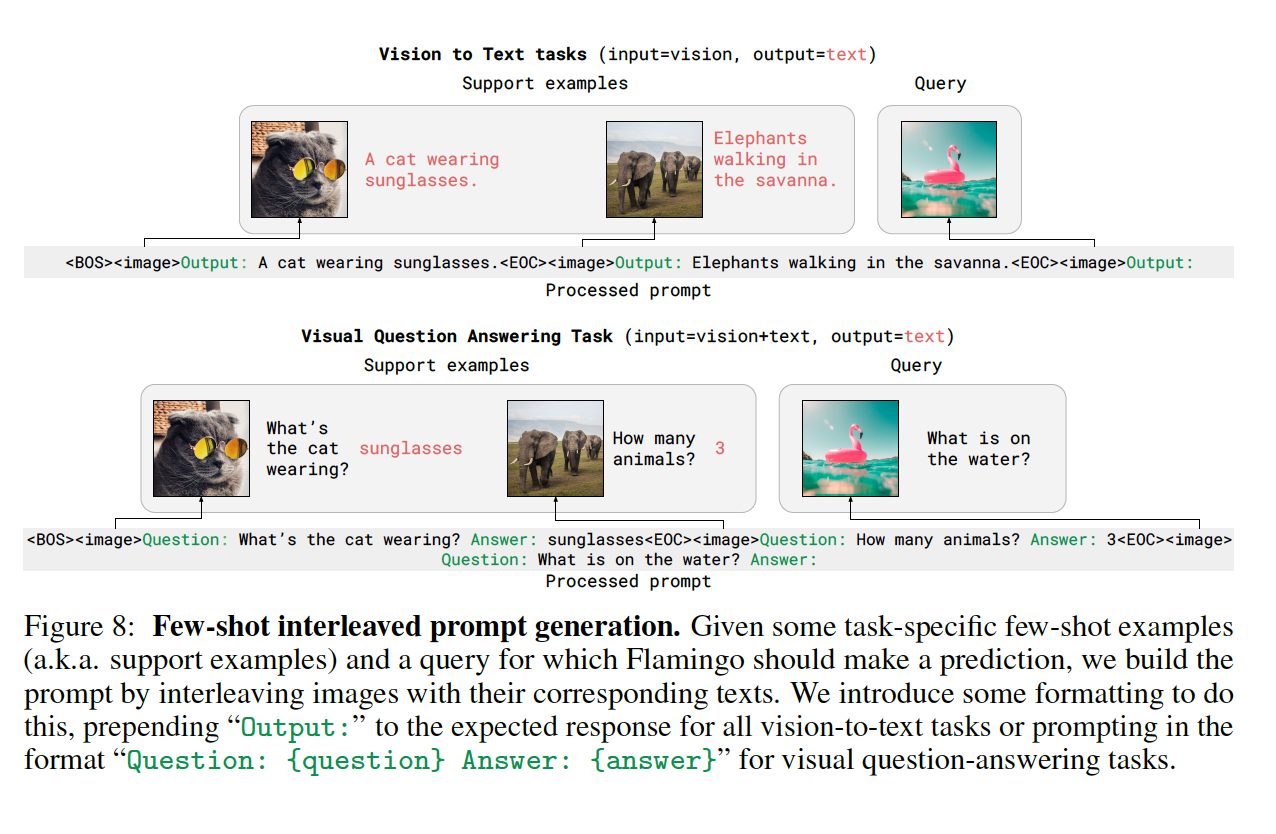
지원 예제(Support examples) 이미지와 텍스트를 나열하고, 마지막에 쿼리(Query) 이미지를 붙여 모델이 답을 생성하게 유도하는 구조를 보여줍니다.
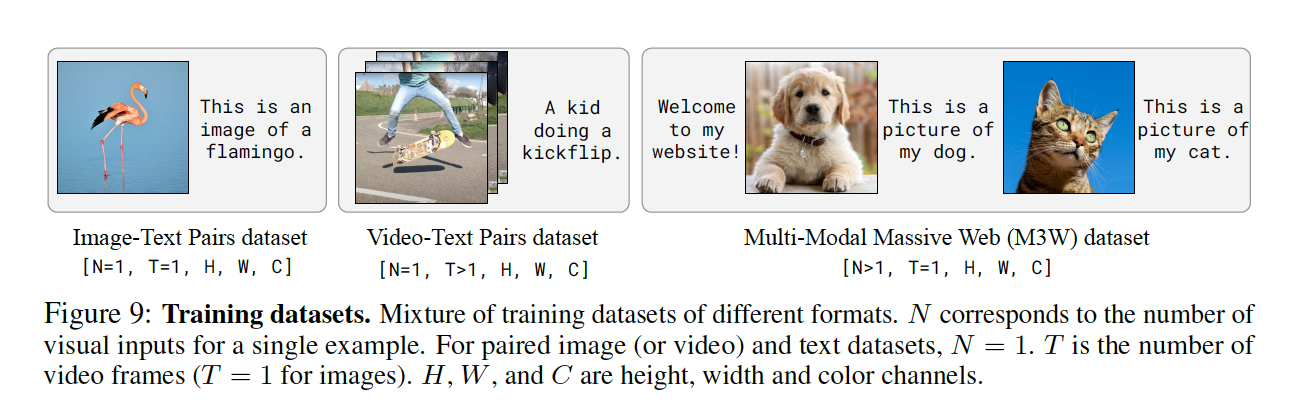
- M3W: 웹페이지에서 수집한 이미지-텍스트가 섞인 데이터 (Few-shot 능력의 핵심).
- Image-Text Pairs (ALIGN, LTIP): 이미지와 캡션 쌍.
- Video-Text Pairs (VTP): 비디오와 캡션 쌍.
3. 실험 (Experiments)
실험은 Flamingo가 얼마나 적은 데이터로 새로운 태스크에 적응하는지, 그리고 SOTA 모델들과 비교해 어떤 성능을 내는지를 중점적으로 다룹니다.
3.1 Few-Shot Learning 성능
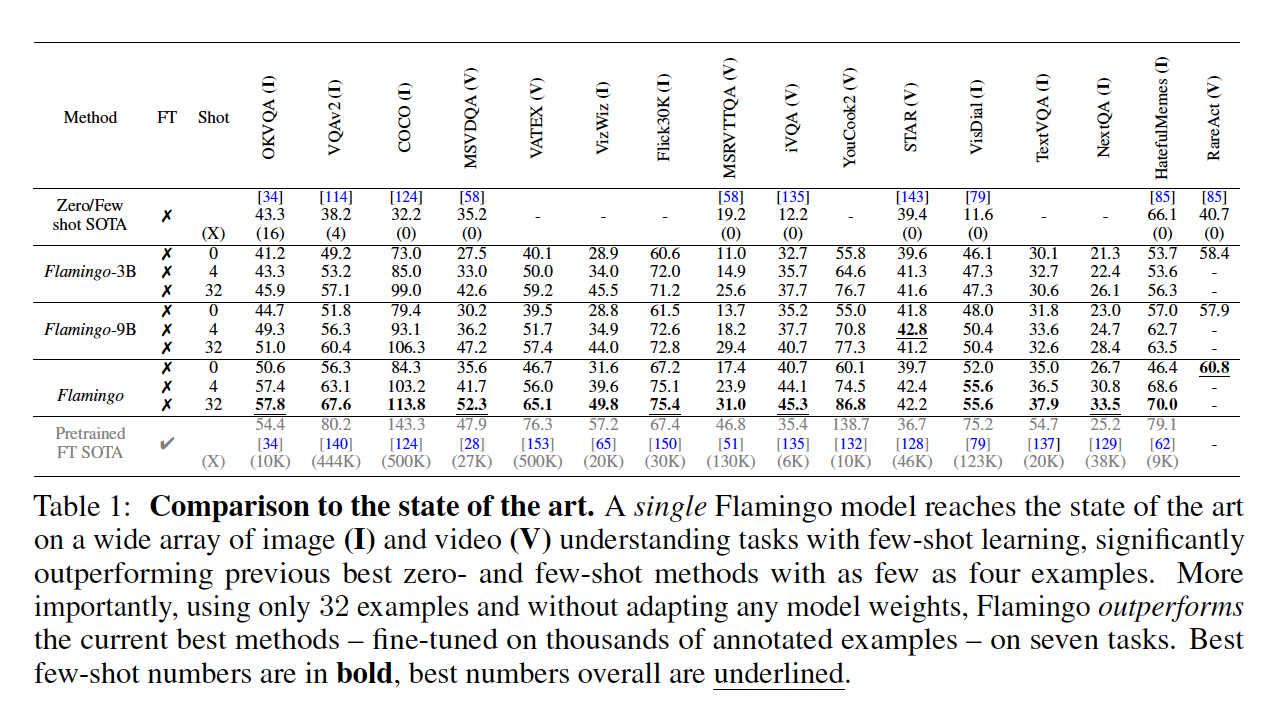
Flamingo는 단 4개의 Shot만으로도 이전의 Zero/Few-shot SOTA를 압도합니다. 특히 6개의 태스크에서는 수천~수십만 개의 데이터로 Fine-tuning 된 모델들보다 32-shot Flamingo가 더 높은 성능을 기록했습니다. 이는 데이터 효율성 측면에서 혁신적인 결과입니다.
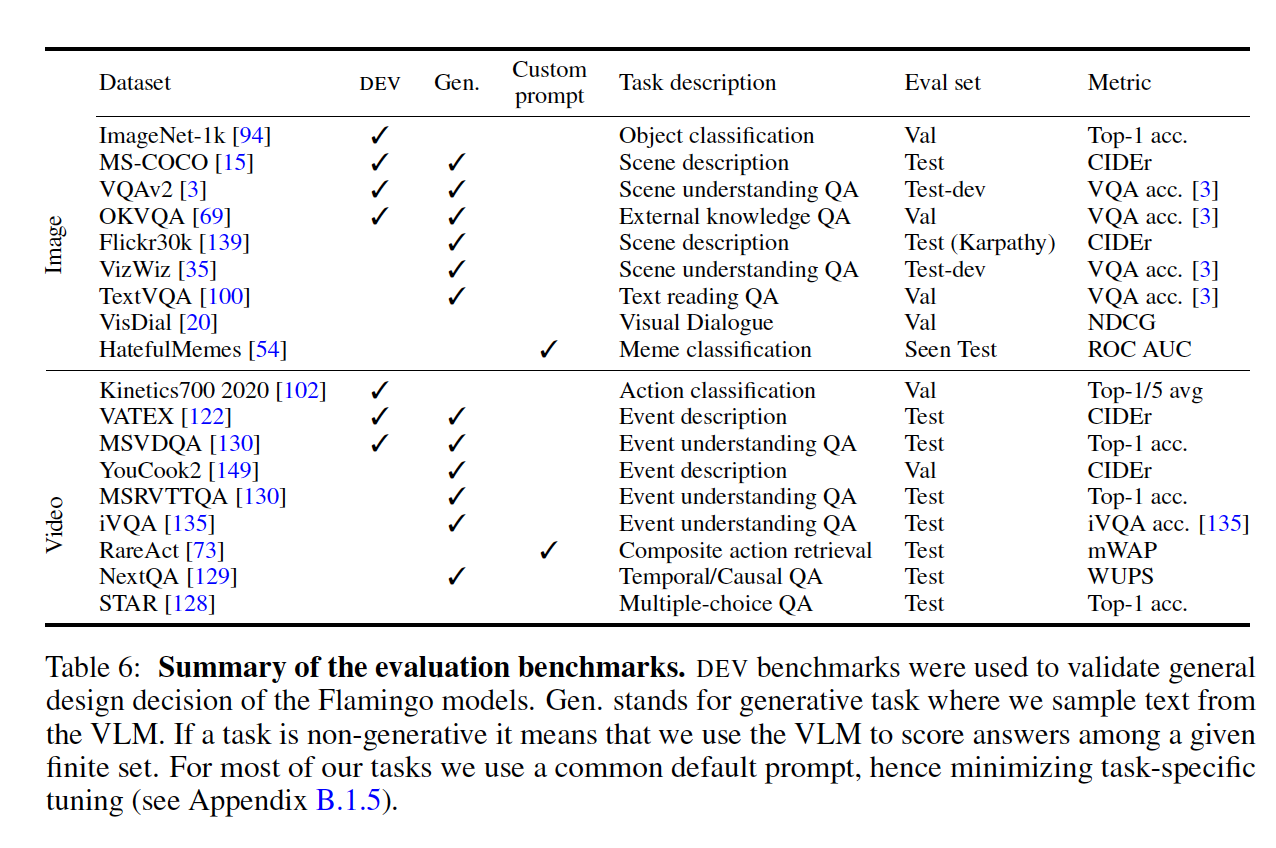
3.2 Fine-tuning & Classification
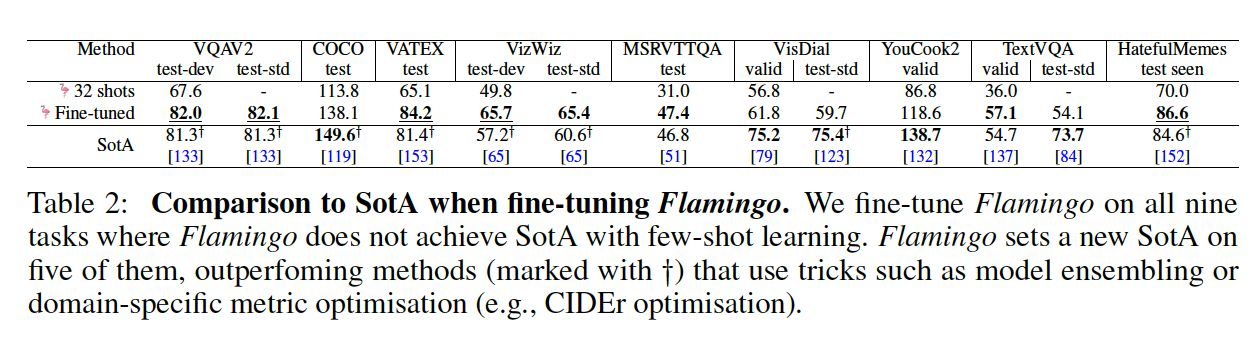
데이터를 충분히 주고 학습시키면 VQAv2, VATEX 등 5개 태스크에서 새로운 SOTA를 달성함을 보여줍니다.
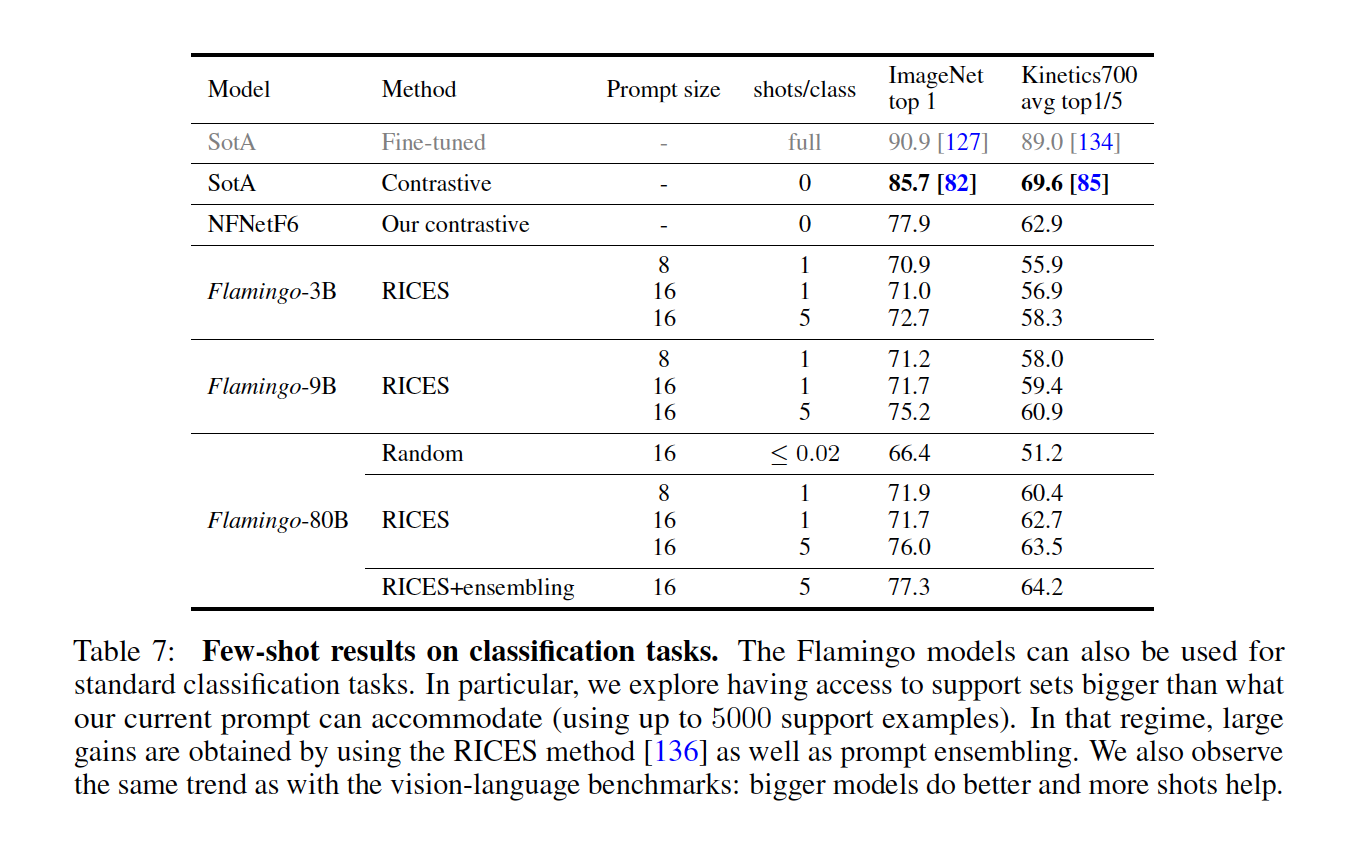
Contrastive 모델보다는 다소 성능이 떨어지지만, RICES(유사한 예시를 검색해서 프롬프트에 넣는 방법)를 사용하면 성능이 크게 향상됨을 보여줍니다.
3.3 Ablation Studies (소거 연구)
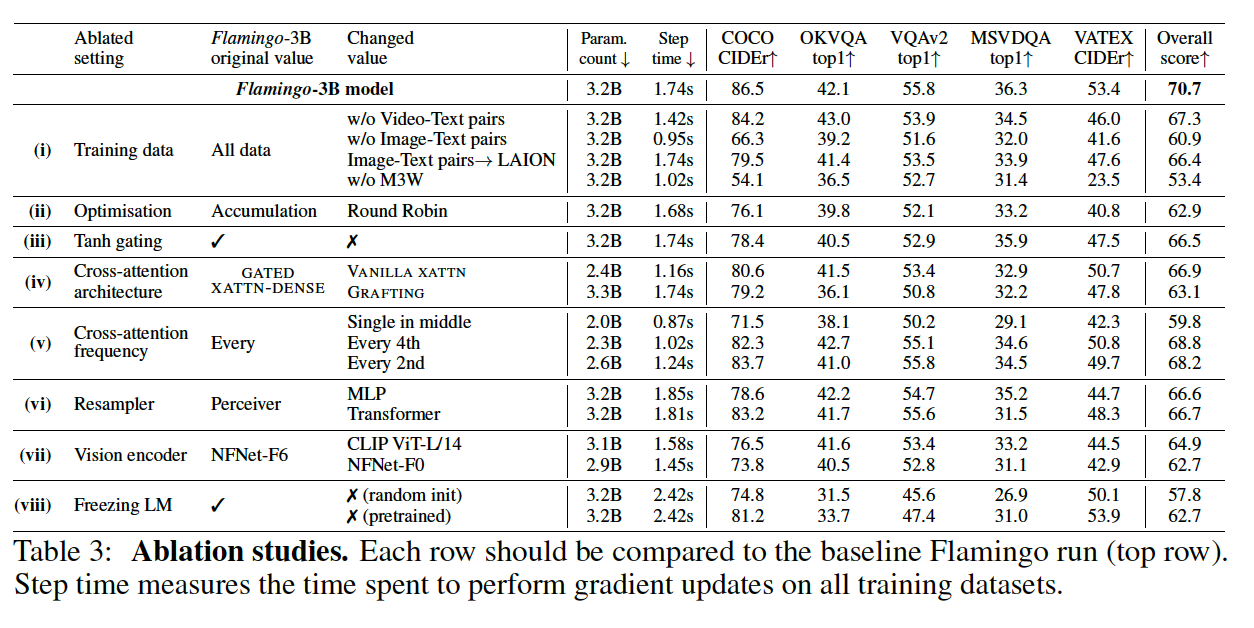
- M3W(인터리브 데이터)가 없으면 성능이 17% 하락합니다.
- Tanh gating이 없으면 학습이 불안정하고 성능이 떨어집니다.
- Perceiver Resampler가 MLP나 바닐라 Transformer보다 효율적이고 성능이 좋습니다.
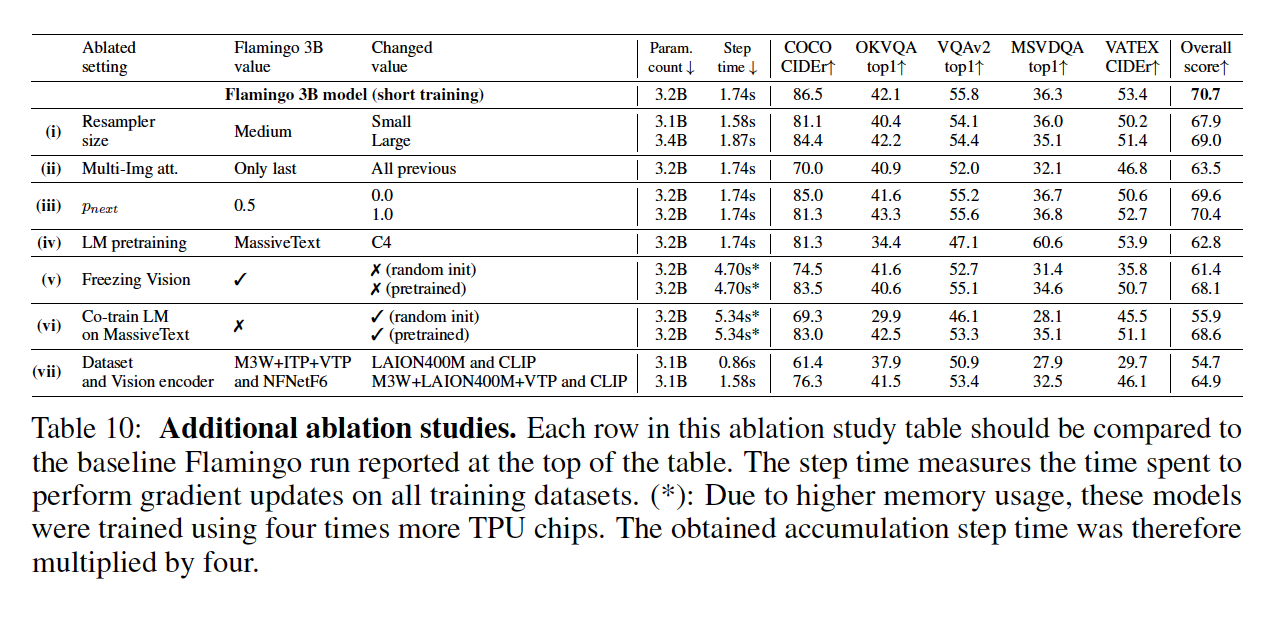
Resampler의 크기, Multi-image attention 방식, LM 사전 학습 데이터(C4 vs MassiveText) 등의 영향을 분석합니다.
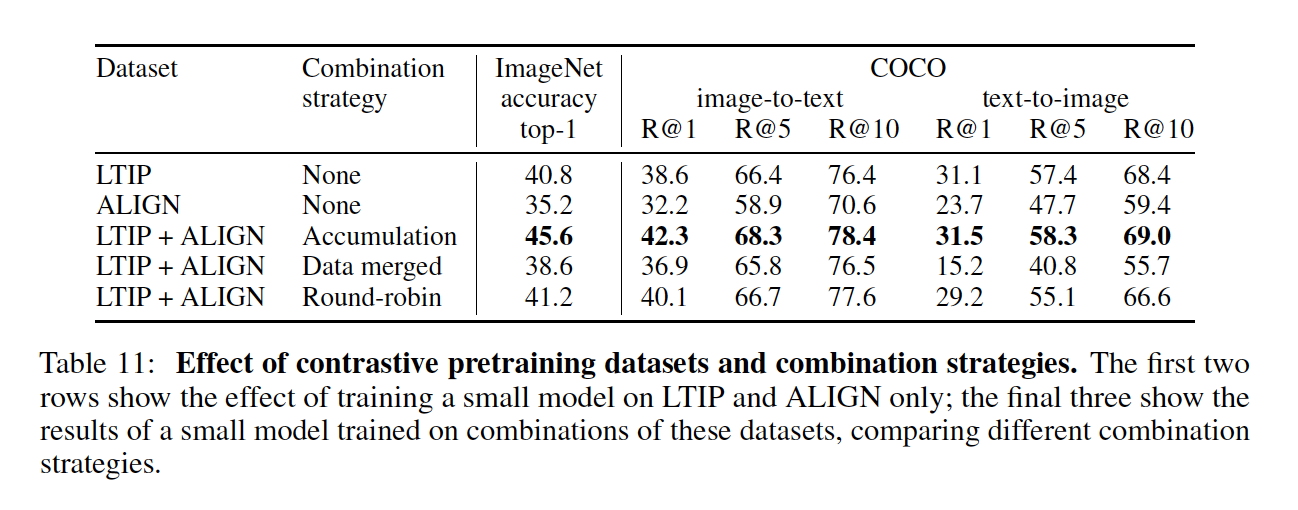
데이터의 양보다 질(LTIP 데이터셋)이 중요하며, 여러 데이터셋을 합칠 때 단순 병합보다 Gradient Accumulation 방식이 더 효과적임을 보여줍니다.
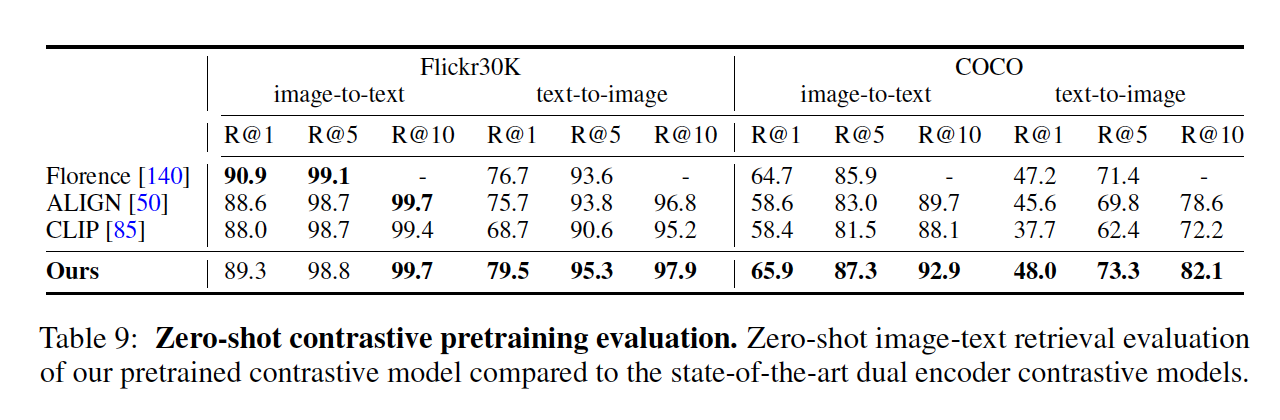
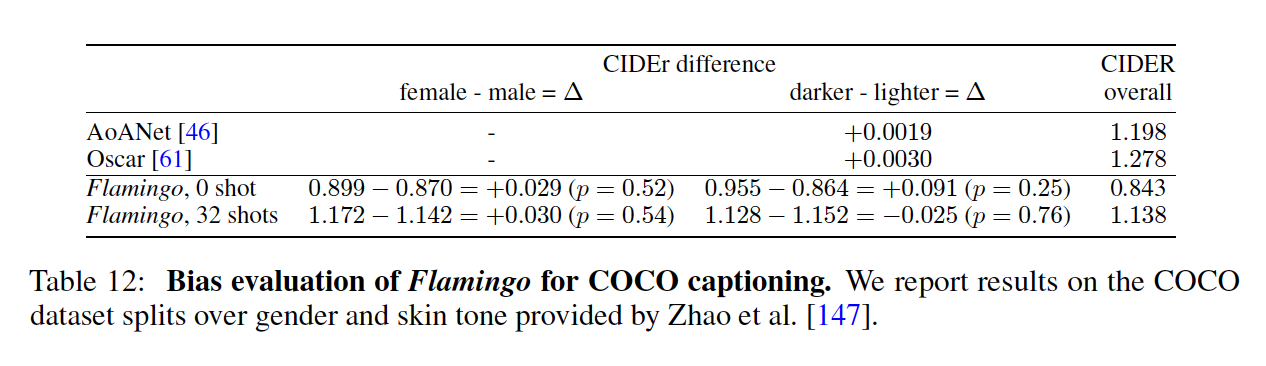
성별이나 피부색에 따른 성능 차이가 통계적으로 유의미하지 않음(p-value > 0.05)을 보여줍니다.
4. 결론 (Conclusion)
Flamingo는 거대 언어 모델(LLM)과 시각 모델을 효과적으로 연결하여, 최소한의 학습 데이터(Few-shot)만으로 다양한 멀티모달 태스크를 수행할 수 있는 범용 모델입니다.
- 핵심 기여: Perceiver Resampler와 GATED XATTN-DENSE를 도입하여 시각-언어 간의 간극을 줄였고, M3W 데이터셋을 통해 인터리브 데이터 처리 능력을 확보했습니다.
- 의의: 별도의 파인 튜닝 없이도 프롬프트만으로 시각적 질문 응답, 캡션 생성, 대화 등이 가능함을 입증하여, 범용 인공지능(AGI)으로 가는 중요한 발판을 마련했습니다.