1. 서론
객체 탐지란 이미지 속에서 우리가 관심 있는 물체(객체)가 무엇인지(분류, classification) 그리고 어디에 있는지(위치 파악, localization)를 알아내는 기술입니다. 예를 들어, 자율주행 자동차가 도로 위의 사람, 다른 자동차, 신호등을 정확히 인식하는 데 이 기술이 사용됩니다.
기존의 객체 탐지 모델들은 이 문제를 약간 간접적인 방식으로 풀어왔습니다. 이미지 위에 수많은 가상의 사각형(앵커 박스, anchor box)이나 **후보 영역(proposal)**을 미리 뿌려놓고, 이 중에서 어떤 사각형이 실제 물체를 잘 감싸고 있는지, 그리고 그 물체는 무엇인지를 맞추는 방식이었습니다. 이 방법은 꽤 성공적이었지만 몇 가지 번거로운 과정이 필요했습니다.
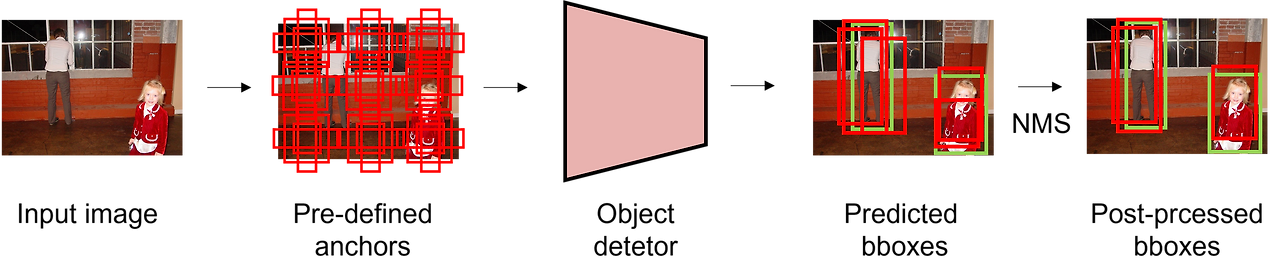
- 수작업 설계 (Hand-designed components): 앵커 박스의 크기나 비율을 미리 정해야 하는 등 사람이 직접 설정해야 하는 부분이 많았습니다.
- 후처리 (Post-processing): 모델이 하나의 물체에 대해 여러 개의 겹치는 박스를 예측하는 경우가 많아서, 이 중 가장 정확한 박스 하나만 남기는 **‘비최대 억제(Non-Maximum Suppression, NMS)’**라는 복잡한 후처리 과정이 필수적이었습니다.
이 논문에서 제안하는 DETR (DEtection TRansformer) 은 이러한 복잡한 과정들을 모두 없애고, 객체 탐지를 “정답 집합을 한 번에 예측하는 문제"로 재정의했습니다. 마치 사람이 이미지를 한 번 쓱 보고 “여기엔 고양이 한 마리, 저기엔 강아지 두 마리가 있네"라고 말하는 것처럼, 모델이 직접 최종 예측 결과의 **‘집합(set)’**을 출력하도록 만든 것입니다.
이러한 혁신은 두 가지 핵심 요소 덕분에 가능했습니다.
- 이분 매칭 손실 (Bipartite Matching Loss): 모델의 예측 결과와 실제 정답을 일대일로 짝지어주는 손실 함수입니다. 이를 통해 중복된 예측을 자연스럽게 방지합니다.
- 트랜스포머 (Transformer) 구조: 원래 번역 분야에서 뛰어난 성능을 보인 아키텍처로, 이미지 전체의 맥락을 종합적으로 이해하는 데 탁월한 능력을 보입니다.
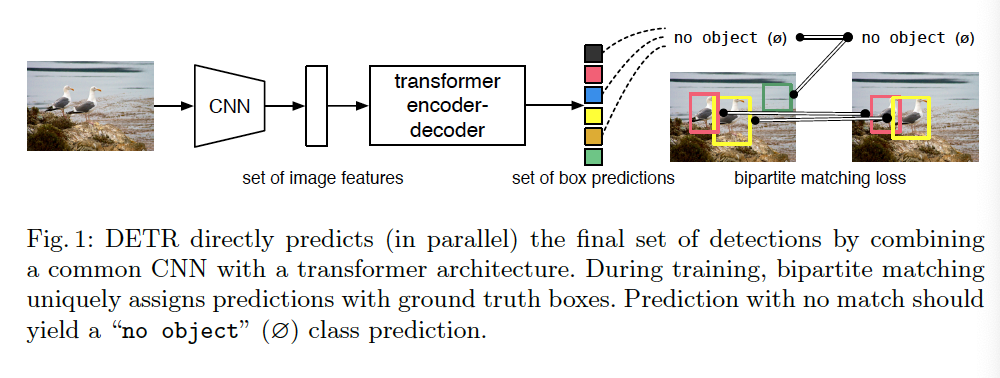
위 그림은 DETR의 전체적인 흐름을 보여줍니다.
- 먼저, 일반적인 CNN을 사용해 이미지의 특징(feature)을 추출합니다. 이는 이미지의 중요한 시각적 정보를 압축하는 과정입니다.
- 이 특징 정보를 트랜스포머 인코더-디코더에 입력합니다. 트랜스포머는 이미지 전체의 관계를 파악하여 고정된 개수의 예측 상자(box prediction) 집합을 출력합니다.
- 학습 과정에서는 **이분 매칭 손실(bipartite matching loss)**을 사용해 모델이 예측한 상자들과 실제 정답 상자들을 가장 효율적으로 일대일 매칭시킵니다. 매칭되지 못한 예측 상자는 **“물체 없음(no object)”**으로 학습됩니다.
2. 기술 설명 (The DETR model)
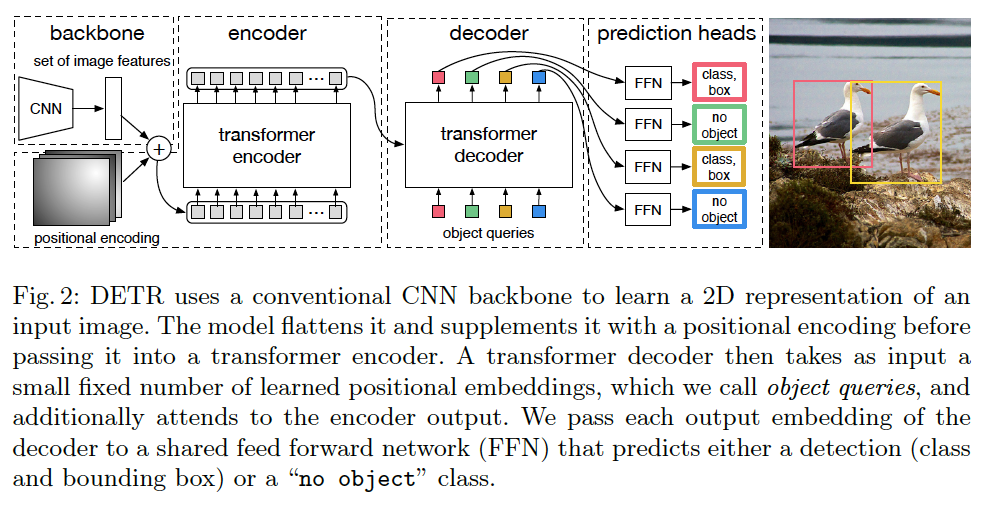
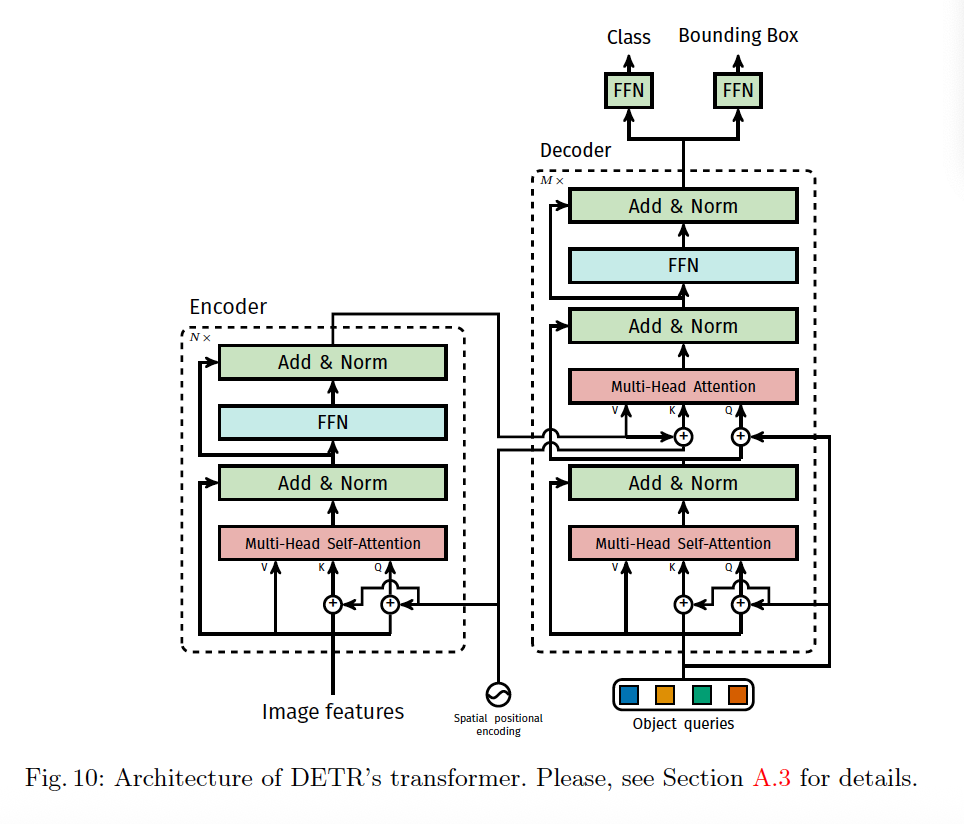
위 그림은 DETR의 상세한 구조를 보여줍니다.
백본 (Backbone)
ResNet과 같은 표준 CNN 모델을 사용하여 이미지에서 저해상도의 특징 맵(feature map)을 추출합니다. 예를 들어, 2048개의 채널을 가진 특징 맵을 만들어냅니다.
트랜스포머 인코더 (Transformer Encoder)
- CNN이 만든 특징 맵은 2D 형태인데, 트랜스포머에 넣기 위해 1D 시퀀스(순서가 있는 데이터) 형태로 길게 펼칩니다.
- 각 특징의 위치 정보를 알려주기 위해 **공간적 위치 인코딩(spatial positional encoding)**을 더해줍니다. 트랜스포머는 본래 순서 개념이 없기 때문에, “이 특징은 이미지의 왼쪽 위에 있다"와 같은 위치 정보를 인위적으로 주입해야 합니다.
- 인코더는 셀프 어텐션(self-attention) 메커니즘을 통해 이미지의 모든 픽셀 영역들이 서로 어떻게 연관되어 있는지를 학습합니다. 예를 들어, 이미지에 얼룩말 두 마리가 있다면, 인코더는 얼룩말 무늬를 가진 픽셀들이 서로 강하게 연관되어 있음을 파악하고, 각 얼룩말을 별개의 개체로 분리해내는 역할을 합니다.
트랜스포머 디코더 (Transformer Decoder)
객체 쿼리란? - 100명의 전문 탐정단
DETR의 **객체 쿼리(object queries)**를 가장 쉽게 이해하는 방법은, 이미지를 ‘사건 현장’이라고 보고 100명의 전문 탐정단이 각자 빈 수첩(=객체 쿼리)을 들고 파견된다고 상상하는 것입니다.
- 이 탐정들은 처음에는 아무 정보도 없는 상태(빈 수첩)로 시작하지만, 학습을 거치며 각자 자신만의 전문 분야(특정 위치, 크기, 형태 등)를 갖게 됩니다.
- 각 탐정(객체 쿼리)은 이미지 전체(인코더의 출력)를 샅샅이 살피며, 자신이 맡을 단서(객체)를 찾으려고 합니다.
- 탐정들끼리도 계속 정보를 공유(셀프 어텐션)하여, 한 명이 하나의 단서만 맡도록 역할을 분담합니다. 이 덕분에 하나의 물체에 여러 박스가 중복 예측되는 문제가 자연스럽게 해결됩니다(NMS 불필요).
디코더에서의 객체 쿼리 역할:
- 디코더는 이미지 특징을 직접 받는 대신, **객체 쿼리(object queries)**라는 고정된 개수(N=100)의 학습 가능한 임베딩을 입력으로 받습니다. 이 객체 쿼리는 “이미지에서 찾을 N개의 물체 슬롯"이자, ‘사건 현장에 파견된 100명의 탐정’에 해당합니다. 처음에는 빈 슬롯(빈 수첩)이지만, 학습을 통해 각각 특정 위치나 크기의 물체를 찾는 데 특화됩니다.
- 디코더는 이 객체 쿼리들과 인코더의 출력(이미지 전체의 문맥 정보)을 함께 사용하여 “물체가 어디에 있는지"를 추론합니다. 디코더의 셀프 어텐션은 N개의 예측 간의 관계를 모델링하여, 예를 들어 하나의 물체에 대해 여러 슬롯이 중복으로 예측하는 것을 억제하는 역할을 합니다(탐정들끼리 역할 분담).
- 하나의 중요한 특징은 이 N개의 객체를 병렬적으로(in parallel), 즉 한 번에 디코딩한다는 점입니다. 기존 트랜스포머가 단어를 하나씩 순서대로 생성하는 것과 대조적입니다.
예측 헤드 (Prediction Heads, FFNs)
- 디코더에서 나온 N개의 출력 임베딩은 각각 동일한 구조를 공유하는 작은 신경망(FFN)으로 전달됩니다.
- 이 FFN은 최종적으로 각 슬롯에 대해 물체의 **클래스(class)**와 바운딩 박스(bounding box) 좌표를 예측합니다. 만약 해당 슬롯이 찾은 물체가 없다면, **“물체 없음(no object)”**이라는 특별한 클래스를 예측하게 됩니다.
손실 함수 (Loss Function): 객체 탐지를 위한 집합 예측
DETR의 핵심 아이디어는 예측과 정답을 ‘집합 대 집합’으로 보고, 둘 사이의 최적의 짝을 찾아 손실을 계산하는 것입니다.
이분 매칭 (Bipartite Matching)
모델이 100개의 예측(집합 $\hat{y}$)을 내놓고, 실제 이미지에는 5개의 물체(정답 집합 y)가 있다고 가정해 봅시다. 100개의 예측 중 어떤 것이 5개의 정답 각각에 해당하는지를 결정해야 합니다. 이때 **헝가리안 알고리즘(Hungarian Algorithm)**을 사용하여 전체 매칭 비용이 최소가 되는 최적의 일대일 짝(optimal assignment)을 찾습니다.
이 매칭 비용 $\mathcal{L}_{match}$는 두 가지를 고려합니다: (1) 예측한 클래스가 정답 클래스와 일치할 확률, (2) 예측한 박스가 정답 박스와 얼마나 비슷한지.
수식 1: 최적 할당 (Optimal Assignment)
최적의 순열(permutation)
수식 2: 헝가리안 손실 (Hungarian Loss)
- 클래스 예측 손실:$-\log\hat{p}_{\hat{\sigma}(i)}(c_{i})$는 표준적인 교차 엔트로피(cross-entropy) 손실입니다. 즉, 최적의 짝으로 매칭된 예측이 정답 클래스$c_i$를 얼마나 정확하게 예측했는지를 측정합니다.
- 박스 손실:$\mathbf{1}_{{c_{i}\ne\emptyset}}\mathcal{L}_{\text{box}}(...)$는 바운딩 박스에 대한 손실입니다.$\mathbf{1}_{{c_{i}\ne\emptyset}}$는 정답이 ‘물체 없음’이 아닐 경우에만 박스 손실을 계산하라는 의미의 지시 함수(indicator function)입니다.$\mathcal{L}_{\text{box}}$는 아래에서 설명할 L1 손실과 GIoU 손실의 조합으로 이루어집니다.
바운딩 박스 손실 ($\mathcal{L}_{box}$)
기존의 L1 손실(좌표 차이의 절댓값 합)은 박스가 클 때 손실 값도 커지는 문제가 있어, 박스 크기에 따라 손실의 스케일이 달라집니다. 이를 해결하기 위해 DETR은 두 가지 손실을 조합합니다.
- L1 손실: 예측 박스와 정답 박스의 중심점 좌표, 너비, 높이 간의 차이를 계산합니다.
- 일반화된 IoU (GIoU) 손실: 두 박스가 얼마나 겹치는지를 나타내는 IoU(Intersection over Union)를 일반화한 것으로, 박스 크기에 무관하게(scale-invariant) 손실을 측정할 수 있어 작은 물체와 큰 물체를 공평하게 학습할 수 있습니다.
수식 예시로 이해하기: “고양이와 강아지 찾기"로 풀어보는 DETR의 집합 예측
지금까지 소개한 수식들을 실제 객체 탐지 상황에 대입해, 처음부터 끝까지 하나의 흐름으로 예시를 들어 설명해보겠습니다.
상황 예시: 이미지 속 고양이와 강아지
- 입력 이미지: 왼쪽에는 고양이 한 마리, 오른쪽에는 강아지 한 마리가 있는 사진
- DETR 모델: 최대 4개($N=4$)의 객체를 예측하도록 설정
1. 정답(Ground Truth)과 모델의 예측
정답 집합 (y):
- GT1: {클래스: ‘고양이’, 박스:
b_cat} - GT2: {클래스: ‘강아지’, 박스:
b_dog} - GT3: {클래스: ‘없음 ∅’}
- GT4: {클래스: ‘없음 ∅’}
- GT1: {클래스: ‘고양이’, 박스:
모델의 예측 집합 (ŷ):
- P1: {‘고양이’ 확률 0.9, 박스:
b_p1} (고양이와 매우 비슷하게 예측) - P2: {‘강아지’ 확률 0.8, 박스:
b_p2} (강아지와 매우 비슷하게 예측) - P3: {‘고양이’ 확률 0.7, 박스:
b_p3} (P1과 중복된, 덜 정확한 고양이 예측) - P4: {‘없음 ∅’ 확률 0.85, 박스:
b_p4} (스스로 ‘없음’이라고 예측)
- P1: {‘고양이’ 확률 0.9, 박스:
2. 수식 1: 최적의 짝 찾기 (Optimal Assignment)
$\hat{\sigma} = \underset{\sigma \in \mathfrak{S}_N}{\arg\min} \sum_{i}^{N} \mathcal{L}_{\text{match}}(y_i, \hat{y}_{\sigma(i)})$
이 단계에서는 4개의 정답과 4개의 예측 사이에서 가장 합리적인 일대일 짝을 찾습니다.
비용(
컴퓨터는 아래와 같은 비용 행렬을 만듭니다(실제 값은 예시):
| 예측 P1 (고양이 0.9) | 예측 P2 (강아지 0.8) | 예측 P3 (고양이 0.7) | 예측 P4 (없음 0.85) | |
|---|---|---|---|---|
| GT1 (고양이) | 비용 낮음 | 비용 높음 | 비용 중간 | 비용 높음 |
| GT2 (강아지) | 비용 높음 | 비용 낮음 | 비용 높음 | 비용 높음 |
| GT3 (없음 ∅) | 비용 중간 | 비용 중간 | 비용 중간 | 비용 중간 |
| GT4 (없음 ∅) | 비용 중간 | 비용 중간 | 비용 중간 | 비용 중간 |
헝가리안 알고리즘이 이 표를 분석해 전체 비용이 최소가 되는 조합을 찾습니다.
결과적으로 다음과 같은 짝(
- GT1 (‘고양이’) ↔️ P1 (가장 정확한 고양이 예측)
- GT2 (‘강아지’) ↔️ P2 (가장 정확한 강아지 예측)
- GT3 (‘없음 ∅’) ↔️ P3 (중복된 고양이 예측은 ‘없음’ 처리)
- GT4 (‘없음 ∅’) ↔️ P4 (쓸모없는 예측은 ‘없음’ 처리)
3. 수식 2: 최종 손실 계산 (Hungarian Loss)
$\mathcal{L}_{\text{Hungarian}}(y, \hat{y}) = \sum_{i=1}^{N} \left[ -\log\hat{p}_{\hat{\sigma}(i)}(c_i) + \mathbf{1}_{c_i \ne \emptyset} \mathcal{L}_{\text{box}}(b_i, \hat{b}_{\hat{\sigma}(i)}) \right]$
위에서 찾은 짝을 바탕으로, 각 쌍에 대해 손실을 계산합니다.
- [GT1↔P1]
- 클래스 손실: 고양이 확률 0.9 →$-\log(0.9)$(낮은 손실)
- 박스 손실: 실제 고양이 박스와 예측 박스의 차이($\mathcal{L}_{box}$)
- 클래스 손실: 고양이 확률 0.9 →
- [GT2↔P2]
- 클래스 손실: 강아지 확률 0.8 →$-\log(0.8)$(낮은 손실)
- 박스 손실: 실제 강아지 박스와 예측 박스의 차이($\mathcal{L}_{box}$)
- 클래스 손실: 강아지 확률 0.8 →
- [GT3↔P3]
- 클래스 손실: 정답은 ‘없음’, 예측이 ‘없음’일 확률이 10%라면$-\log(0.1)$(매우 큰 손실)
- 박스 손실: 정답이 ‘없음’이므로 계산하지 않음(0점)
- 클래스 손실: 정답은 ‘없음’, 예측이 ‘없음’일 확률이 10%라면
- [GT4↔P4]
- 클래스 손실: 정답은 ‘없음’, 예측이 ‘없음’일 확률이 85%라면$-\log(0.85)$(낮은 손실)
- 박스 손실: 정답이 ‘없음’이므로 계산하지 않음(0점)
- 클래스 손실: 정답은 ‘없음’, 예측이 ‘없음’일 확률이 85%라면
이렇게 네 쌍의 손실을 모두 더한 값이 최종 손실이 되어, 모델이 더 똑똑해지도록 학습에 사용됩니다.
4. 바운딩 박스 손실($\mathcal{L}_{box}$)의 실제 의미
$\mathcal{L}_{\text{box}} = \lambda_{\text{iou}}\mathcal{L}_{\text{iou}} + \lambda_{L1}||\cdot||_1$
L1 손실: 예측 박스와 실제 박스의 좌표(x, y, w, h) 차이의 절댓값 합
- 예) 고양이 박스와 예측 박스가 각각 (10,10,50,50), (12,11,48,52)라면, L1 손실은$|10-12|+|10-11|+|50-48|+|50-52|=2+1+2+2=7$
- 단점: 큰 물체와 작은 물체에 동일한 픽셀 오차가 들어가면 불공평함
- 예) 고양이 박스와 예측 박스가 각각 (10,10,50,50), (12,11,48,52)라면, L1 손실은
GIoU 손실: 두 박스가 얼마나 겹치는지(Intersection over Union, IoU)를 일반화한 값
- 예) 고양이 박스와 예측 박스가 거의 겹치면 GIoU 손실이 매우 작음(정확)
- 장점: 박스 크기에 상관없이 공평하게 평가
최종 조합: GIoU 손실로 전체적인 위치와 크기 일치도를, L1 손실로 미세한 위치 조정을 동시에 학습
이처럼 DETR의 집합 예측 손실은
- 중복 예측을 방지하고,
- 박스 크기에 상관없이 공평하게 평가하며,
- 후처리(NMS) 없이도 정확한 객체 탐지가 가능하도록 설계되어 있습니다.
3. 실험 (Experiments)
DETR의 성능을 검증하기 위해 가장 널리 사용되는 COCO 데이터셋으로 다양한 실험을 진행했습니다.
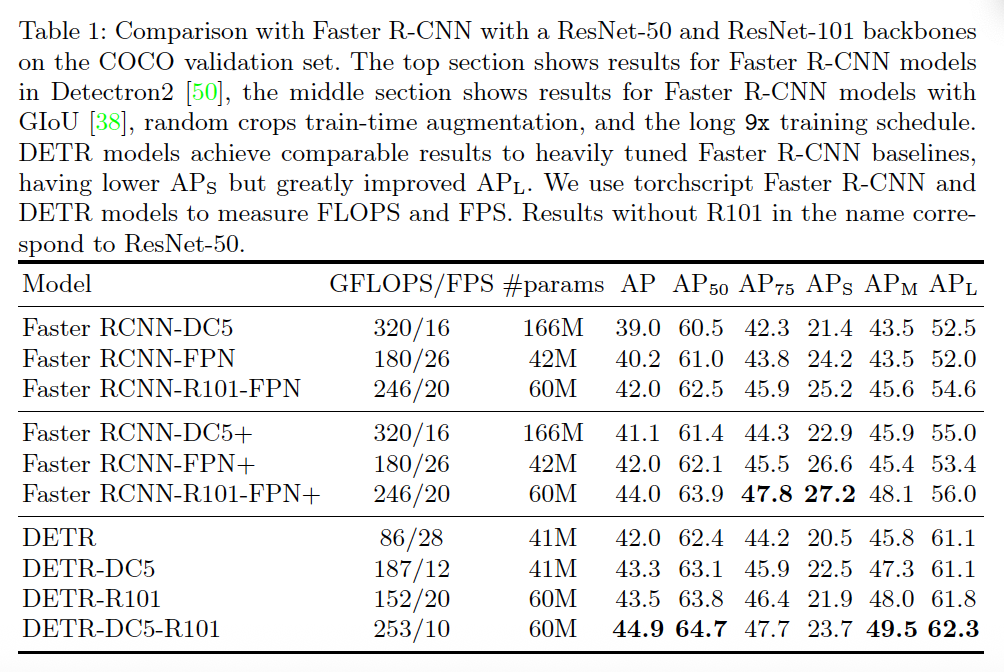
이 표는 DETR과 기존의 강력한 모델인 Faster R-CNN의 성능을 비교합니다.
결론적으로, DETR은 매우 잘 최적화된 Faster R-CNN과 **비교할 만한 성능(AP 42.0 vs 42.0)**을 달성했습니다. 특히 주목할 점은, DETR이 **큰 물체에 대해서는 훨씬 뛰어난 성능($AP_L$ 61.1 vs 53.4)**을 보인다는 것입니다. 이는 트랜스포머 인코더가 이미지 전체의 넓은 문맥을 보기 때문에 가능한 것으로 분석됩니다. 반면, 작은 물체에 대해서는 성능이 다소 낮게($AP_S$ 20.5 vs 26.6) 나타났습니다.
주요 구성 요소 분석 (Ablation Studies)
DETR의 어떤 부분이 성능에 얼마나 기여하는지 알아보기 위해 여러 실험을 진행했습니다.
인코더의 중요성 (Table 2, Figure 3):
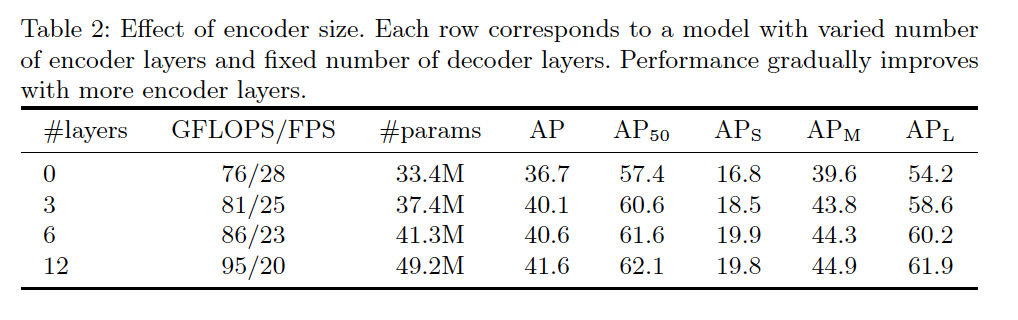 인코더 층을 제거하자 전체 성능(AP)이 약 3.9점 하락했으며, 특히 큰 물체에 대한 성능이 6.0점이나 떨어졌습니다. 이는 이미지 전체의 맥락을 이해하는 인코더가 객체들을 서로 분리하는 데 중요한 역할을 함을 시사합니다.
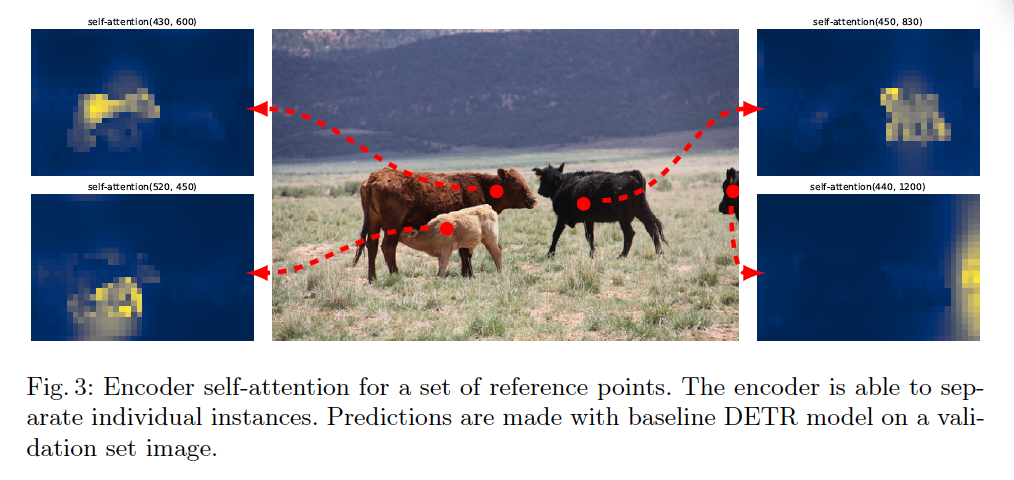 Figure 3은 인코더의 셀프 어텐션이 어떻게 동작하는지 시각화한 것입니다. 그림 중앙의 소 이미지 위에 찍힌 빨간 점이 특정 위치를 의미하고, 주변의 작은 이미지들은 해당 위치가 이미지의 다른 어떤 부분에 주목(attention)하는지를 보여줍니다. 각기 다른 소들이 서로 다른 영역으로 분리되어 주목받는 것을 볼 수 있는데, 이는 인코더가 이미 개별 인스턴스들을 분리하고 있음을 보여줍니다.
디코더의 중요성 (Figure 4):
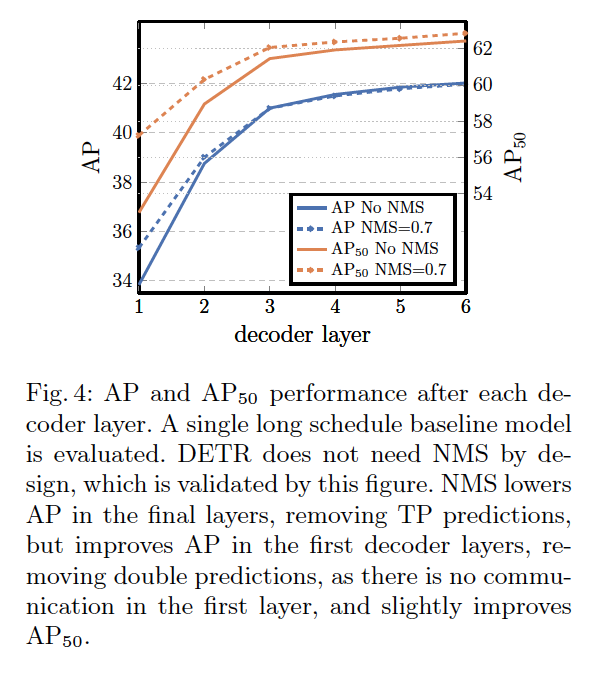 이 그래프는 디코더 층이 깊어질수록 성능(AP)이 꾸준히 향상되는 것을 보여줍니다. 첫 번째 디코더 층의 결과와 마지막 층의 결과를 비교하면 AP가 8점 이상 크게 향상되었습니다.
흥미로운 점은, 첫 번째 디코더 층에서는 NMS 후처리를 적용하면 성능이 오르지만, 층이 깊어질수록 NMS의 효과가 줄어들고 마지막에는 오히려 성능을 약간 해친다는 것입니다. 이는 디코더의 셀프 어텐션이 스스로 중복 예측을 억제하는 법을 학습하기 때문에, DETR은 설계적으로 NMS가 필요 없다는 것을 실험적으로 증명합니다.
그 외 요소들 (Table 3, 4):
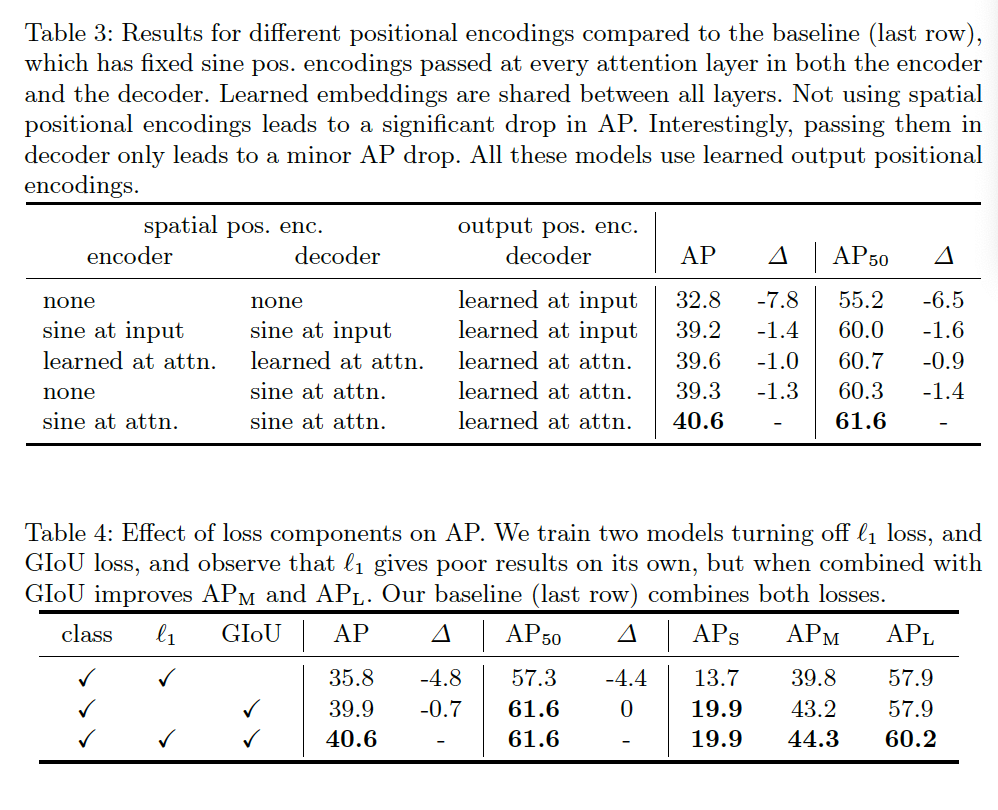
- 위치 인코딩 (Table 3): 공간적 위치 인코딩을 제거하자 성능이 7.8 AP나 하락하여, 이 요소가 매우 중요함을 확인했습니다.
- 손실 함수 (Table 4): L1 손실과 GIoU 손실 중 GIoU 손실이 성능에 거의 절대적인 기여를 하며, L1 손실은 보조적인 역할만 한다는 것을 발견했습니다.
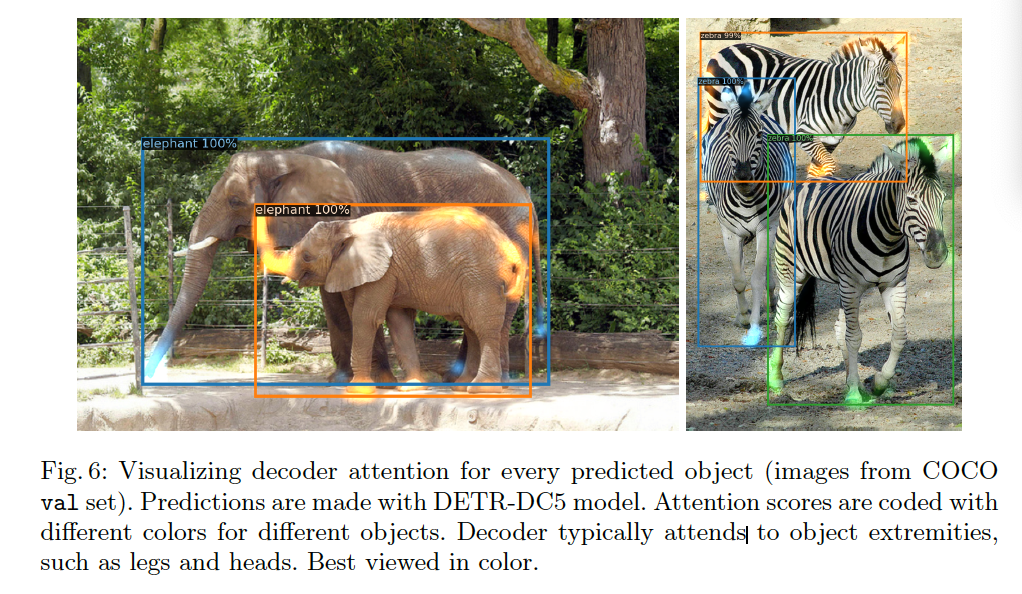 Figure 6은 디코더가 각 물체를 예측할 때 이미지의 어느 부분을 주목하는지 보여줍니다. 코끼리나 얼룩말을 탐지할 때, 주로 머리, 다리 등 물체의 **윤곽을 결정하는 극단적인 부분(extremities)**에 주목하는 경향을 보입니다. 이는 인코더가 이미 “여기에 얼룩말이 있다"고 알려주면, 디코더는 그 경계만 정확히 그리는 데 집중한다는 가설을 뒷받침합니다.
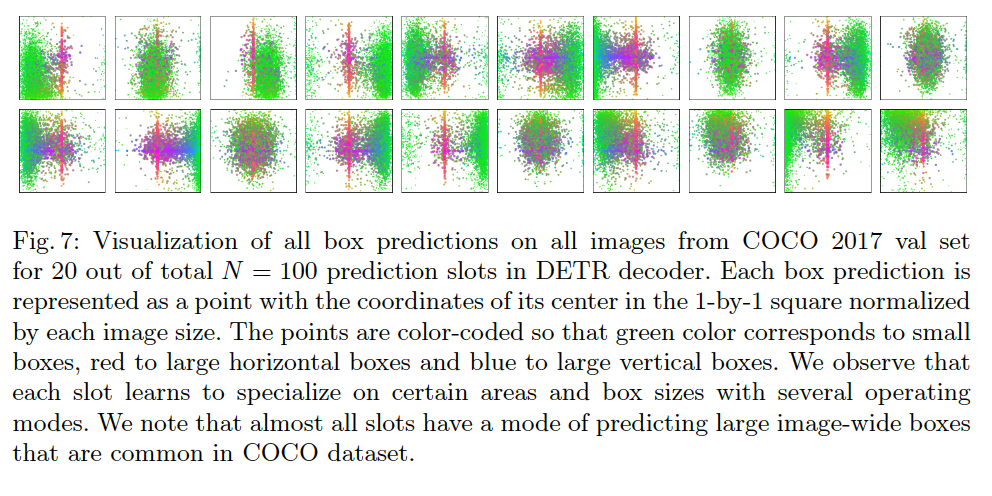 Figure 7은 100개의 객체 쿼리(슬롯)가 각각 어떤 종류의 박스를 예측하도록 학습되는지 보여줍니다. 각 슬롯은 특정 **위치(area)와 크기(box size)**를 전담하도록 특화되는 경향을 보입니다. 예를 들어 어떤 슬롯은 이미지 중앙의 큰 물체를, 다른 슬롯은 왼쪽 하단의 작은 물체를 주로 찾도록 학습됩니다.
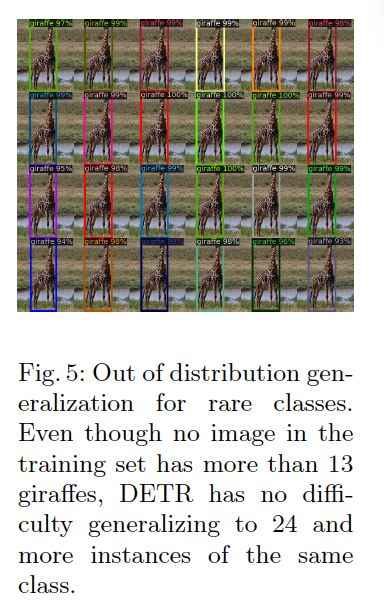 학습 데이터에는 기린이 13마리 이상 있는 이미지가 없었습니다. 이 모델이 학습 데이터에 없는 상황에서도 잘 동작하는지 알아보기 위해, 인공적으로 기린 24마리가 있는 이미지를 만들어 테스트했습니다.
Figure 5에서 볼 수 있듯이, DETR은 놀랍게도 24마리의 기린을 모두 정확하게 찾아냈습니다. 이는 100개의 객체 쿼리가 특정 클래스(예: ‘기린 전용 쿼리’)에 과적합되지 않고, 일반적인 물체를 찾는 능력을 학습했음을 보여줍니다.
Panoptic Segmentation으로의 확장
Panoptic Segmentation은 이미지의 모든 픽셀을 “어떤 물체에 속하는지(things)” 또는 “어떤 배경에 속하는지(stuff)“로 구분하는 더 복잡한 작업입니다.
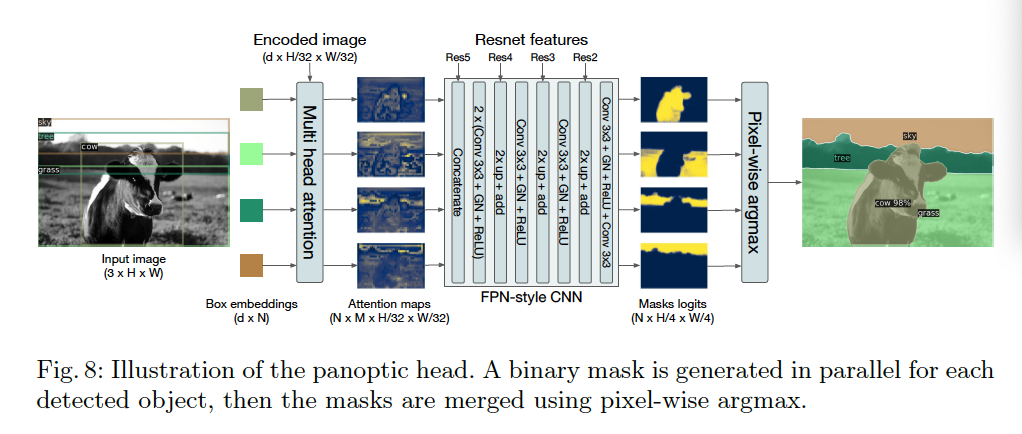 Figure 8은 DETR에 간단한 **마스크 헤드(mask head)**를 추가하여 이 작업을 수행하는 방법을 보여줍니다. 디코더의 출력 각각에 대해 해당 물체의 마스크를 예측하고, 이를 합쳐 최종 결과를 만듭니다.
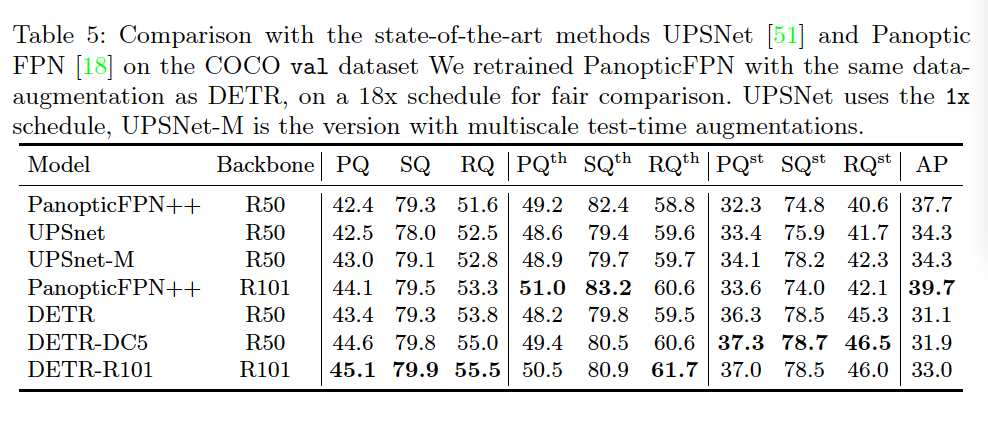 Table 5는 DETR이 PanopticFPN과 같은 기존의 강력한 모델들을 능가하는 성능을 보였음을 나타냅니다. 특히 배경(stuff) 클래스에서 강점을 보이는데, 이는 이미지 전체를 보는 인코더의 힘 덕분일 가능성이 높습니다.
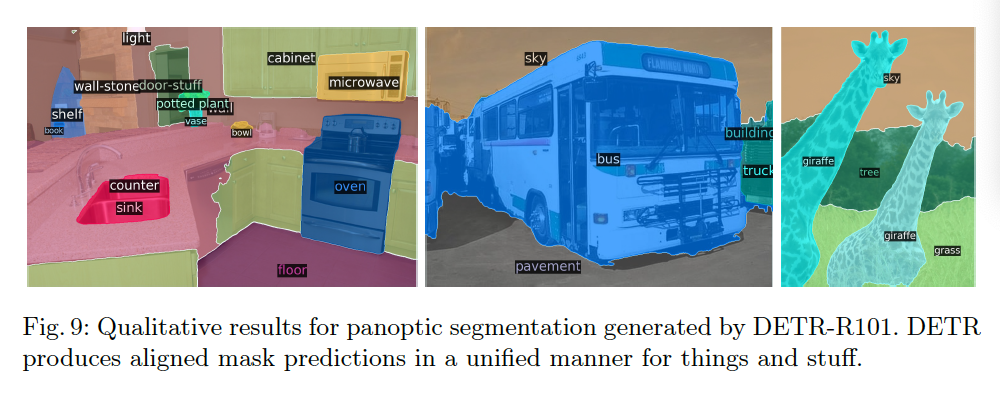 Figure 9는 DETR이 생성한 Panoptic Segmentation의 예시 이미지로, 물체와 배경 모두에 대해 깔끔한 결과를 보여줍니다.
4. 결론 (Conclusion)
이 논문은 트랜스포머와 이분 매칭 손실을 기반으로 객체 탐지를 **‘직접적인 집합 예측 문제’**로 풀어내는 새로운 패러다임인 DETR을 제시했습니다. DETR은 기존의 복잡한 파이프라인(앵커, NMS 등)을 제거하면서도, 고도로 최적화된 Faster R-CNN과 대등한 성능을 달성했습니다.
또한, DETR의 구조는 매우 간단하고 유연하여 Panoptic Segmentation과 같은 더 복잡한 문제로도 쉽게 확장될 수 있음을 보여주었습니다. 특히 이미지의 전역적인 정보를 활용하는 능력 덕분에 큰 객체 탐지에서 뛰어난 성능을 보였습니다.